Robot thư viện cần đi từ cửa tới bàn trả sách. Nếu biết bản đồ thì dùng BFS. Nhưng nếu robot không có bản đồ, mỗi lần chỉ được đi một bước, nhìn xem mình tới đâu và nhận một điểm thưởng, thì phải học dần từ các lần thử. Đó là reinforcement learning (học tăng cường). Khó khăn chính là điểm thưởng thường chỉ có khi tới đích, nên phải tìm cách đánh giá cả những bước còn ở xa đích. Bài này học Q-learning và policy gradient trên các bài toán nhỏ.
Từ hành động tới một vòng tương tác
Ở thời điểm , agent nhìn trạng thái , chọn hành động . Environment thực hiện hành động và trả về phần thưởng cùng trạng thái . Chỉ số nhắc rằng phần thưởng là kết quả sau hành động; nó không phải nhãn đúng của hành động được đưa sẵn trước khi chọn.
Học từ thưởng qua tương tác như vậy là học tăng cường (reinforcement learning): chương trình tự chơi game, được cộng điểm khi thắng, hay hệ thống điều khiển đèn giao thông để xe chạy thông suốt.
Một policy, ký hiệu , cho xác suất chọn hành động khi ở trạng thái . Policy có thể tất định, như luôn đi phải ở một ô; cũng có thể ngẫu nhiên, như đi phải với xác suất . Phần thưởng nói mục tiêu cần đạt, còn policy nói cách thực hiện. Ta thường chưa biết hành động tốt nhất để đưa làm nhãn huấn luyện.
Muốn vị trí ô đủ mô tả trạng thái, kết quả bước tiếp theo chỉ được phụ thuộc vào vị trí và hành động hiện tại, không cần toàn bộ lịch sử. Đó là tính Markov.
Nếu robot còn pin và pin ảnh hưởng khả năng di chuyển, phải thêm mức pin vào trạng thái. Nếu nhiệm vụ bắt buộc kết thúc sau đúng 20 lượt, thời gian còn lại cũng có thể ảnh hưởng quyết định và phải được biểu diễn. Bỏ một biến cần thiết khiến cùng một “trạng thái” có hai cách diễn biến khác nhau.
Hỏi nhanh
Robot chỉ ghi lại vị trí ô. Khi pin yếu, lệnh “tiến” có lúc không làm robot di chuyển. Nên sửa mô tả trạng thái thế nào?
Hai robot cùng ô nhưng pin khác nhau cho kết quả khác nhau với cùng một hành động, nên vị trí chưa đủ để có tính Markov. Thêm mức pin là sửa đúng chỗ còn thiếu. Chuỗi ô đã đi chỉ gợi ý gián tiếp lượng pin đã tiêu, mà làm số trạng thái phình lên rất nhanh. Đổi seed hay thêm episode không thay đổi được việc cùng một “trạng thái” có hai cách diễn biến. Agent khi ấy chỉ học được trung bình của hai trường hợp.
Đặt một MDP đủ nhỏ để kiểm bằng tay
Markov decision process (MDP) gồm tập trạng thái , tập hành động , quy luật chuyển và thưởng , cùng hệ số chiết khấu . Ta dùng lưới 3 hàng, 4 cột; tọa độ viết (hàng, cột), bắt đầu từ 0 ở góc trên trái. Robot xuất phát ở , đích ở , ô bị chắn. Mỗi ô còn lại là một trạng thái, nên có 11 trạng thái.
Bốn hành động là lên, xuống, trái, phải. Va tường hoặc đi ra ngoài lưới thì giữ nguyên vị trí. Mỗi bước chưa vào đích nhận điểm; bước vào đích nhận điểm và kết thúc episode, tức một lần thực hiện nhiệm vụ. Đích không còn hành động cần học.
Chuyển trạng thái ở đây tất định; xác suất của kết quả đúng bằng 1. Trong môi trường có trượt chân, cùng một hành động có thể dẫn tới nhiều kết quả và ta phải lấy kỳ vọng theo .
Ta cài environment trước, rồi kiểm hai trường hợp dễ nhầm: va ô chắn và vào đích. Toàn bộ code trong bài chạy nối tiếp; chỉ cần NumPy.
import numpy as np

states = [(r, c) for r in range(3) for c in range(4) if (r, c) != (1, 1)]
state_id = {cell: i for i, cell in enumerate(states)}
start, goal = state_id[(2, 0)], state_id[(0, 3)]
moves = [(-1, 0), (1, 0), (0, -1), (0, 1)]
action_names = ["U", "D", "L", "R"]
gamma = 0.9

def step(state, action):
    assert state != goal, "Không bước tiếp sau khi đã tới đích."
    row, col = states[state]
    dr, dc = moves[action]
    next_cell = (row + dr, col + dc)
    next_state = state_id.get(next_cell, state)
    terminated = next_state == goal
    reward = 10.0 if terminated else -1.0
    return next_state, reward, terminated

wall_step = step(state_id[(1, 0)], 3)
goal_step = step(state_id[(0, 2)], 3)
assert wall_step == (state_id[(1, 0)], -1.0, False)
assert goal_step == (goal, 10.0, True)
print("Số trạng thái:", len(states))
print("Va ô chắn:", states[wall_step[0]], wall_step[1:])
print("Vào đích:", states[goal_step[0]], goal_step[1:])
Số trạng thái: 11
Va ô chắn: (1, 0) (-1.0, False)
Vào đích: (0, 3) (10.0, True)
Dòng va ô chắn phải giữ vị trí cũ và vẫn trừ một điểm. Dòng vào đích phải có True; nếu quên điều kiện ấy, robot có thể tiếp tục thu thưởng hoặc bị phạt sau khi nhiệm vụ đã xong.
Hỏi nhanh
Đổi luật chơi: robot có hướng nhìn là N, E, S hoặc W, và chỉ còn ba hành động là quay trái, quay phải, và tiến một ô theo hướng đang nhìn. Trên lưới của bài, MDP mới có bao nhiêu trạng thái và bao nhiêu hành động?
Kết quả của lệnh tiến phụ thuộc hướng đang nhìn, nên hướng phải nằm trong trạng thái: 11 ô nhân 4 hướng, tức . Ô bị chắn không phải trạng thái, nên không phải . Hướng là một phần của trạng thái chứ không phải hành động, và tập hành động chỉ có ba lệnh. Giữ 11 trạng thái thì cùng một “trạng thái” có bốn kết quả khác nhau cho lệnh tiến.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.1
Vì sao nhìn thưởng một bước chưa đủ?
Một bước xa đích chỉ có thưởng , dù nó mở đường tới bàn trả sách. Ta cần đánh giá phần thưởng tương lai. Với episode kết thúc sau hành động, return từ thời điểm là
làm một điểm ở bước kế tiếp chỉ còn giá trị khi nhìn từ hiện tại. Nó không phải xác suất thành công, cũng không phải learning rate. Với bài tiếp diễn vô hạn, thưởng bị chặn và giúp tổng hội tụ; một episode hữu hạn có thể dùng nếu mục tiêu là tổng thưởng không chiết khấu.
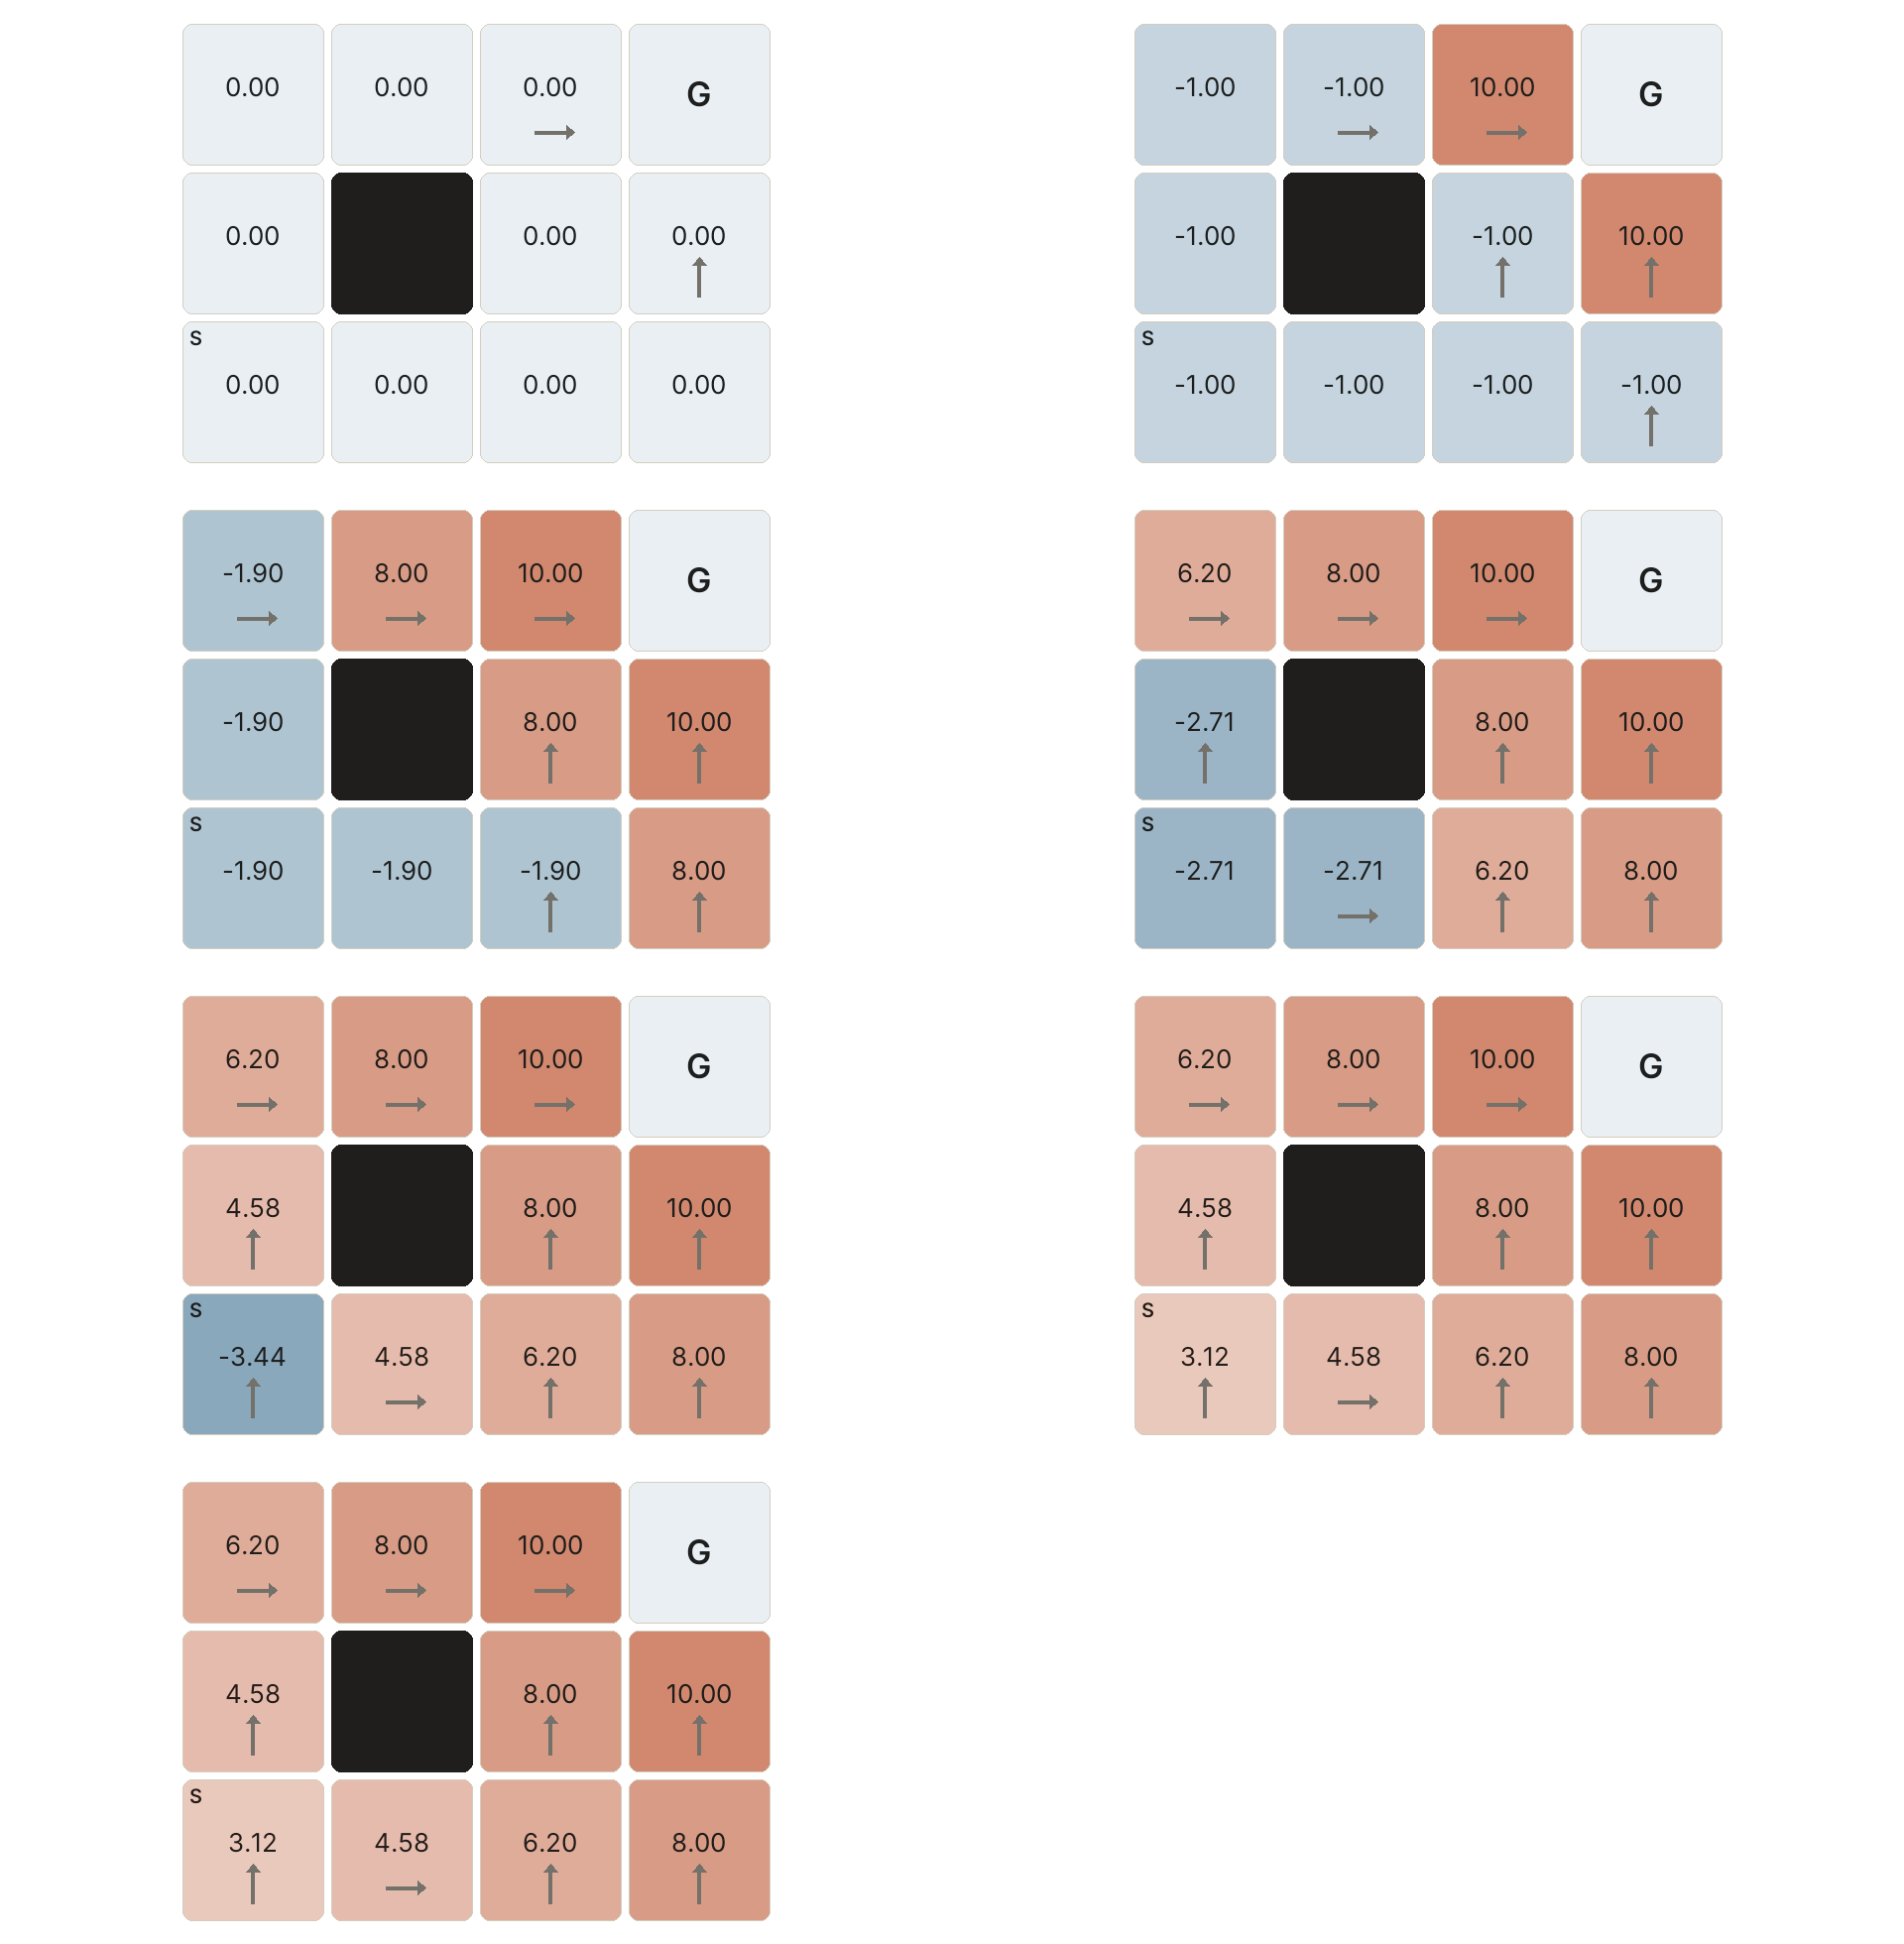
Đường 5 hành động trong hình có chuỗi thưởng . Vì thưởng cuối đến sau bốn lần chiết khấu,
Tổng không chiết khấu là . Hai số đo hai mục tiêu khác nhau, đều có đơn vị điểm thưởng. Đừng đọc 3.122 thành số bước.
rewards = np.array([-1, -1, -1, -1, 10], dtype=float)
return_hand = float(np.sum(rewards * gamma ** np.arange(len(rewards))))
print(f"Tổng thưởng: {rewards.sum():.3f}")
print(f"Return chiết khấu: {return_hand:.3f}")
assert np.isclose(return_hand, 3.122)
Tổng thưởng: 6.000
Return chiết khấu: 3.122
Phần thưởng và cùng quyết định thế nào là “tốt nhất”. Ở lưới này, mỗi bước chưa tới đích bị trừ 1 nên đường dài mất thêm điểm; còn làm thưởng 10 đến muộn có giá trị nhỏ hơn. Cả hai cơ chế đều đẩy robot đi đường ngắn. Ngược lại, cộng thưởng dương cho mỗi bước có thể khiến robot muốn kéo dài episode. Thiết kế thưởng là một phần của đề bài, không phải chi tiết cài đặt.
Hỏi nhanh
Một bước đi vào terminal nhận thưởng 10. Return tính từ ngay trước bước đó bằng bao nhiêu?
Giá trị tương lai sau terminal bằng 0, nhưng phần thưởng của chính bước kết thúc vẫn được giữ, với hệ số 1, vì nó là . chỉ nhân những thưởng đến sau đó. Sau terminal không còn bước nào, nên không có nào để cộng thêm.
Hỏi nhanh
Đổi thiết kế: vào đích nhận 10, mọi bước khác nhận 0, và . Policy nào là tối ưu?
Mọi đường tới đích có cùng return là 10. Không có phạt mỗi bước, cũng không có chiết khấu, thì đi 5 bước hay 50 bước đều như nhau. Đứng yên mãi chỉ được , nên không tối ưu. Đường ngắn chỉ thắng hẳn khi có hoặc có phạt mỗi bước, như thiết kế gốc của bài.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.8
Bellman: tính việc xa bằng việc gần
là kỳ vọng return khi bắt đầu ở và làm theo policy . Còn là kỳ vọng khi bắt đầu bằng hành động , sau đó làm theo . Kỳ vọng cần thiết vì cả policy và environment có thể ngẫu nhiên. là giá trị tốt nhất có thể đạt.
Trong lưới tất định này, Bellman optimality viết thành
Với chuyển ngẫu nhiên, thay biểu thức trong ngoặc bằng . Dấu max chọn hành động tốt nhất; dấu tổng tính kỳ vọng kết quả của một hành động. Hai thao tác có vai trò khác nhau.
Với một policy cố định, bỏ max và lấy trung bình theo chính policy đó:
Đây là hệ phương trình tuyến tính với ẩn là các . Khi đồ thị có vòng, các ẩn phụ thuộc lẫn nhau, nên phải giải cả hệ hoặc lặp đến khi hội tụ.
Từ đích đi ngược: ô cách một bước có giá trị ; cách hai bước có ; cách ba bước có , rồi , rồi . Giống dynamic programming, giá trị của bài toán lớn được viết qua bài toán nhỏ. Nhưng có vòng trong đồ thị nên không có thứ tự nào tính một lần là xong; ta lặp cập nhật trên mọi trạng thái, gọi là value iteration. Bắt đầu từ , mỗi vòng đưa thông tin từ đích lùi thêm một bước.
Một vòng xét mọi trạng thái, mọi hành động và mọi trạng thái kế tiếp có thể: lưu thành bảng đầy đủ thì tốn , còn lưới tất định chỉ có một trạng thái kế tiếp nên mỗi vòng là .
V = np.zeros(len(states))
for _ in range(200):
    old_V = V.copy()                # cập nhật đồng bộ từ vòng trước
    for state in range(len(states)):
        if state == goal:
            continue
        candidates = []
        for action in range(4):
            next_state, reward, terminated = step(state, action)
            future = 0.0 if terminated else old_V[next_state]
            candidates.append(reward + gamma * future)
        V[state] = max(candidates)
    if np.max(np.abs(V - old_V)) < 1e-12:
        break

print(f"Value iteration tại S: {V[start]:.3f}")
print(f"Giá trị terminal: {V[goal]:.3f}")
assert np.isclose(V[start], return_hand)
Value iteration tại S: 3.122
Giá trị terminal: 0.000
Value iteration gọi step cho mọi cặp trạng thái–hành động tùy ý, tức dùng mô hình của environment: đây là planning với mô hình đã biết, chưa phải học từ trải nghiệm robot tự thu được. Đáp án của nó là mốc để kiểm phần học tiếp theo. Khi biết bản đồ và chỉ cần đường ngắn nhất, dùng BFS trực tiếp thường hợp lý hơn huấn luyện một agent.
Hỏi nhanh
Chạy value iteration đồng bộ trên lưới của bài, bắt đầu từ . Sau đúng 2 vòng, giá trị tại S bằng bao nhiêu?
Ở vòng 1, mọi ô không kề đích chỉ thấy . Ở vòng 2, các ô cạnh S đều đang là , nên S được . là kết quả sau một vòng. chỉ xuất hiện từ vòng 5, khi thưởng ở đích đã lan về S qua đủ 5 bước. Ô cách đích 2 bước thì sau vòng 2 đã đúng bằng 8.
Q-learning: cập nhật từ một trải nghiệm
Bây giờ agent chỉ gọi step cho hành động đã chọn. Nó lưu bảng shape (11, 4); mỗi hàng là một ô, mỗi cột là một hành động. Sau quan sát , target là . Sai lệch giữa target và giá trị hiện tại gọi là TD error (sai lệch thời gian). Ta cập nhật
là learning rate. Viết cách khác, : ghi đè bằng target mới nhất, nhỏ giữ lại phần lớn giá trị cũ và lấy trung bình có trọng số các target đã gặp. Nếu bước vừa đi kết thúc episode (terminal), target chỉ còn .
Ví dụ , , giá trị tốt nhất ở trạng thái kế tiếp là 5, , : target là , TD error là , giá trị mới là . Nếu đó là bước terminal thưởng 10 thì giá trị mới là .
Hỏi nhanh
Đề chỉ cấp env.reset() và env.step(a), trả về trạng thái mới, phần thưởng và cờ kết thúc. Không có bảng chuyển, cũng không có bản đồ. Cách nào chạy được ngay?
Q-learning chỉ cần các bộ thu được khi tương tác. Value iteration cần cho mọi cặp. Coi đều nhau là giải một MDP khác hẳn. DP theo thứ tự topo cần biết đồ thị và đồ thị phải không có vòng, trong khi ở đây chưa biết đồ thị và lưới lại có vòng. Một hướng khác là ghi lại các transition để ước lượng mô hình, rồi mới lập kế hoạch.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q5.1(iv)
Policy lấy hành động có lớn nhất có thể bỏ lỡ hướng chưa thử. Ta dùng epsilon-greedy: xác suất chọn đều trong cả bốn hành động, còn lại chọn một hành động đạt cực đại. Hành động tốt nhất cũng có thể được chọn trong nhánh ngẫu nhiên.
Việc thử hướng mới này gọi là khám phá (exploration), để thu thông tin về environment. Nó khác với tìm kiếm (search) ở bài 9.2, nơi trạng thái được mở rộng bằng quy tắc đã biết.
def td_target(reward, next_values, terminated):
    if terminated:
        return reward
    return reward + gamma * np.max(next_values)

assert np.isclose(td_target(-1.0, np.array([5.0, 2.0]), False), 3.5)
# Giá trị cố ý sai ở terminal cũng không được lọt vào target.
assert td_target(10.0, np.full(4, 999.0), True) == 10.0

rng = np.random.default_rng(7)
Q = np.zeros((len(states), 4))
alpha, epsilon = 0.3, 0.2
for episode in range(3000):
    state = start
    for turn in range(100):
        if rng.random() < epsilon:
            action = int(rng.integers(4))
        else:
            best = np.flatnonzero(Q[state] == Q[state].max())
            action = int(rng.choice(best))
        next_state, reward, terminated = step(state, action)
        target = td_target(reward, Q[next_state], terminated)
        Q[state, action] += alpha * (target - Q[state, action])
        state = next_state
        if terminated:
            break

print("Shape bảng Q:", Q.shape)
print(f"Q tốt nhất tại S: {Q[start].max():.3f}")
assert np.all(Q[goal] == 0)
Shape bảng Q: (11, 4)
Q tốt nhất tại S: 3.122
Giới hạn 100 lượt trong code là dừng thu mẫu để chương trình luôn chạy nhanh, không phải terminal của MDP. Ở lượt bị dừng ấy, ta vẫn dùng target có giá trị tương lai, rồi reset để thu một episode mới. Gymnasium trả riêng hai cờ terminated và truncated; chỉ terminal thật làm mất bootstrap.
Hỏi nhanh
Epsilon-greedy có 4 hành động, đúng một hành động tốt nhất, , và nhánh explore chọn đều cả 4 hành động. Xác suất chọn hành động tốt nhất là bao nhiêu?
Nhánh khai thác góp . Nhánh explore góp thêm , vì chọn đều thì vẫn có thể rơi đúng vào hành động tốt nhất. là quên phần đóng góp ấy. chỉ là phần của nhánh explore. là xác suất rơi vào nhánh explore. Nếu explore chỉ chọn trong 3 hành động còn lại thì đáp án mới là .
Mỗi cập nhật chỉ nhìn trước một bước, nên tin tốt ở đích lan ngược về S chậm. Với và khởi tạo 0, trong episode đầu tiên tới đích chỉ cặp trạng thái–hành động cuối cùng nhận target có thưởng 10; các cặp trước đó đã được cập nhật khi giá trị phía sau còn bằng 0. Mỗi lần đi lại cùng đường, thông tin lùi thêm một bước.
Experience replay lưu các transition đã gặp vào bộ nhớ rồi cập nhật lại nhiều lần, nhờ đó dùng mỗi lần tương tác hiệu quả hơn; đây cũng là một thành phần của DQN, Q-learning với mạng neural.
Hỏi nhanh
Episode đầu tiên đi 5 transition từ S tới đích, và tất cả đều được lưu lại. Q-learning với , khởi tạo bằng 0. Phát lại 5 transition này theo thứ tự nào để tại S đạt chỉ sau một lượt quét?
Cập nhật ngược thì mỗi cặp dùng giá trị phía sau vừa được tính: , rồi , , và . Đi xuôi thì lặp lại đúng tình trạng của episode đầu: mọi cặp trước đích chỉ thấy giá trị 0 ở phía sau. Lặp transition cuối không đưa thông tin gì về các ô khác. Xáo trộn có ích khi train mạng, để giảm tương quan giữa các mẫu, nhưng không bảo đảm thưởng lan hết trong một lượt.
Đọc policy, không chỉ đọc một ô Q
Con số ở S gần đáp án chuẩn chưa chứng minh robot đi được. Ta tắt exploration, chạy policy greedy và in cả đường đi. Evaluation không cập nhật ; tránh việc kiểm tra cũng làm thay đổi agent.
state = start
path = [states[state]]
actions_taken, observed_rewards = [], []
for _ in range(30):
    action = int(np.argmax(Q[state]))
    state, reward, terminated = step(state, action)
    actions_taken.append(action_names[action])
    observed_rewards.append(reward)
    path.append(states[state])
    if terminated:
        break

discounted = sum(gamma ** t * r for t, r in enumerate(observed_rewards))
print("Hành động:", " ".join(actions_taken))
print("Đường đi:", path)
print(
    f"Số bước: {len(actions_taken)}, "
    f"return: {discounted:.3f}"
)
assert state == goal and len(actions_taken) == 5
assert np.isclose(discounted, V[start])
Hành động: R R U U R
Đường đi: [(2, 0), (2, 1), (2, 2), (1, 2), (0, 2), (0, 3)]
Số bước: 5, return: 3.122
Nhìn Số bước trước: đường ngắn nhất từ S dài 5 bước (đếm trên hình hoặc bằng BFS), nên từ S agent đã đạt mức tối ưu. Lưới có nhiều đường ngắn nhất, vì vậy chuỗi hành động có thể khác mũi tên trong hình mà return vẫn là 3.122. Một đường đi chỉ kiểm policy tại S; muốn kiểm cả policy, chạy evaluation từ mọi ô và so với của value iteration.
Định lý hội tụ của Q-learning dạng bảng cần mọi cặp trạng thái–hành động được thử vô số lần và learning rate giảm dần thích hợp. Ở lưới tất định của bài, cố định đã cho đúng kết quả; khi chuyển trạng thái ngẫu nhiên, cố định khiến luôn dao động theo các mẫu gần nhất.
Hỏi nhanh
Một bảng Q mới học 20 episode. Đánh giá greedy từ S cho đường cho đến hết 30 lượt mà không tới đích. Ta kết luận gì, và nên làm gì?
Policy greedy theo một bảng Q chưa hội tụ có thể đi vòng, và giới hạn 30 lượt trong phần đánh giá tồn tại chính vì vậy. Bật là đo một policy khác, không phải policy sẽ nộp. Không tới đích thì vẫn có return: 30 bước cho , một con số tệ đáng ghi lại. Trước khi nghi ngờ environment, hãy so với value iteration như khối code phía trên.
SARSA, Monte Carlo và TD
Target của Q-learning lấy , giá trị của hành động tốt nhất ở , dù lúc chạy epsilon-greedy có thể chọn hành động khác. Agent hành động theo một policy (epsilon-greedy) nhưng học giá trị của một policy khác (greedy). Kiểu học này gọi là off-policy.
SARSA chọn trước hành động kế tiếp bằng chính policy đang chạy, rồi đưa nó vào target:
Tên gọi lấy từ năm thứ cần cho một lần cập nhật: . Target dùng hành động thật sự được chọn, kể cả bước khám phá, nên SARSA học giá trị của chính policy đang chạy. Kiểu học này gọi là on-policy.
Ví dụ: , ở hai hành động có là 6 và 2, policy chọn hành động có , . Target của Q-learning là , của SARSA là .
Khác biệt hiện rõ trên lưới vách đá (cliff walking): 4 hàng, 12 cột, xuất phát ở góc dưới trái, đích ở góc dưới phải, mười ô giữa hàng dưới là vách. Mỗi bước nhận ; bước vào vách nhận và bị đưa về ô xuất phát. Cả hai thuật toán học 500 episode với , , , cùng seed.
CLIFF_ROWS, CLIFF_COLS = 4, 12
CLIFF_START, CLIFF_GOAL = (3, 0), (3, 11)
CLIFF = {(3, c) for c in range(1, 11)}

def cliff_step(cell, action):
    r, c = cell
    dr, dc = moves[action]
    nxt = (min(max(r + dr, 0), CLIFF_ROWS - 1), min(max(c + dc, 0), CLIFF_COLS - 1))
    if nxt in CLIFF:
        return CLIFF_START, -100.0, False
    return nxt, -1.0, nxt == CLIFF_GOAL

def egreedy(values, gen, eps):
    if gen.random() < eps:
        return int(gen.integers(4))
    return int(gen.choice(np.flatnonzero(values == values.max())))

def train_cliff(method, episodes=500, alpha=0.1, eps=0.1, seed=0):
    gen = np.random.default_rng(seed)
    Qc = np.zeros((CLIFF_ROWS, CLIFF_COLS, 4))
    returns = []
    for _ in range(episodes):
        cell, total = CLIFF_START, 0.0
        action = egreedy(Qc[cell], gen, eps)
        for _ in range(500):
            nxt, reward, done = cliff_step(cell, action)
            total += reward
            next_action = egreedy(Qc[nxt], gen, eps)
            if done:
                target = reward
            elif method == "SARSA":
                target = reward + Qc[nxt][next_action]   # hành động sẽ làm thật
            else:
                target = reward + Qc[nxt].max()          # hành động tốt nhất
            Qc[cell][action] += alpha * (target - Qc[cell][action])
            cell, action = nxt, next_action
            if done:
                break
        returns.append(total)
    return Qc, returns

def cliff_greedy(Qc):
    cell, path = CLIFF_START, [CLIFF_START]
    for _ in range(60):
        cell, _, done = cliff_step(cell, int(np.argmax(Qc[cell])))
        path.append(cell)
        if done:
            break
    return path

for method in ["Q-learning", "SARSA"]:
    Qc, returns = train_cliff(method)
    path = cliff_greedy(Qc)
    rows_used = sorted({r for r, _ in path[1:-1]})
    print(f"{method:10s} greedy {len(path) - 1} bước, qua hàng {rows_used}; "
          f"return lúc học (100 episode cuối): {np.mean(returns[-100:]):.1f}")
Q-learning greedy 13 bước, qua hàng [2]; return lúc học (100 episode cuối): -64.8
SARSA greedy 15 bước, qua hàng [1, 2]; return lúc học (100 episode cuối): -25.1
Q-learning học đường ngắn nhất, 13 bước, sát ngay trên vách. Đó là đường tốt nhất cho policy greedy. Nhưng lúc học, cứ khoảng 10 bước lại có một bước ngẫu nhiên, và đứng sát vách thì một bước xuống là mất 100 điểm: return trung bình khi học chỉ . SARSA tính cả những bước ngẫu nhiên ấy vào giá trị, nên học đường cách vách thêm một hàng, dài 15 bước, và khi học đạt .
Cần điểm tốt ngay trong lúc còn khám phá, như robot thật không được phép ngã, thì chọn SARSA. Chỉ cần policy greedy cuối cùng tốt nhất thì Q-learning cho đường ngắn hơn. Khi giảm dần về 0, cả hai cùng tiến về đường tối ưu.
Hỏi nhanh
Sau khi học xong, tắt khám phá () và cho cả hai policy greedy đi từ ô xuất phát. Return của Q-learning và của SARSA lần lượt là bao nhiêu?
Không còn bước ngẫu nhiên thì không ai rơi xuống vách, mỗi bước chỉ mất 1 điểm: Q-learning đi 13 bước, SARSA đi 15 bước. và là return trung bình lúc còn . Lúc chạy greedy, đường sát vách của Q-learning lại tốt hơn.
Q-learning và SARSA đều cập nhật ngay sau một bước, dựa vào giá trị đang ước lượng ở bước kế (bootstrapping). Đó là học temporal difference (TD). Dạng TD cho là
Monte Carlo làm khác: chạy hết episode, tính return thật cho từng trạng thái đã đi qua, rồi lấy trung bình các của mỗi trạng thái làm . Nó không dựa vào ước lượng nào, nên giá trị khởi tạo sai không làm lệch kết quả. Đổi lại, nó phải chờ episode kết thúc, và cộng nhiều bước ngẫu nhiên nên dao động mạnh. TD cập nhật được ngay, dùng được cả cho bài không có điểm kết thúc, nhưng target phụ thuộc vào chính giá trị đang học.
Hỏi nhanh
Bài toán điều khiển đèn giao thông chạy liên tục, không có lúc kết thúc. Cách học giá trị nào dùng được?
Monte Carlo cần , mà bài không kết thúc thì không bao giờ có đầy đủ. TD chỉ cần một bước rồi bootstrap từ , nên chạy được trên dòng tương tác vô hạn, với để tổng hội tụ. Nếu muốn dùng Monte Carlo, phải tự cắt dòng thời gian thành từng đoạn.
Policy gradient: học trực tiếp xác suất hành động
Q-learning học bảng giá trị rồi suy ra policy. Một cách khác là đặt tham số cho policy và tăng kỳ vọng return. Để thấy đúng phép toán, ta tạm dùng nhiệm vụ một bước: chọn trái nhận 1 điểm, chọn phải nhận 3 điểm, rồi episode kết thúc. Đây là một bandit, trường hợp đơn giản nhất của tương tác có thưởng; nó không minh họa khó khăn gán công lao qua nhiều bước.
Đặt xác suất đi phải . Kỳ vọng thưởng là . Do ,
Tại , , gradient bằng . Gradient ascent với cho , tăng xác suất phải lên khoảng . Dấu cộng khác với gradient descent của loss vì ta muốn tăng thưởng.
Nếu chưa biết thưởng của cả hai hướng, một mẫu REINFORCE dùng để ước lượng gradient. là baseline không phụ thuộc vào hành động đang chọn.
Với và xác suất phải là , đạo hàm log-policy là . Lấy : chọn phải cho ; chọn trái cho . Kỳ vọng hai trường hợp đúng bằng .
Ta kiểm tính tay trước, rồi dùng 400 mẫu để cập nhật policy.
def sigmoid(theta):
    return 1.0 / (1.0 + np.exp(-theta))

p0 = sigmoid(0.0)
theta_hand = 0.1 * 2 * p0 * (1 - p0)
print(f"Một bước exact gradient: theta={theta_hand:.4f}, p={sigmoid(theta_hand):.4f}")

rng_policy = np.random.default_rng(11)
theta_policy = 0.0
for _ in range(400):
    probability = sigmoid(theta_policy)
    action = int(rng_policy.random() < probability)
    reward = 3.0 if action else 1.0
    sample_gradient = (reward - 2.0) * (action - probability)
    theta_policy += 0.05 * sample_gradient

p_final = sigmoid(theta_policy)
print(f"Policy sau 400 mẫu: p(phải)={p_final:.4f}, E[R]={1 + 2 * p_final:.4f}")
assert p_final > 0.9
Một bước exact gradient: theta=0.0500, p=0.5125
Policy sau 400 mẫu: p(phải)=0.9641, E[R]=2.9282
E[R] ở dòng cuối tính bằng công thức của bài toán, không phải trung bình các thưởng đã nhận khi huấn luyện. Sau 400 mẫu, mới tới khoảng vì kỳ vọng gradient nhỏ dần khi gần 1: policy càng chắc chắn thì càng học chậm.
Trong môi trường lớn, policy là một mạng neural nhận trạng thái và trả xác suất hành động; ít tham số hơn một bảng khổng lồ, nhưng không còn đáp án chính xác để đối chiếu.
Với episode nhiều bước, mỗi thời điểm dùng return tính từ chính thời điểm đó:
Hành động ở bước không ảnh hưởng tới các thưởng đã nhận trước nó, nên dùng thay cho tổng thưởng cả episode.
Baseline không làm lệch kỳ vọng, vì , nhưng làm các mẫu bớt dao động; lựa chọn thường gặp là một ước lượng của .
Nếu thay bằng , với do một mạng thứ hai học, ta được actor-critic: actor là policy, critic là hàm giá trị.
Hỏi nhanh
Ta muốn cực đại hóa kỳ vọng thưởng , và đã có gradient bằng . Dòng cập nhật nào đúng?
Gradient chỉ hướng làm tăng nhanh nhất, nên phải đi theo nó, tức gradient ascent. Dấu trừ dành cho việc cực tiểu hóa loss. Có thể đặt loss bằng để dùng optimizer kiểu descent, nhưng phải giữ dấu nhất quán. abs làm mất thông tin về hướng: khi nó vẫn tăng . Gán thẳng theta = lr * gradient là quên mất giá trị hiện tại.
Hỏi nhanh
Bandit của bài, với nên , và baseline . Mẫu vừa rút chọn trái và nhận 1 điểm. Sau một cập nhật REINFORCE như trong code, xác suất chọn phải thay đổi thế nào?
, nên tăng, và xác suất chọn phải tăng. Không có baseline thì thưởng dương 1 sẽ đẩy xác suất chọn trái lên, dù trái là lựa chọn kém hơn. Baseline biến tín hiệu thành “tốt hơn hay kém hơn mức thường gặp”. Chỉ nhìn dấu của là quên dấu của .
Khi đi thi
- Đề cho đủ quy tắc chuyển trạng thái thì dùng BFS, DP hay value iteration, không cần học từ tương tác.
- Kiểm
stepbằng tay trước khi train: va tường, vào đích, hết lượt. - Đánh giá agent bằng policy greedy trên nhiều episode, không bằng thưởng lúc đang khám phá.
Tóm tắt
- MDP làm rõ trạng thái, hành động, quy luật chuyển và thưởng; trạng thái phải giữ các biến cần cho bước tiếp theo. Thưởng và quyết định thế nào là tối ưu.
- Return cộng thưởng tương lai với hệ số chiết khấu. Terminal có giá trị tương lai 0 nhưng không xóa thưởng của bước kết thúc; bước bị cắt vì hết lượt vẫn bootstrap.
- Bellman nối giá trị hiện tại với giá trị tương lai. Value iteration dùng mô hình và lan thông tin một bước mỗi vòng; Q-learning cập nhật từ từng transition, có thể tăng tốc bằng replay.
- Q-learning là off-policy, target lấy ; SARSA là on-policy, target dùng hành động thật sự chọn, nên tránh xa chỗ nguy hiểm khi còn khám phá. TD cập nhật sau từng bước bằng bootstrap; Monte Carlo chờ hết episode để có return thật.
- Exploration thu thêm thông tin; evaluation greedy đo policy đã học. Policy gradient tăng kỳ vọng thưởng bằng cách chỉnh xác suất hành động; baseline giảm dao động mà không đổi kỳ vọng.
Kiểm tra cuối bài
Câu 1
Bốn đội mô tả bài toán cờ của mình. Bài nào là reinforcement learning?
Tự chơi, chọn nước đi, rồi chỉ nhận thưởng hoặc phạt là thắng hay thua ở cuối ván, đúng khung agent, environment và reward. Khó khăn chính là gán công lao cho những nước đi trước đó. Bắt chước kiện tướng là học có giám sát, vì mỗi thế cờ đã có sẵn “nhãn đúng”, dù dữ liệu đến từ trò chơi. Gom thế cờ là học không giám sát. Dự đoán bên thắng từ ảnh là phân loại có nhãn.
Phỏng theoNOAI 2025 Singapore · Phần 1 · Câu 3
Câu 2
Environment bị viết sai: bước vào đích nhận 10 nhưng không kết thúc. Đứng ở đích mà đi lên thì va tường, vẫn ở đích, và lại nhận 10. Với , value iteration cho giá trị của ô đích bằng bao nhiêu?
Ở đích, hành động tốt nhất là va tường để nhận 10 rồi quay lại chính trạng thái đó, nên , và . Tổng vô hạn số hạng vẫn hữu hạn, vì hệ số giảm dần. là chỉ tính một lần nhận thưởng. là cộng thêm đúng một bước. Robot học cách đứng lì ở đích để nhận điểm thay vì hoàn thành nhiệm vụ, và mọi ô khác cũng bị đánh giá quá cao. Cờ terminated là một phần của định nghĩa phần thưởng.
Câu 3
Trên lưới của bài, mỗi bước bị , bước vào đích được , và . Đổi thưởng vào đích thành , các bước khác vẫn . Policy tối ưu và thay đổi thế nào?
Mỗi bước chưa tới đích vẫn bị trừ 1, nên tới đích nhanh là cách duy nhất để ngừng mất điểm. Không bao giờ tới đích thì được , tệ hơn mọi đường tới đích. Vì vậy policy tối ưu giữ nguyên, chỉ có giá trị thay đổi: thay vì . Thưởng dương ở đích không phải điều kiện để robot muốn về đích.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.7
Câu 4
Mặt sàn trơn. Robot ở ô X, cách đích 2 ô trên một đường thẳng, với ô Y nằm giữa. Lệnh “tiến” có xác suất đi một ô và trượt đi hai ô. Từ Y thì cả hai trường hợp đều vào đích. Vào đích nhận 10, bước khác nhận 0, , và “tiến” là hành động tốt nhất. bằng bao nhiêu?
Từ Y, mọi kết quả đều vào đích, nên . Tại X, lấy kỳ vọng theo các kết quả của một hành động: . là bỏ qua khả năng trượt. là coi trường hợp tốt luôn xảy ra. là quên nhân xác suất cho nhánh đi một ô.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.9
Câu 5
Một policy cố định đưa robot đi qua đi lại mãi giữa hai ô. Từ A sang B nhận 0, từ B sang A nhận 1, và . bằng bao nhiêu?
Viết phương trình Bellman cho policy cố định: và . Thế vào thì , nên . là . chỉ tính hai bước đầu. là như thể bước nào cũng nhận 1.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q6(a)
Câu 6
Value iteration lưu thành một bảng đầy đủ, với trạng thái và hành động. Một vòng cập nhật mọi trạng thái tốn cỡ bao nhiêu phép nhân cộng, và chuyển trạng thái ngẫu nhiên có làm đổi con số ấy không?
Mỗi cặp cộng qua mọi trong bảng, nên có phép, dù nhiều xác suất bằng 0. Bảng đầy đủ không phân biệt chuyển tất định hay ngẫu nhiên, nên chi phí không đổi. chỉ đạt được khi lưu riêng danh sách trạng thái kế tiếp, như hàm step của bài. là chi phí giải trực tiếp hệ tuyến tính của , tức bước đánh giá trong policy iteration, không phải một vòng value iteration.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q4.1
Câu 7
MDP có bốn trạng thái A, B, C, D và hai hành động Move, Stay chưa rõ tác dụng. Q-learning với khởi tạo bằng 0, , lần lượt nhận các transition , , , và . Sau năm lần cập nhật, những ô nào của bảng khác 0?
Với , mỗi lần cập nhật ghi đè . Ba lần đầu chỉ đặt . Lần thứ tư, , vì lúc đó B chưa có tin tốt nào. Lần thứ năm, . Giá trị cho A chỉ xuất hiện ở lần đi qua A sau đó, vì thưởng lan ngược mỗi lượt một bước.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q7(a)
Câu 8
Tiếp tục với bảng của câu trước, , . Agent nhận thêm rồi , và mọi vẫn bằng 0. Giá trị mới của và là bao nhiêu, và cần sửa điều gì?
, còn . Move ở B lúc thì tới C, lúc thì tới D, tức chuyển trạng thái là ngẫu nhiên. Với , mỗi mẫu mới xóa sạch kinh nghiệm cũ, nên nhảy từ về . nhỏ, hoặc giảm dần, làm tiến dần tới kỳ vọng của target. Thử Stay nhiều hơn không sửa được việc ghi đè. không liên quan đến dao động này.
Câu 9
Environment cắt mỗi episode ở lượt 100, với truncated=True, dù robot chưa tới đích. Đoạn cập nhật dưới đây sai ở đâu?
s2, r, terminated, truncated, _ = env.step(a)
done = terminated or truncated
target = r if done else r + gamma * Q[s2].max()
Q[s, a] += alpha * (target - Q[s, a])
Hết lượt là giới hạn của việc thu mẫu, không phải nhiệm vụ đã kết thúc. s2 vẫn có tương lai, nên target vẫn phải bootstrap. Dùng done là cắt mất phần , kéo của những ô hay gặp ở lượt 100 xuống thấp hơn thật. Đặt r = 0 là sửa sai chỗ, vì thưởng của bước ấy vẫn có thật. Đảo vai trò của hai cờ thì lại bootstrap qua đích thật.
Câu 10
Với bandit của bài, trái được 1 điểm, phải được 3 điểm, , và mẫu REINFORCE là . So sánh baseline với .
Với , chọn phải được , chọn trái được , nên trung bình là và phương sai là . Với , chọn phải được , chọn trái được , nên mọi mẫu đều bằng , và phương sai bằng . Kỳ vọng không đổi vì , nên baseline chỉ làm bớt dao động. Ở đây đúng bằng thưởng trung bình, nên triệt tiêu hết nhiễu. Trong những bài nhiều bước, một baseline tốt thường là ước lượng của .
Phỏng theoCMU 10-601 · Exam 3 Practice · Q5.3(a)
Đọc thêm
- Sutton, Barto — Reinforcement Learning: An Introduction, bản thứ hai, chương 3, 4, 6 và 13. Đọc định nghĩa MDP, Bellman, Q-learning và REINFORCE; chú ý các giả thiết của kết quả hội tụ.
- Ma, Ng — CS229 Lecture Notes, phần Reinforcement Learning and Control. Đọc để nối Bellman và value iteration với dynamic programming và phân biệt mô hình đã biết với học từ tương tác.
- Watkins, Dayan — Q-learning, 1992. Đọc định nghĩa cập nhật bản bảng và các điều kiện của kết quả hội tụ; một lưới nhỏ chạy đúng không thay được những điều kiện ấy.
- Sutton và cộng sự — Policy Gradient Methods for Reinforcement Learning with Function Approximation. Đọc sau ví dụ bandit để thấy vì sao có thể ước lượng gradient của một policy từ trải nghiệm.
- Gymnasium — Handling Time Limits. Đọc để xử lý đúng
terminated,truncatedvà bootstrap khi chuyển code của bài sang environment thư viện.