Image segmentation gán nhãn cho từng điểm ảnh, thay vì khoanh box như detection. Ví dụ muốn đo diện tích vùng mực trên ảnh bài làm: box quanh chữ còn chứa nhiều nền trắng, nên phải biết chính xác điểm ảnh nào là mực. Bài này học U-Net, kiến trúc giữ được chi tiết nhỏ dù phần encoder thu nhỏ ảnh, và các metric Dice, IoU, dùng được cả khi nền chiếm gần hết ảnh.
Mask trả lời một câu hỏi cho mỗi điểm
Có ba kiểu segmentation:
- Semantic: mỗi pixel một lớp, chẳng hạn nền, mực, giấy. Hai vật thể cùng lớp mang cùng ID.
- Instance: tách ID cho từng vật thể, dù chúng cùng lớp. Nếu cần đếm hai chai chạm nhau, semantic mask “chai” chưa đủ để tách chúng.
- Panoptic (toàn cảnh): gộp hai yêu cầu, mọi pixel có lớp, và những vật đếm được như người, xe còn có ID riêng.
Mask cũng là số đo: hồ 400 pixel, mỗi pixel ứng với ô m, rộng khoảng 10 000 m².
Instance mask phải giữ ranh giới giữa các vật thể cùng lớp, nên cần model có khái niệm “từng vật”. Một cách phổ biến là Mask R-CNN: lấy detector hai giai đoạn Faster R-CNN của bài 5.5 và thêm một nhánh dự đoán mask nhị phân nhỏ, cỡ , bên trong mỗi box. Mỗi vật thể nhận lớp, box, score và mask riêng, nên hai chai chạm nhau vẫn là hai instance.
U-Net trong bài này là model semantic: mỗi pixel nhận một lớp, không có ID vật thể.
Hỏi nhanh
Ảnh có hai chai chạm nhau, và mọi vật thể đều là chai. Từ instance mask có dựng lại được semantic mask không? Còn chiều ngược lại thì sao?
Instance mask có ID 1 và 2 cho hai chai. Đặt mọi ID khác 0 thành lớp “chai” là ra semantic mask. Semantic mask thì chỉ còn một vùng “chai”, và đường ranh giữa hai chai chạm nhau đã mất. Muốn tách lại phải có thêm thông tin, như box hay một model instance. Vì vậy nhãn instance đắt hơn, nhưng phục vụ được cả hai loại bài.
Với bài nhị phân vùng mực, đầu ra thường là một logit cho mỗi pixel: (N,1,H,W). BCEWithLogitsLoss nhận logits và target float cùng shape. Khi suy luận, sigmoid thành xác suất rồi threshold thành mask.
Với nhiều lớp loại trừ nhau, logits là (N,K,H,W), target là (N,H,W) long, dùng cross-entropy rồi argmax theo chiều lớp: 21 lớp trên ảnh cho logits . Mask lưu dạng ảnh thường mang 0/255; phải đổi về 0/1 kiểu long trước cross-entropy, vì 255 vượt quá số lớp.
Hỏi nhanh
Mask 3 lớp, gồm 0 là nền, 1 là giấy, 2 là mực, được đọc thành tensor float shape (N, 1, H, W). Logits có shape (N, 3, H, W). Gọi nn.CrossEntropyLoss()(logits, masks) thì báo lỗi. Sửa thế nào?
Tại mỗi pixel, cross-entropy cần logits và một ID lớp nguyên, nên target phải là (N, H, W) kiểu long. Một kênh logits chỉ đủ cho bài nhị phân, không chứa được ba lớp. BCE đòi target cùng shape với logits và coi mỗi giá trị là xác suất trong , nên target 0, 1, 2 vô nghĩa. Argmax cho ra ID nguyên, cắt mất gradient và bỏ hết thông tin về độ tin.
Nhãn segmentation đắt hơn nhãn cả ảnh: phải xác định từng pixel hoặc vùng. Biên có thể mơ hồ do bóng, mờ hoặc chính sách annotation. Model chỉ có thể học theo quy tắc nhãn đã cung cấp; cần xem vài cặp ảnh–mask ở độ phân giải thật.
Vì sao accuracy chưa đủ?
Giả sử 99% pixel là nền. Dự đoán tất cả nền có pixel accuracy 99% nhưng bỏ mọi vùng mực. Ta cần metric đo chồng lấn vùng mục tiêu.
Với là tập pixel dự đoán foreground, là tập thật:
Viết bằng TP, FP, FN: IoU , Dice . TN không xuất hiện, nên nhiều nền đúng không che hết lỗi foreground.
Hỏi nhanh
Ảnh có 1% pixel là foreground, còn model đoán toàn nền. Pixel accuracy và Dice của foreground lần lượt bằng bao nhiêu?
Accuracy đếm cả TN, nên vẫn được 99%. Dice không có TN. Ở đây TP bằng 0 còn FN lớn hơn 0, nên Dice bằng . 0.99 là gán nhầm accuracy cho Dice. Dice bằng 1 chỉ khi cả hai mask đều rỗng, còn ở đây mask thật có foreground. Accuracy 0% là quên rằng những pixel nền đoán đúng cũng được tính.
Ví dụ: ground truth [1,1,1,0], prediction [1,1,0,1] có TP = 2, FP = 1, FN = 1. IoU , Dice .
Với mask không rỗng, Dice , nên hai chỉ số đi cùng chiều nhưng giá trị khác. Ví dụ mask dự đoán 30 pixel, mask thật 20, chung 15 cho Dice ; còn IoU 0.6 ứng với Dice . Ảnh vệ tinh 95% nền mà model đoán toàn nền thì pixel accuracy 95% nhưng IoU của lớp “nhà” bằng 0.
import numpy as np

def mask_scores(predicted, target):
    predicted = np.asarray(predicted, dtype=bool)
    target = np.asarray(target, dtype=bool)
    assert predicted.shape == target.shape
    intersection = np.logical_and(predicted, target).sum()
    union = np.logical_or(predicted, target).sum()
    total = predicted.sum() + target.sum()
    iou = 1.0 if union == 0 else intersection / union
    dice = 1.0 if total == 0 else 2 * intersection / total
    return float(iou), float(dice)

print(tuple(round(v, 4) for v in mask_scores([1, 1, 0, 1], [1, 1, 1, 0])))
print(mask_scores(np.zeros(4), np.zeros(4)))
print(mask_scores([0, 0, 0, 0], [1, 0, 0, 0]))
(0.5, 0.6667)
(1.0, 1.0)
(0.0, 0.0)
Hàm trên cho điểm 1 khi cả hai mask đều rỗng: không có pixel foreground nào để đoán sai. Scorer của đề có thể bỏ ảnh hoặc lớp rỗng, hoặc dùng quy tắc khác; khi nhiều ảnh không có vật thể, chính quy tắc này quyết định một phần lớn điểm.
Cách gộp cũng đổi kết quả: mean Dice theo ảnh cho mỗi ảnh một phiếu, còn Dice tính sau khi gộp pixel của mọi ảnh cho vùng lớn trọng lượng lớn hơn.
Hỏi nhanh
Ảnh A có vật lớn, với TP = 90, FP = 10, FN = 0. Ảnh B có vật nhỏ, với TP = 1, FP = 0, FN = 9. Mean Dice theo ảnh và Dice sau khi gộp pixel của hai ảnh xấp xỉ bao nhiêu?
Dice(A) và Dice(B) , nên trung bình khoảng 0.565. Khi gộp pixel thì TP = 91, FP = 10, FN = 9, và Dice . Vật lớn chiếm gần hết số pixel, nên cách gộp gần như che mất lỗi bỏ sót vật nhỏ, còn mean theo ảnh làm lỗi ấy lộ ra. Cả hai cách đều hợp lệ, nhưng chọn model thì phải theo đúng cách đề chấm.
U-Net giữ cả ngữ cảnh lẫn chi tiết
Encoder giảm độ phân giải để đọc ngữ cảnh rộng. Decoder tăng độ phân giải để xuất mask. Nếu chỉ phóng to biểu diễn nhỏ, thông tin biên đã mất không tự trở lại. U-Net nối feature map encoder với decoder ở độ phân giải tương ứng, thường bằng phép nối kênh (concatenate).
Khác residual giữ nguyên số kênh, skip của U-Net cat hai tensor theo chiều kênh: số kênh cộng lại, còn của hai tensor phải khớp. Conv ngay sau phép nối phải được khai báo với tổng số kênh đó; mạng trong bài nối 4 kênh skip với 8 kênh từ đáy thành 12 kênh.
Hỏi nhanh
Sau khi phóng to, decoder có 64 kênh. Skip từ encoder có 32 kênh, cùng và . Sau torch.cat(..., dim=1), conv kế tiếp phải nhận bao nhiêu kênh vào?
Nối theo kênh thì số kênh cộng lại: . 128 đến từ việc nhớ máy móc rằng nối skip thì gấp đôi. Điều đó chỉ đúng khi decoder và skip có cùng số kênh, như U-Net gốc. 64 là quên kênh của skip, như thể phép nối là phép cộng residual. 32 là chỉ đếm skip.
Decoder phóng to bằng một trong hai cách:
- Nội suy (
F.interpolate, nearest hoặc bilinear): không có tham số học. - Transposed convolution (
nn.ConvTranspose2d): kernel học được. Với kernel , stride , padding , chiều ra là (cộng thêmoutput_paddingnếu đặt, mặc định 0), nên cấu hình hay gặp , cho đúng . Ngược với conv thường, stride ở đây làm ảnh lớn lên:nn.ConvTranspose2d(64, 32, kernel_size=2, stride=2)đưa(1, 64, 16, 16)thành(1, 32, 32, 32).
Với 4 lần pooling, cạnh ảnh nên chia hết cho 16; ảnh bị làm tròn xuống ở mỗi lần pooling nên lúc nối hai tensor lệch kích thước, trừ khi pad ảnh lên 112 hoặc phóng theo đúng size của skip như mục sau.
Hỏi nhanh
nn.ConvTranspose2d(8, 4, kernel_size=2, stride=2) nhận tensor (N, 8, 6, 6). Đầu ra có shape gì?
Cạnh mới là , và số kênh ra là tham số thứ hai, tức 4. (N, 4, 3, 3) là áp công thức của conv thường, nơi stride 2 làm ảnh nhỏ đi. (N, 4, 7, 7) là quên stride, coi như stride 1. (N, 8, 12, 12) giữ số kênh vào, tức nhầm vai trò của hai tham số đầu.
Bài báo U-Net (Ronneberger và cộng sự, 2015) giảm độ phân giải bốn lần, số kênh tăng từ 64 lên 1024, và dùng conv không padding: ảnh vào cho mask , nên feature map của encoder phải được cắt phần giữa (crop) trước khi nối. Mạng trong bài chỉ có một mức, conv có padding và phóng to bằng nội suy, đủ nhỏ để train trên CPU.
U-Net chỉ gồm conv, pooling và phép phóng to, không có tầng fully connected gắn với kích thước ảnh, nên cùng bộ trọng số chạy được trên ảnh lớn hơn lúc train.
Giới hạn thật là bộ nhớ: ảnh vệ tinh hay ảnh hiển vi vài nghìn pixel mỗi chiều có thể không vừa GPU. Khi đó cắt ảnh thành các tile chồng lấn, dự đoán từng tile, rồi ghép logits và chỉ giữ (hoặc lấy trung bình) phần giữa mỗi tile, vì pixel sát mép tile thiếu ngữ cảnh ở một phía.
Dữ liệu nhỏ để nhìn được sai đúng
Ảnh tự tạo có hình chữ nhật sáng, nhiễu nhỏ và nền tối; mask đúng là hình chữ nhật. Train và validation dùng seed khác. Độ sáng gần như cho thẳng nhãn, nên đây là bài dễ: nó dùng để kiểm cả đường đi từ dữ liệu, shape, loss đến metric, chưa phải để so sánh model.
import torch
from torch import nn
import torch.nn.functional as F

torch.set_num_threads(1)
torch.manual_seed(56)

def make_rectangles(count, seed):
    rng = np.random.default_rng(seed)
    masks = np.zeros((count, 1, 12, 12), dtype=np.float32)
    for index in range(count):
        row, col = rng.integers(1, 6, size=2)
        height, width = rng.integers(3, 6, size=2)
        masks[index, 0, row:row + height, col:col + width] = 1
    noise = rng.normal(0, 0.08, masks.shape).astype(np.float32)
    images = np.clip(0.1 + 0.8 * masks + noise, 0, 1)
    return torch.from_numpy(images), torch.from_numpy(masks)

train_x, train_y = make_rectangles(24, 10)
valid_x, valid_y = make_rectangles(8, 11)
print(tuple(train_x.shape), tuple(train_y.shape))
print(int(train_y[0].sum()), int(valid_y[0].sum()))
(24, 1, 12, 12) (24, 1, 12, 12)
9 20
Hai tổng cuối là số pixel foreground trong hai mask mẫu: hình chữ nhật và . Nhìn chúng phát hiện ngay nhãn vô tình toàn 0, hoặc nhãn mang giá trị lạ, trước khi train. Mask ở đây là float 0/1 vì BCEWithLogitsLoss cần target float; bài nhiều lớp dùng ID kiểu long như đã nói.
Hỏi nhanh
Mask đọc từ PNG mang giá trị 0 và 255. Mask mẫu là hình chữ nhật 9 pixel, nhưng int(train_y[0].sum()) lại in ra 2295. Sai ở đâu, và BCEWithLogitsLoss sẽ ra sao?
. BCE không kiểm miền của target và cũng không tự chia. Với , hệ số trong số hạng thành , nên loss giảm mãi khi tăng. Thử nhanh với logits [3, 10, -2] và target [255, 255, 0] thì loss khoảng , và không có lỗi nào được báo. Cũng không có chuyện đếm trùng: tổng lớn vì mỗi pixel mang giá trị 255. Sửa bằng (mask > 0).float() trước khi train.
Viết và train U-Net nhỏ
Max pooling làm tròn xuống, nên với chiều lẻ, phóng gấp đôi không trở về đúng kích thước cũ: 13 thành 6, rồi 6 thành 12. Vì vậy interpolate nhận thẳng size của skip thay vì scale_factor=2. Ảnh của bài chia hết cho 2, nhưng cùng code vẫn nối đúng với ảnh có chiều lẻ.
class TinyUNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.encode = nn.Sequential(nn.Conv2d(1, 4, 3, padding=1), nn.ReLU())
        self.middle = nn.Sequential(nn.Conv2d(4, 8, 3, padding=1), nn.ReLU())
        self.decode = nn.Sequential(nn.Conv2d(12, 4, 3, padding=1), nn.ReLU())
        self.output = nn.Conv2d(4, 1, 1)

    def forward(self, images):
        skip = self.encode(images)
        low = self.middle(F.max_pool2d(skip, 2))
        up = F.interpolate(low, size=skip.shape[-2:], mode="nearest")
        joined = torch.cat([skip, up], dim=1)
        return self.output(self.decode(joined))

model = TinyUNet()
optimizer = torch.optim.Adam(model.parameters(), lr=0.02)
criterion = nn.BCEWithLogitsLoss()
print("logits:", tuple(model(train_x[:2]).shape))
for step in range(80):
    model.train()
    optimizer.zero_grad()
    loss = criterion(model(train_x), train_y)
    loss.backward()
    optimizer.step()

model.eval()
with torch.no_grad():
    valid_logits = model(valid_x)
    valid_loss = criterion(valid_logits, valid_y).item()
    masks = valid_logits.sigmoid() >= 0.5
scores = [mask_scores(masks[i, 0].numpy(), valid_y[i, 0].numpy())
          for i in range(len(valid_y))]
print("valid BCE:", round(valid_loss, 4))
print("mean IoU, Dice:", np.mean(scores, axis=0).round(4).tolist())
logits: (2, 1, 12, 12)
valid BCE: 0.0034
mean IoU, Dice: [0.9922, 0.996]
Dòng đầu xác nhận logits có đúng shape (2,1,12,12) của mask. BCE validation là 0.0034; mean IoU 0.9922 và mean Dice 0.996 lấy trung bình theo 8 ảnh validation. Loss là thứ được tối ưu, IoU/Dice là thứ được chấm, và cả hai ở đây đều đo trên validation.
Điểm gần 1 phản ánh dữ liệu sinh rất sạch; vùng mực thật mờ, chồng lên dòng kẻ hoặc có ánh sáng không đều khó hơn nhiều.
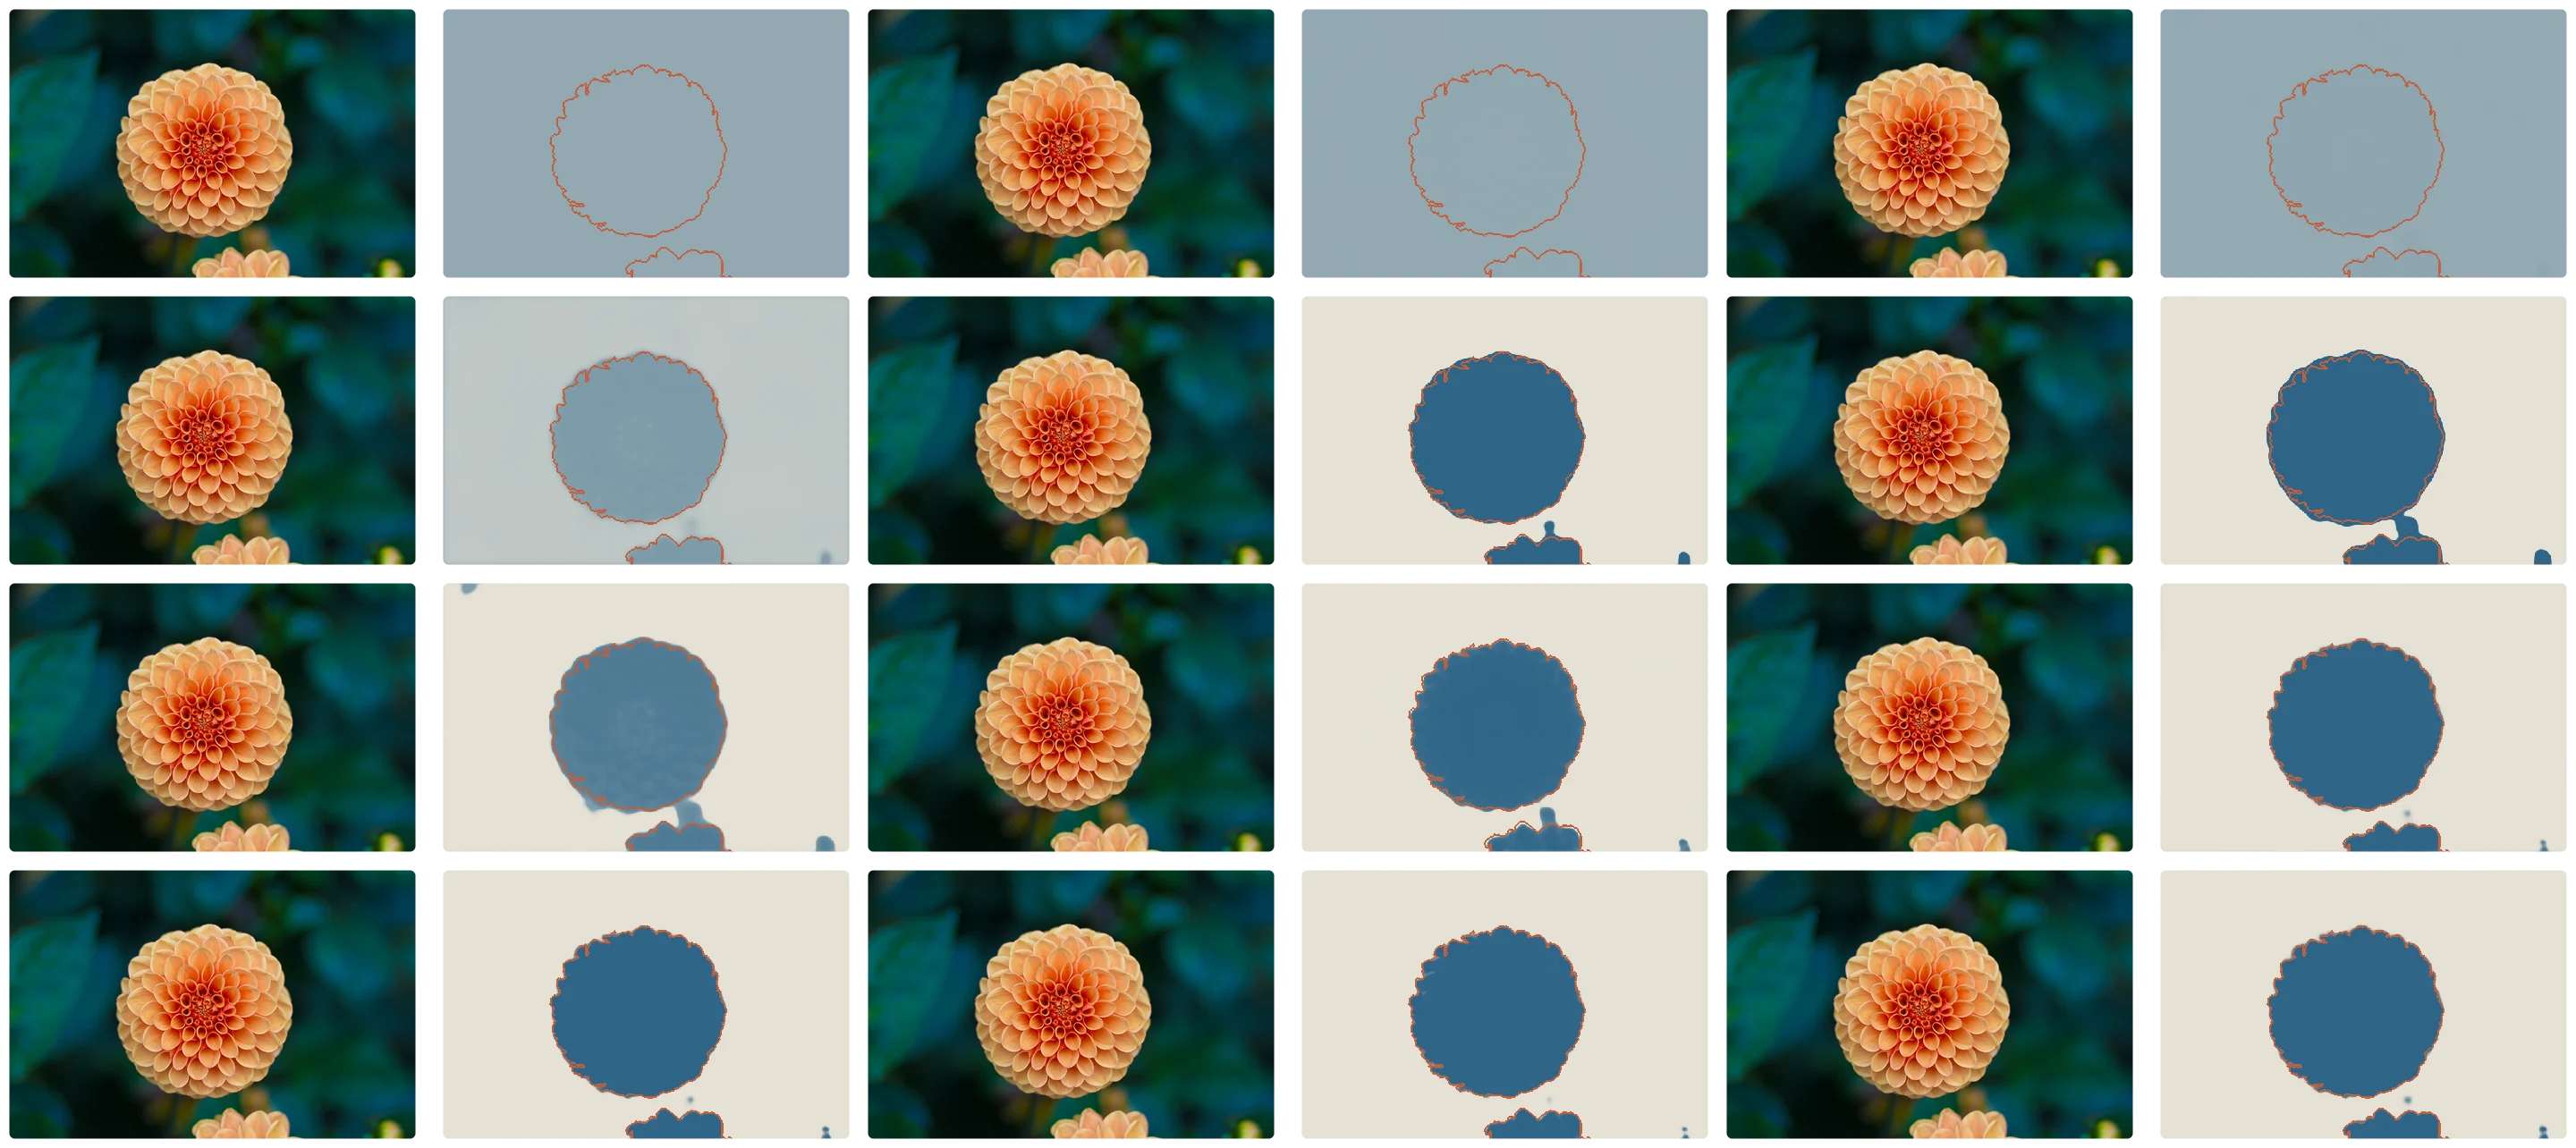
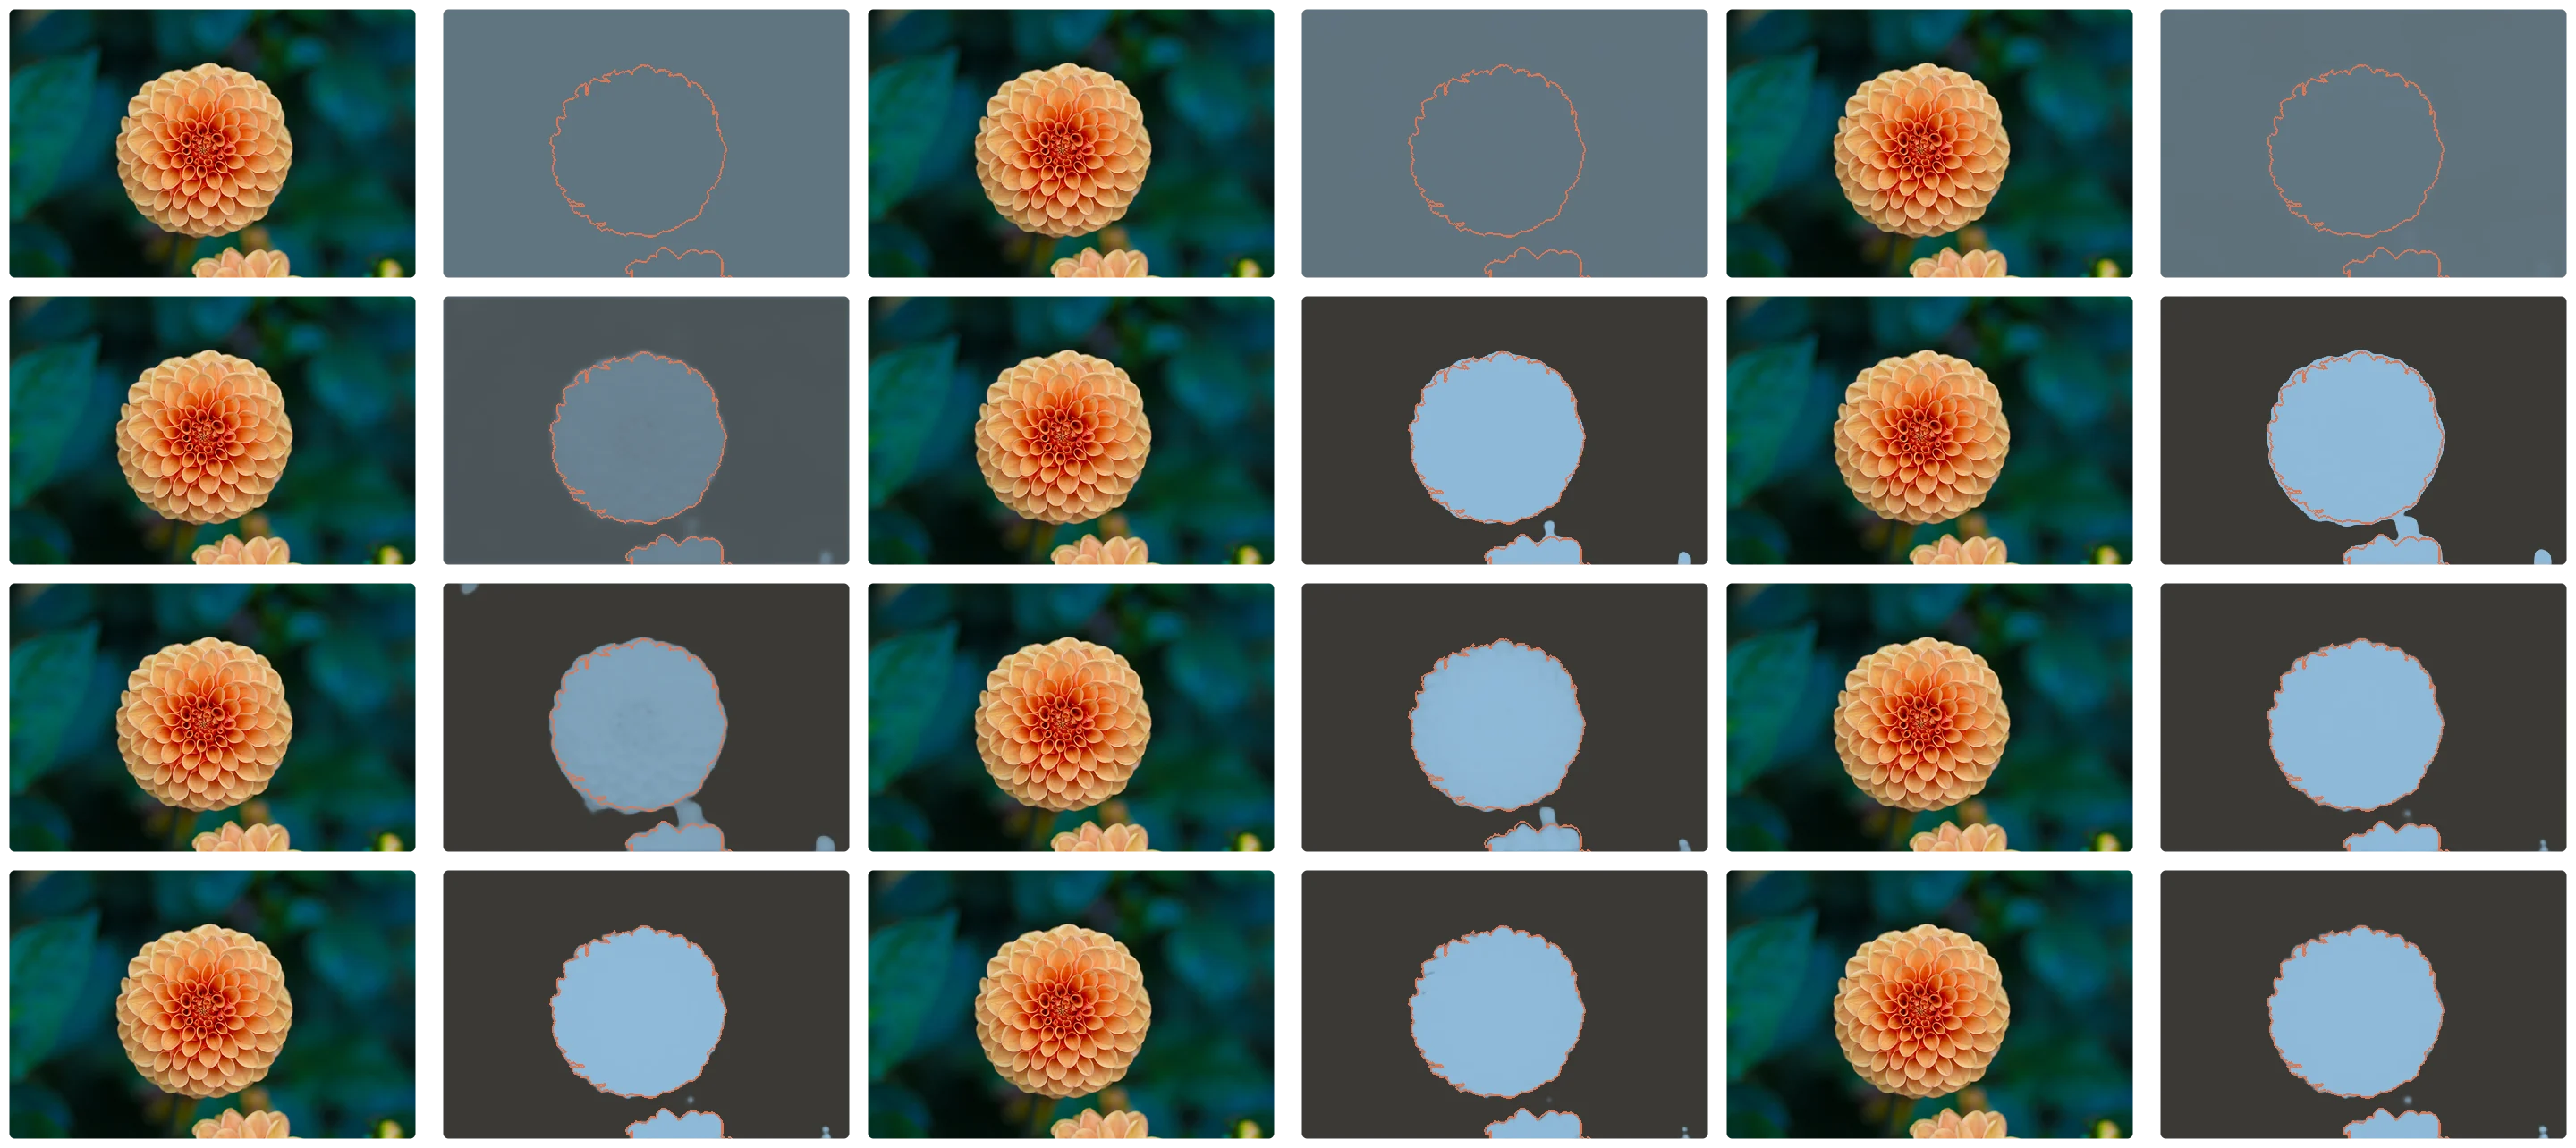
Dice cũng dùng làm loss được nếu thay tập nhị phân bằng xác suất :
với là nhãn và nhỏ (thường bằng 1) để mask rỗng không gây chia cho 0. Bản mềm này có đạo hàm theo ; threshold trước khi tính thì mất đạo hàm. Pixel nền đoán đúng (, ) gần như không góp gì vào tử lẫn mẫu, nên Dice loss không bị phần nền lớn lấn át như BCE lấy trung bình theo pixel.
Nhiều đội cộng BCE với Dice loss; tổ hợp nào tốt hơn do validation quyết định, vì tối ưu Dice loss không bảo đảm Dice sau threshold cao nhất.
Hỏi nhanh
Một đội viết loss = 1 - dice((model(x).sigmoid() >= 0.5).float(), y). Gọi loss.backward() thì báo element 0 of tensors does not require grad. Sửa thế nào mới đúng?
Phép so sánh >= tạo ra tensor không nối với graph, nên loss không có đường đạo hàm về model. Thêm .requires_grad_() thì hết lỗi, nhưng gradient dừng ngay ở mask đó, và tham số model vẫn không nhận được gì. Gradient của logits vẫn là None. Đổi threshold không thay đổi bản chất bậc thang. no_grad thì tắt hẳn việc ghi graph. Threshold chỉ dùng khi suy luận và khi chấm.
Cùng TinyUNet này có trong script của chương để train trên ảnh và mask của mình:
- Dữ liệu cần bốn thư mục
train/images,train/masks,valid/images,valid/masks; ảnh và mask cùng tên, mask chỉ mang 0/255 hoặc 0/1. - Lệnh không có
--runchỉ kiểm dữ liệu. Thêm--runcùng--from-scratch, hoặc cùng checkpoint kèm SHA-256, thì script resize ảnh bằng bilinear và mask bằng nearest, train trên CPU với batch 2, ghi checkpoint có mean Dice validation tốt nhất rồi nạp lại để suy luận thử một batch.
Khi so các cấu hình, ghi kèm split, kích thước ảnh và số epoch.
RLE: dùng lại kỹ năng xử lý dãy
Run-length encoding (RLE) lưu các đoạn foreground liên tiếp sau khi trải mask. Bài dùng một quy ước cụ thể: trải theo hàng (row-major), vị trí bắt đầu tính từ 1, mỗi cặp là start và length. Đó không phải chuẩn chung: COCO trải theo cột và ghi xen kẽ độ dài các run 0 và run 1; nhiều cuộc thi dùng cặp start–length nhưng đánh số pixel từ trên xuống dưới rồi mới sang phải, tức trải theo cột.
Mask trải theo hàng là 0,1,0,1,1,0, nên RLE là [2,1,4,2]. Trải theo cột cho 0,1,1,1,0,0, ra [2,3]. Cùng mask nhưng bytes đầu ra khác.
def encode_rle(mask):
    values = np.asarray(mask, dtype=np.uint8).ravel(order="C")
    padded = np.r_[0, values, 0]
    changes = np.flatnonzero(padded[1:] != padded[:-1]) + 1
    changes[1::2] -= changes[::2]
    return changes.tolist()

def decode_rle(runs, shape):
    assert len(runs) % 2 == 0
    flat = np.zeros(np.prod(shape), dtype=np.uint8)
    for start, length in zip(runs[::2], runs[1::2]):
        assert 1 <= start and length > 0 and start - 1 + length <= len(flat)
        flat[start - 1:start - 1 + length] = 1
    return flat.reshape(shape, order="C")

small_mask = np.array([[0, 1, 0], [1, 1, 0]], dtype=np.uint8)
runs = encode_rle(small_mask)
print(runs)
print(np.array_equal(small_mask, decode_rle(runs, small_mask.shape)))
print(encode_rle(np.zeros((2, 3), dtype=np.uint8)))
print(encode_rle(np.ones((2, 3), dtype=np.uint8)))
[2, 1, 4, 2]
True
[]
[1, 6]
Round trip True kiểm encoder/decoder nhất quán. Nó chưa chứng minh format khớp đề, vì hai hàm có thể cùng dùng sai thứ tự. Đối chiếu file mẫu của đề và vẽ mask giải mã ra mới kiểm được điều đó.
Hỏi nhanh
Mask [[1, 0], [1, 1]] được mã hóa theo hàng thành [1, 1, 3, 2], nhưng scorer lại giải mã theo cột. Scorer thấy mask nào?
Scorer bật các vị trí 1, 3 và 4, nhưng đánh số theo cột: 1 là ô (0, 0), 2 là (1, 0), 3 là (0, 1), 4 là (1, 1). Kết quả là [[1, 1], [0, 1]], đúng bằng ma trận chuyển vị. Chuỗi vẫn hợp lệ nên không có lỗi nào, chỉ có điểm thấp. Mask chỉ giữ nguyên khi cả hai phía dùng cùng thứ tự. [[0, 1], [0, 0]] là phần bù, không liên quan đến thứ tự đọc.
Đổi kích thước mask
Mask là nhãn rời rạc, nên khi resize phải dùng nearest: bilinear tạo giá trị trung gian giữa hai lớp. Khi đưa dự đoán về kích thước ảnh gốc, phóng logits hoặc xác suất (bilinear được, vì chúng là số liên tục) rồi mới threshold; RLE nộp bài phải mã hóa mask ở đúng shape gốc mà scorer dùng.
Lệch một pixel giữa ảnh và mask, do crop hoặc padding không đồng bộ, gây lỗi lớn ở nét mảnh. Connected components chỉ tách được những vùng không nối nhau, nên không thay được instance segmentation khi vật thể chạm nhau.
Hỏi nhanh
Mask một hàng [0, 0, 2, 2], với 0 là nền, 1 là giấy, 2 là mực, được phóng lên 8 cột bằng bilinear thành [0, 0, 0, 0.5, 1.5, 2, 2, 2]. Sau .long() thì thành [0, 0, 0, 0, 1, 2, 2, 2]. Sửa thế nào?
Bilinear lấy trung bình hai lớp 0 và 2 nên sinh ra 1, tức lớp “giấy”, thứ không hề có ở đó. .round() chỉ cứu được ví dụ này nhờ may mắn, vì 0.5 thành 0 và 1.5 thành 2. Giữa lớp 0 và lớp 3 thì nó vẫn sinh ra 1 và 2. align_corners chỉ dời vị trí lấy mẫu, float64 chỉ tăng độ chính xác, nên cả hai vẫn nội suy giữa các ID.
Khi đi thi
- Viết scorer theo đúng đề: Dice hay IoU, trung bình theo ảnh hay gộp pixel, ảnh rỗng tính thế nào.
- Chồng mask lên vài ảnh để bắt mask 0/255, lật trục hay ghép nhầm tệp.
- Đưa logits về kích thước gốc rồi mới threshold; giải mã thử vài dòng RLE trước khi nộp.
Tóm tắt
- Semantic segmentation cho mỗi pixel một lớp; instance segmentation tách thêm từng vật thể, chẳng hạn bằng Mask R-CNN. Loại nhãn và model chọn theo đầu ra đề yêu cầu.
- Dice/IoU đo chồng lấn foreground và không đếm TN; quy tắc mask rỗng và cách gộp (theo ảnh, theo lớp, gộp pixel) có thể đổi điểm rất nhiều.
- U-Net nối ngữ cảnh ở độ phân giải thấp với chi tiết từ encoder; khi nối, số kênh cộng lại còn phải khớp.
- Train bằng logits với BCE, hoặc Dice mềm trên xác suất; threshold chỉ dùng khi suy luận và chấm.
- RLE chỉ đúng khi thứ tự trải, chỉ số bắt đầu và shape khớp quy định của đề; round trip trong code chưa kiểm được điều đó.
Kiểm tra cuối bài
Câu 1
Đề yêu cầu báo tỉ lệ diện tích của mực, giấy và nền trên mỗi ảnh bài làm, không cần đếm nét chữ. Loại nhãn nào vừa đủ dùng vừa rẻ nhất?
Diện tích là số pixel của từng lớp, nên cần nhãn ở mức pixel, và semantic mask cho đúng điều đó. Nhãn cả ảnh không chứa vị trí. Box quanh chữ ôm cả nền trắng, nên đếm thừa diện tích mực. Instance mask cũng tính được diện tích, nhưng phải tách từng nét, tốn công gán nhãn mà đề không cần.
Câu 2
Đề cho ảnh hiển vi và yêu cầu nộp một mask riêng cho từng tế bào. Nhiều tế bào nằm sát, chạm vào nhau. Model nào cho ra đúng dạng đầu ra này?
Mask R-CNN cho mỗi vật thể một box, một lớp, một score và một mask riêng, đúng là instance segmentation. U-Net một kênh chỉ cho một vùng “tế bào” chung, nên các tế bào chạm nhau dính thành một vùng. YOLO cho box, không cho mask. ResNet phân loại chỉ cho một nhãn cho cả ảnh.
Phỏng theoNOAI 2025 Singapore · Phần 1 · Câu 15
Câu 3
Đề chấm bằng IoU, còn notebook in ra Dice. Trên một ảnh validation, Dice của mask dự đoán là 0.8. IoU của cùng cặp mask đó xấp xỉ bao nhiêu?
Từ Dice suy ra IoU . Kiểm bằng số: TP = 4 và FP + FN = 2 cho Dice bằng , IoU bằng . 0.89 là áp nhầm công thức chiều xuôi lên Dice. 0.4 là chia đôi. 0.8 là coi hai metric như nhau. Quan hệ này đúng cho từng cặp mask. Mean Dice của nhiều ảnh thì không đổi thẳng ra mean IoU được.
Câu 4
Hàm tính mIoU cho segmentation nhiều lớp duyệt từng lớp trên mỗi ảnh. Lớp “xe máy” chỉ có trong 5% số ảnh. Ở một ảnh không có xe máy, model cũng không đoán pixel xe máy nào, nên union của lớp này bằng 0. Xử lý thế nào để mIoU có ý nghĩa nhất?
Khi lớp vắng ở cả hai phía, ảnh này không cho biết gì về khả năng tô lớp đó. Bỏ qua thì mIoU chỉ đo những lớp có mặt. Gán 1 thì 95% số ảnh tặng điểm tuyệt đối cho lớp xe máy, thổi phồng mIoU. Gán 0 thì phạt model dù nó không sai, kéo mIoU xuống. Trọng số theo tần suất pixel làm lớp hiếm gần như biến mất khỏi điểm, ngược với điều cần đo. Scorer chính thức có thể chọn quy ước khác, nên scorer cục bộ phải theo đúng quy ước của đề.
Câu 5
Một đội bỏ mọi skip connection khỏi U-Net để tiết kiệm bộ nhớ. Mask mới vẫn nằm đúng vùng đại thể, nhưng biên bị nhòe và những nét mảnh 1–2 pixel biến mất. Như vậy skip connection chủ yếu làm việc gì?
Sau nhiều lần pooling, biểu diễn ở đáy biết có gì và ở vùng nào, nhưng đã mất vị trí chính xác của từng pixel. Phóng to không tạo lại được thông tin ấy. Skip đưa feature map phân giải cao của encoder vào decoder để định vị biên. Đường đi tắt có giúp gradient, nhưng triệu chứng ở đây là mất chi tiết chứ không phải train chậm. Phép nối làm conv của decoder nhận nhiều kênh hơn, tức tăng tham số. Bản thân phép nối là tuyến tính.
Câu 6
Ảnh vào , mọi Conv2d có padding=1, và mỗi mức encoder max-pool . Các skip s1, s2, s3 có kích thước 100, 50, 25. Đáy x có 512 kênh, sau thêm một lần pool nữa.
self.up1 = nn.ConvTranspose2d(512, 256, kernel_size=2, stride=2)
self.conv1 = nn.Conv2d(512, 256, kernel_size=3, padding=1)
...
x = self.up1(x)
x = torch.cat([x, s3], dim=1)   # dòng A, s3 có 256 kênh
x = self.conv1(x)
Dòng A báo Sizes of tensors must match. Vì sao?
Kích thước đi , vì max pooling lấy phần nguyên. Transposed conv với kernel và stride bằng 2 cho , lệch skip 25 một pixel. Số kênh thì khớp, conv1 nhận đúng 512. Nối theo batch đòi các chiều còn lại khớp, và trộn ảnh với feature. Conv có padding=1 giữ nguyên kích thước, nên lỗi không đến từ padding. Có ba cách sửa: phóng thẳng về size=s3.shape[-2:] như TinyUNet, pad thêm một hàng và một cột, hoặc chọn ảnh vào chia hết cho , như 96 hay 104. nn.Upsample(scale_factor=2) cũng chỉ cho 24 nên không sửa được. output_padding=1 cho 25, nhưng chỉ khớp riêng kích thước này.
Phỏng theoNOAI 2026 Singapore · Chung kết · Câu 13
Câu 7
Mask là [[0, 1, 1], [0, 0, 1], [1, 0, 0]]. RLE trải mask theo hàng, đánh số từ 1, gộp tối đa các số 1 liên tiếp, và ghi mỗi run thành (start, length). Mã nào đúng?
Trải theo hàng được 0, 1, 1, 0, 0, 1, 1, 0, 0. Có hai run tối đa, bắt đầu ở vị trí 2 và 6, mỗi run dài 2. [1, 2, 5, 2] là đếm vị trí từ 0. [2, 3, 6, 7] ghi (start, end) thay vì (start, length). [3, 2, 7, 2] là kết quả khi trải theo cột, được 0, 0, 1, 1, 0, 0, 1, 1, 0.
Câu 8
Ảnh vệ tinh cần mask đường đi rộng 2–3 pixel, nhưng GPU chỉ chạy được tile . Cắt thành 64 tile không chồng nhau rồi ghép lại thì mask tốt ở giữa tile, nhưng hay bị đứt dọc theo các đường cắt. Nên sửa theo hướng nào?
Pixel sát mép tile thiếu ngữ cảnh ở một phía, nên logits kém tin cậy. Tile chồng lấn cho mỗi pixel ít nhất một lần nằm gần giữa tile. Ta lấy trung bình logits hoặc chỉ giữ vùng giữa, rồi mới threshold. Thu ảnh 8 lần làm đường rộng 2–3 pixel còn chưa tới nửa pixel, tức mất hẳn. Threshold riêng cho từng tile còn tạo thêm vết nối. Train thêm cũng không cho pixel ở mép có thêm ngữ cảnh lúc suy luận.
Câu 9
Model được train trên ảnh resize về . Ảnh test gốc cao 768, rộng 1024, và scorer giải mã RLE theo shape gốc. Đội mã hóa thẳng mask mà model dự đoán. Phải làm gì mới đúng?
RLE ghi vị trí trong mảng đã trải của một shape cụ thể. Shape có 65 536 vị trí, còn ảnh gốc có 786 432. Scorer không biết mask đã bị co. Nhân với giữ đúng tổng diện tích nhưng sai vị trí: một run dài trên một hàng phải thành ba run dài trên ba hàng liền nhau, chứ không phải một run dài . Thứ tự trải không liên quan đến kích thước. Phóng logits bằng bilinear rồi threshold cho biên mượt hơn so với phóng mask nhị phân bằng nearest.
Câu 10
Tập test có 100 ảnh, trong đó 60 ảnh không có vết nứt. Scorer tính Dice từng ảnh rồi lấy trung bình. Ảnh nào có cả mask thật và mask dự đoán đều rỗng thì được 1. Một bài nộp toàn mask rỗng đạt bao nhiêu?
60 ảnh rỗng cả hai phía được 1. 40 ảnh có vết nứt có TP bằng 0, nên Dice bằng 0. Trung bình là . 0.4 là đếm ngược hai nhóm. 1 và 0 là quên hẳn một nhóm. Chiều ngược lại cũng đáng nhớ: chỉ vài pixel dương giả trên một ảnh rỗng là ảnh đó rơi từ 1 xuống 0. Vì vậy với scorer kiểu này, bỏ những vùng dự đoán quá nhỏ, hoặc thêm một classifier quyết định ảnh có vết nứt hay không, thường đáng công.
Đọc thêm
- Ronneberger, Fischer, Brox — U-Net: xem vai trò đường nối giữa encoder và decoder.
- PyTorch — BCEWithLogitsLoss: kiểm kiểu target, shape và cách ghép sigmoid.
- He, Gkioxari, Dollár, Girshick — Mask R-CNN: xem nhánh mask được gắn vào detector hai giai đoạn thế nào.
- COCO mask API: đối chiếu format RLE của COCO (trải theo cột, counts xen kẽ) với quy ước start–length trong bài.
Nguồn ảnh: ảnh hoa là ảnh mẫu flower.jpg kèm scikit-learn (vultilion, Flickr, CC BY 2.0); mask trong hình được đặt bằng ngưỡng màu, chỉ để minh họa.
Tải gói recipe của chương — gồm các module phụ và hướng dẫn chuẩn bị asset.