Một model có thể đúng hoàn toàn trên dữ liệu đã học mà vẫn sai trên dữ liệu mới, ví dụ khi nó chỉ lưu lại các buổi cũ rồi tra bảng. Điều ta cần là đoán tốt trên mẫu chưa thấy; khả năng đó gọi là tổng quát hóa (generalization). Bài này dùng một model đơn giản để thấy underfitting (model quá đơn giản), overfitting (model học thuộc dữ liệu train) và cách đọc learning curve để quyết định nên làm gì tiếp.
Nhớ một ví dụ khác với học một quy luật
Ta tạm thu bài toán xuống một feature trong khoảng 0–1: vị trí của một buổi trong lịch hoạt động. Mức tham gia đã chuẩn hóa là
tạo một xu hướng lên rồi xuống để nhìn được bằng hình. là nhiễu, ở đây sinh ngẫu nhiên với trung bình 0 và độ lệch chuẩn 0.25. Các giá trị âm có nghĩa là thấp hơn mức tham gia chuẩn, không phải số người âm. Dạng sóng này do ta tự đặt ra để thí nghiệm, nhờ đó biết chính xác đâu là quy luật, đâu là nhiễu. Học được là nhờ có quy luật: nếu nhãn hoàn toàn ngẫu nhiên như kết quả xổ số thì không mô hình nào đoán được, dù dữ liệu nhiều đến đâu.
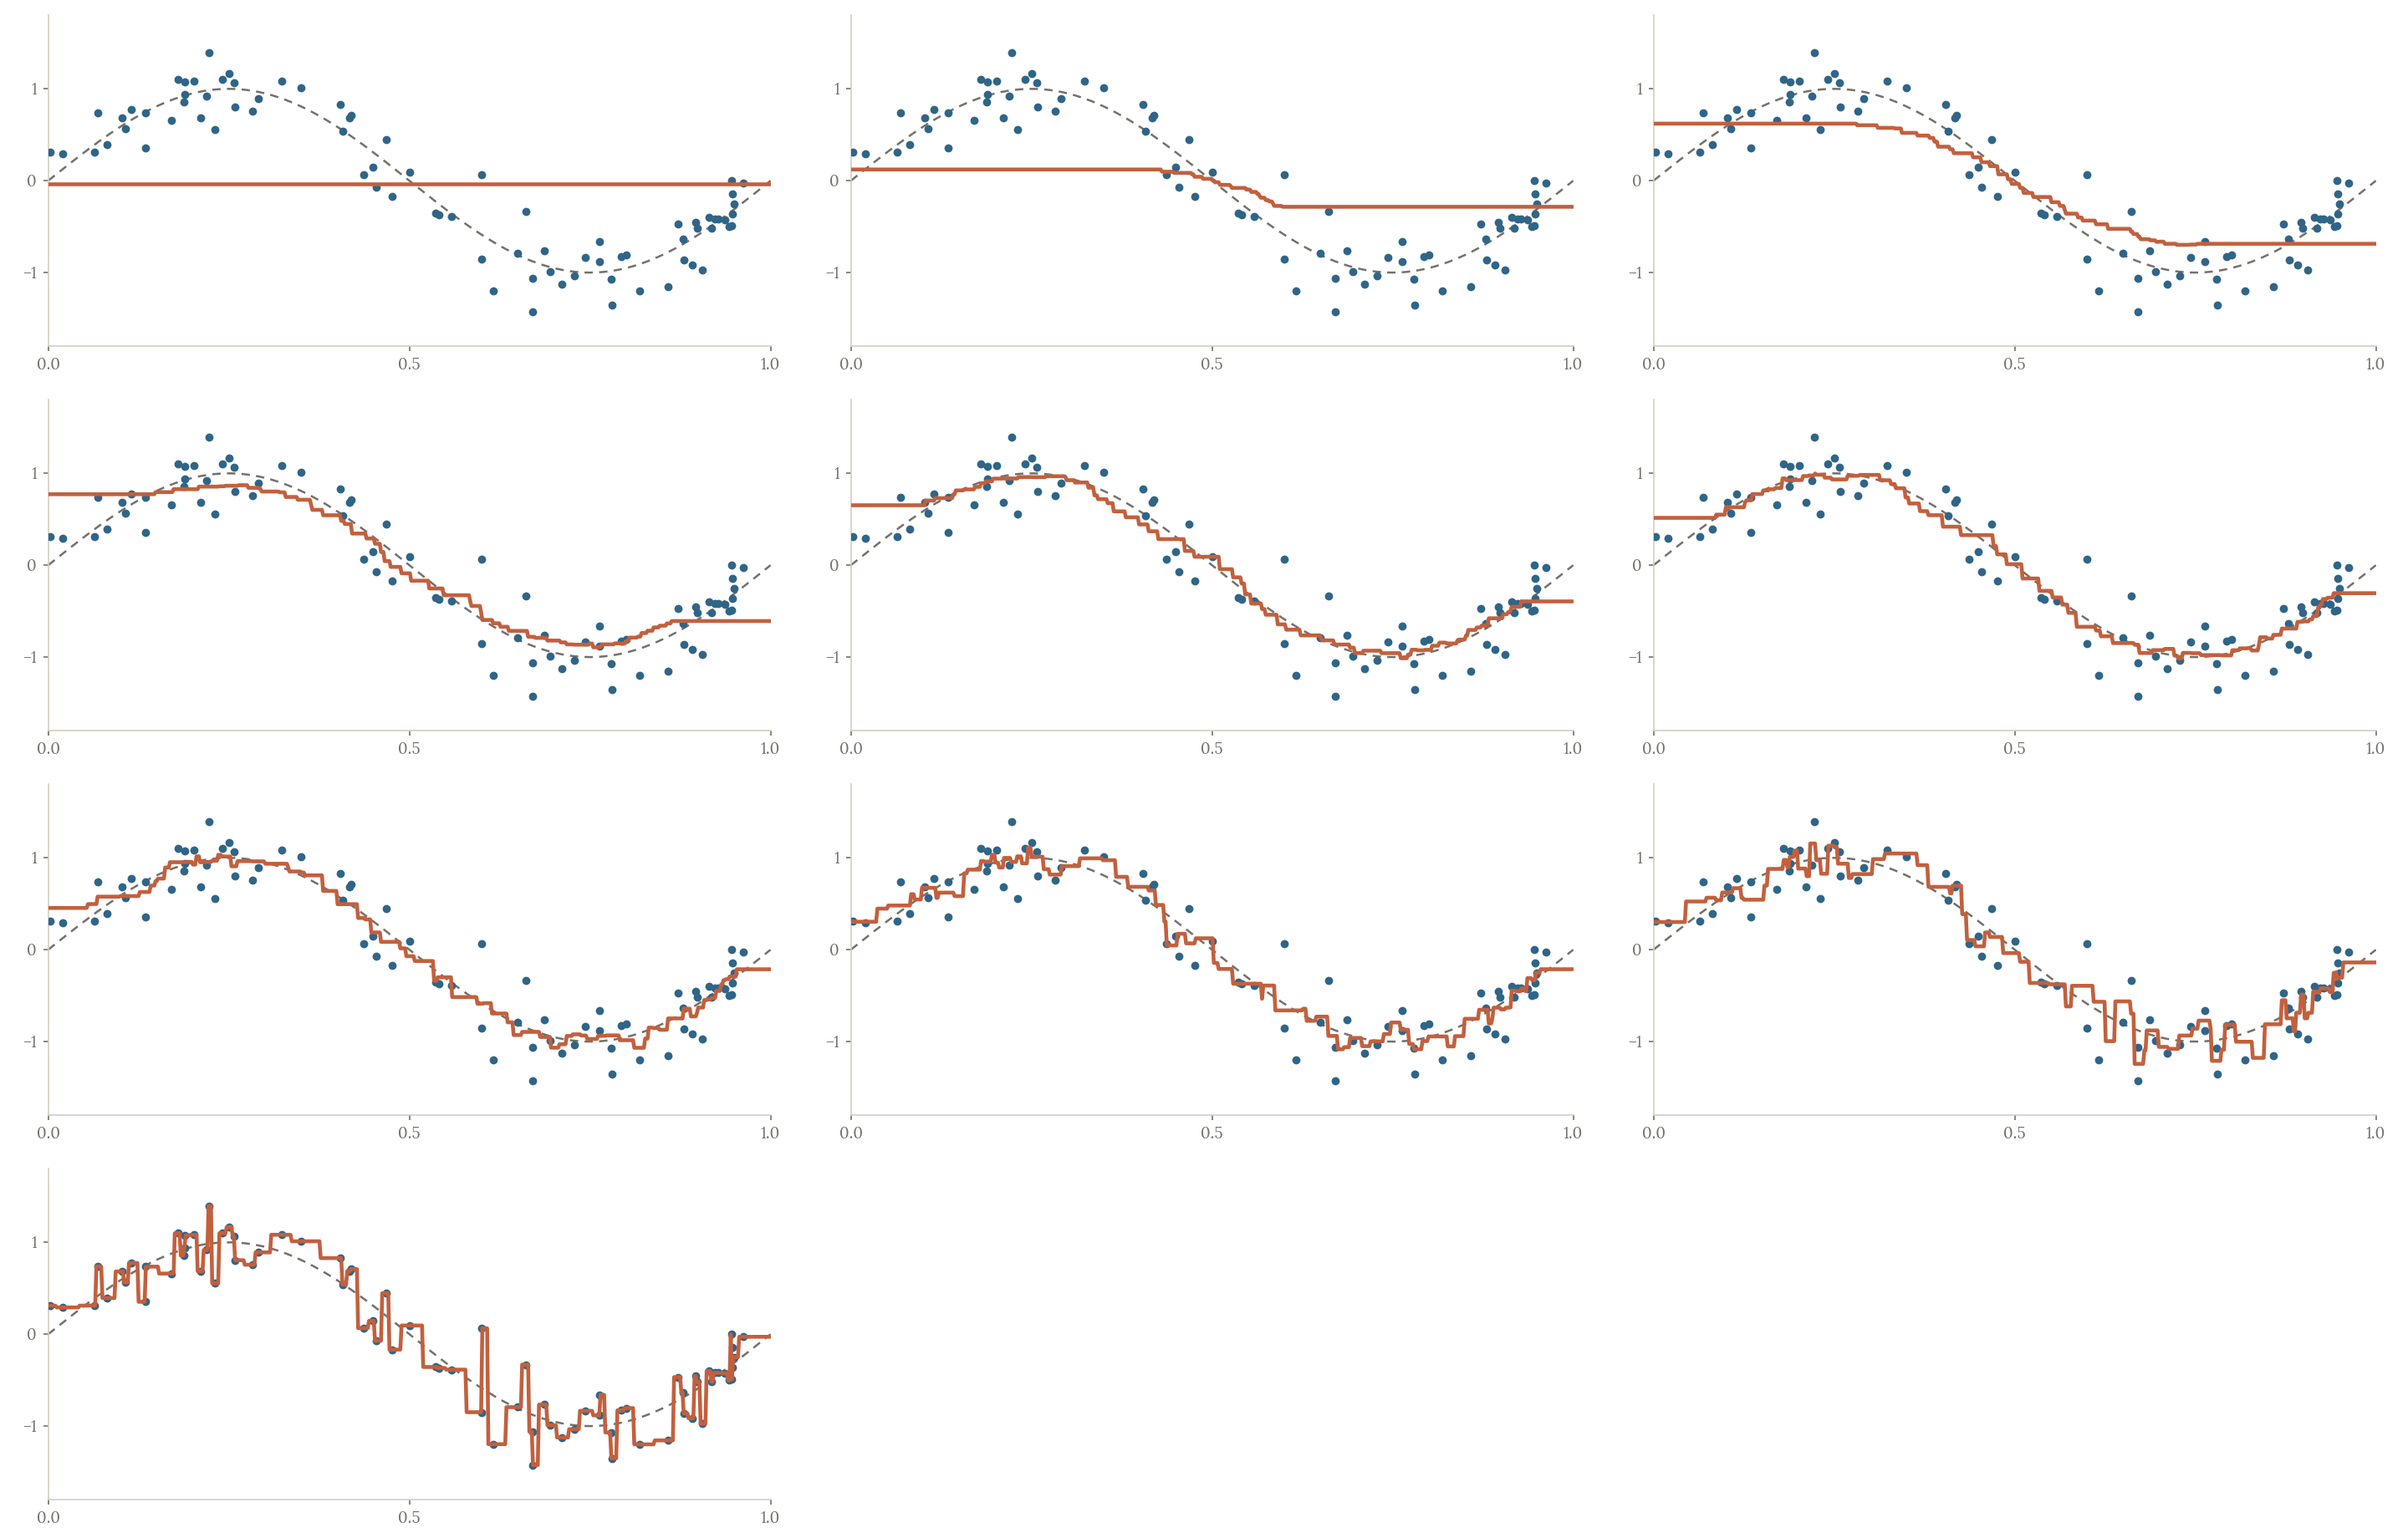
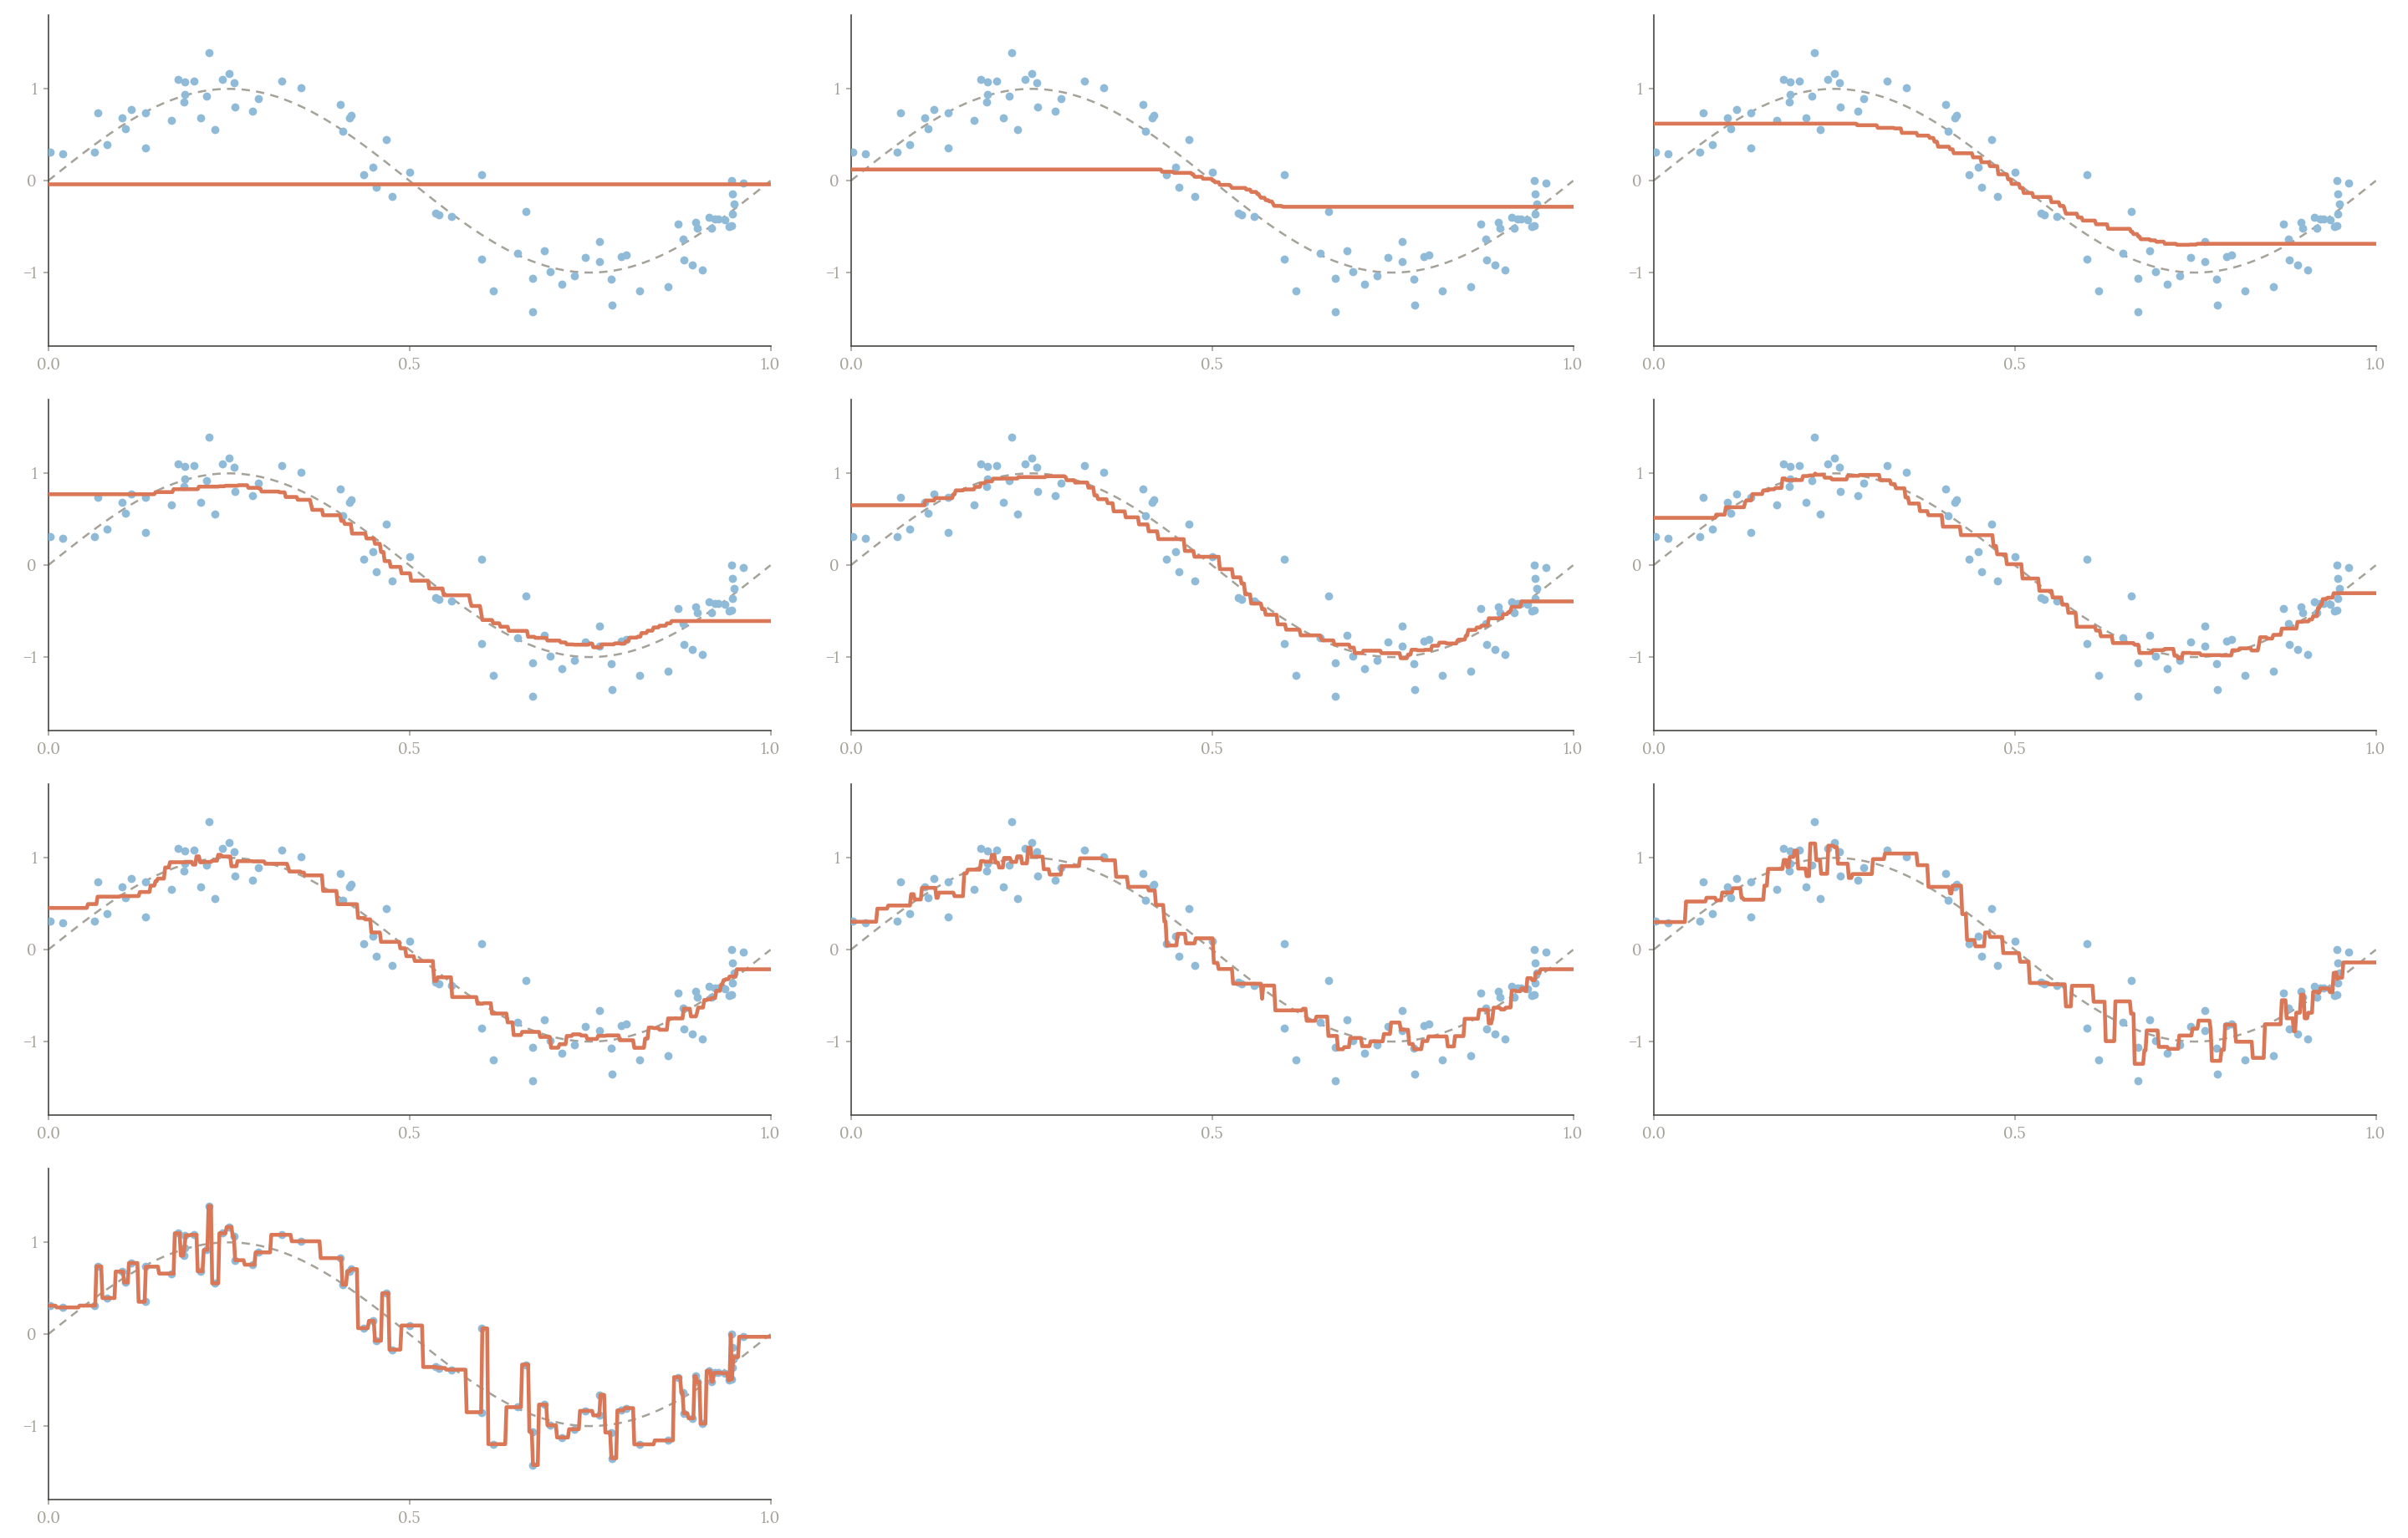
Mô hình trong hình là k-Nearest Neighbors regression, viết ngắn là kNN. Để đoán tại , nó tìm điểm train gần nhất rồi lấy trung bình nhãn của chúng. Bài 2.4 sẽ học thuật toán kỹ hơn; hôm nay chỉ dùng đặc tính: nhỏ cho đường linh hoạt hơn, lớn cho đường trơn hơn.
Với , tại một điểm train, hàng xóm gần nhất chính là nó, nên mô hình trả đúng nhãn đã quan sát. Điều ấy bao gồm cả phần nhiễu của riêng điểm đó. Với bằng toàn bộ số mẫu train, mọi vị trí nhận cùng một giá trị trung bình, dù xu hướng thật lên xuống rõ rệt.
Hỏi nhanh
Mô hình đoán đúng mọi nhãn trên tập train. Điều đó chứng minh được gì?
Khớp train chỉ là một quan sát trên dữ liệu cũ. Mô hình đủ mạnh có thể khớp cả những nhãn nhiễu, giống học thuộc đáp án đề cũ. Muốn biết khả năng tổng quát hóa, ta cần dữ liệu chưa hề được dùng để học hay để chọn phương án.
Viết rõ đang đo lỗi ở đâu
Giả sử có mẫu train. Sai số train với MSE là
Ví dụ ba mẫu có nhãn thật và dự đoán cho MSE .
Nhưng điều ta thật sự cần là lỗi trên các mẫu mới, tức trung bình lỗi nếu đem model dùng cho rất nhiều buổi sau này:
là kỳ vọng (bài 0.7), lấy trên mọi mẫu có thể gặp lúc dùng thật. Ta không có các mẫu đó, nên dùng tập validation để ước lượng . Muốn ước lượng đúng, validation phải giống dữ liệu lúc dùng thật; chia sai thì điểm có thể đẹp mà không nói lên điều ta cần. Khả năng đoán tốt trên mẫu chưa gặp lúc học gọi là tổng quát hóa, hay khái quát hóa (generalization); đó là thứ ta cần, không phải điểm trên train.
Trong thí nghiệm này, train và validation được sinh riêng từ cùng một công thức, nên validation giống hệt dữ liệu mới. Code tạo 80 mẫu train và 160 mẫu validation, rồi so ba giá trị .
import numpy as np
from sklearn.neighbors import KNeighborsRegressor
from sklearn.metrics import mean_squared_error

rng = np.random.default_rng(12)

def make_data(n):
    X = rng.uniform(0, 1, size=(n, 1))
    y = np.sin(2 * np.pi * X[:, 0]) + rng.normal(0, 0.25, size=n)
    return X, y

X_train, y_train = make_data(80)
X_valid, y_valid = make_data(160)
print(X_train.shape, y_train.shape)
for k in [80, 10, 1]:
    model = KNeighborsRegressor(n_neighbors=k).fit(X_train, y_train)
    train_mse = mean_squared_error(y_train, model.predict(X_train))
    valid_mse = mean_squared_error(y_valid, model.predict(X_valid))
    print(f"k={k:2d}: train={train_mse:.4f}, valid={valid_mse:.4f}")
(80, 1) (80,)
k=80: train=0.5861, valid=0.5654
k=10: train=0.0574, valid=0.0820
k= 1: train=0.0000, valid=0.1011
Đọc cả hai cột. Khi , train và validation cùng có lỗi lớn: mô hình quá đơn giản để giữ xu hướng. Khi , train có lỗi bằng 0, nhưng validation không vì thế thấp nhất. lấy trung bình cục bộ, giảm tác động của nhiễu mà còn giữ được dạng sóng.
Không chọn mô hình từ cột train. Cũng không biến ví dụ thành quy tắc “luôn dùng ”: số mẫu, mật độ điểm, độ nhiễu và số chiều thay đổi thì phù hợp cũng đổi.
Hỏi nhanh
Phương án A có MSE 0.01 trên train và 0.30 trên validation. Phương án B có MSE 0.08 trên train và 0.12 trên validation. Chọn theo validation thì ta chọn phương án nào?
Mục tiêu là đoán tốt mẫu mới, và validation là nơi đo điều đó. A khớp train rất sát nhưng đoán validation kém hẳn, đây là dấu hiệu cần xem kỹ. Test chỉ mở ra sau khi đã chọn xong; dùng test để chọn thì nó không còn độc lập.
Underfit và overfit là chẩn đoán có điều kiện
Underfitting (học chưa đủ): model quá đơn giản, không bắt được quy luật. Ví dụ san phẳng cả đường cong. Dấu hiệu: lỗi train và lỗi validation cùng cao và gần nhau. Thêm dữ liệu cùng loại không giúp, vì model còn chưa khớp nổi train; cần model linh hoạt hơn hoặc thêm đặc trưng tốt hơn.
Overfitting (học quá sát): model học thuộc cả nhiễu của train. Ví dụ : đổi một nhãn nhiễu là cả một đoạn dự đoán đổi theo. Dấu hiệu: lỗi train thấp mà lỗi validation cao hơn hẳn. Cách chữa: giảm độ linh hoạt (ở đây là tăng ), dùng regularization (chương 2), hoặc thêm dữ liệu.
Overfitting dễ xảy ra khi model có rất nhiều tham số mà dữ liệu ít, hay số đặc trưng nhiều hơn số mẫu, như 100 chỉ số xét nghiệm cho 50 bệnh nhân. Một mạng neural đủ lớn còn học thuộc được cả nhãn bị xáo ngẫu nhiên, đúng 100% trên train; vì vậy điểm train cao không chứng minh model đã học được quy luật.
Tuy vậy, hai dấu hiệu trên chỉ là gợi ý. Train tốt mà validation kém cũng có thể do dữ liệu đổi theo thời gian, một cột bị sai đơn vị, hay hai tập được xử lý khác nhau. Train và validation cùng kém cũng có thể do nhãn bị lệch hàng hay metric viết sai. Trước khi sửa model, nên kiểm lại dữ liệu và tính tay một ví dụ nhỏ.
Hỏi nhanh
Một mô hình phân loại review phim là khen hay chê, có 2.4 triệu tham số, học trên 5000 review. Nó đoán đúng 98.5% trên train, 72.3% trên validation và 71.8% trên test. Số liệu này chỉ ra vấn đề gì?
Hai dấu hiệu cùng chỉ một hướng: validation thấp hơn train tới 26 điểm, và mô hình có 2.4 triệu tham số mà chỉ có 5000 mẫu để học. Validation gần bằng test là điều bình thường khi hai tập giống nhau, không phải dấu hiệu lộ dữ liệu. Nếu dữ liệu đã thay đổi thì validation và test sẽ lệch nhau. Underfitting thì không thể đúng 98.5% trên train. Hướng chữa là giảm độ linh hoạt của mô hình, dùng regularization ở chương 2, hoặc thêm dữ liệu.
Learning curve: thêm dữ liệu có đáng làm không?
Câu hỏi thực tế: có nên thu thêm dữ liệu không? Learning curve trả lời câu đó: giữ , tăng dần số mẫu train, và đo lỗi train cùng lỗi validation ở mỗi mức. Trục ngang là số mẫu train. (Đừng nhầm với đường loss theo số bước huấn luyện, sẽ gặp ở chương 3.)
Hàm learning_curve của scikit-learn làm việc này. Ở mỗi kích thước, nó chia dữ liệu thành 4 phần (gọi là 4 fold), lần lượt giữ một phần để chấm và học trên phần còn lại, rồi lấy trung bình; bài 1.3 sẽ học kỹ cách chia này.
from sklearn.model_selection import KFold, learning_curve

X_curve, y_curve = make_data(400)
cv = KFold(n_splits=4, shuffle=True, random_state=12)
sizes, train_scores, valid_scores = learning_curve(
    KNeighborsRegressor(n_neighbors=10),
    X_curve, y_curve, cv=cv,
    train_sizes=[20, 60, 140, 300],
    scoring="neg_mean_squared_error",
    shuffle=True, random_state=12, n_jobs=1,
)
for size, train_score, valid_score in zip(
    sizes, train_scores.mean(axis=1), valid_scores.mean(axis=1)
):
    print(f"n={size:3d}: train MSE={-train_score:.4f}, valid MSE={-valid_score:.4f}")
n= 20: train MSE=0.2133, valid MSE=0.2187
n= 60: train MSE=0.0701, valid MSE=0.0974
n=140: train MSE=0.0602, valid MSE=0.0761
n=300: train MSE=0.0610, valid MSE=0.0748
Các score có dấu âm vì công cụ chọn mô hình của scikit-learn quy ước “lớn hơn là tốt hơn”, nên MSE được đổi dấu thành neg-MSE; ta đổi dấu lại để đọc. Mỗi hàng là trung bình của bốn fold.
Với 20 mẫu, mười hàng xóm phủ một vùng rộng nên đường dự đoán bị san phẳng, cả hai lỗi đều cao. Thêm mẫu thì vùng ấy hẹp lại, đường giữ được dạng sóng, và lỗi validation giảm. Từ 140 lên 300 mẫu, lỗi validation gần như không giảm nữa.
Cách đọc một learning curve:
- Hai đường sát nhau và cùng đi ngang ở mức lỗi cao: underfitting. Thêm dữ liệu không giúp; cần model mạnh hơn hoặc đặc trưng tốt hơn.
- Hai đường cách xa, đường validation còn đang giảm: thêm dữ liệu còn có ích.
- Hai đường cách xa, đường validation đã đi ngang: overfitting; nên giảm độ phức tạp hoặc thêm regularization.
Đổi tỉ lệ chia, chẳng hạn từ 70% train và 30% test sang 90% và 10%, cũng theo cách đọc này: train nhiều hơn thường giúp nhưng không chắc, còn tập chấm nhỏ đi thì con số đo được dao động nhiều hơn.
Còn một mốc để so: kể cả khi biết chính xác , lỗi vẫn còn bằng phương sai của nhiễu, , vì không model nào đoán được nhiễu. Validation MSE 0.0748 ở 300 mẫu đã khá gần mốc ấy, nên không còn cải thiện được bao nhiêu. Với dữ liệu thật ta không biết mức nhiễu; người ta thường lấy kết quả tốt nhất mà con người làm được, như một nhóm bác sĩ hội chẩn, làm ước lượng cho mức lỗi thấp nhất có thể, gọi là sai số Bayes.
Hỏi nhanh
Tăng train từ 200 lên 800 rồi 2000 mẫu. MSE trên train lần lượt là 0.42, 0.43, 0.43. MSE trên validation là 0.46, 0.45, 0.45. Cách chia và metric đều đã kiểm. Ta nên thử gì trước?
Cả hai lỗi đều cao, gần như không đổi, và sát nhau. Đó là dấu hiệu mô hình quá đơn giản so với dữ liệu. Thêm mẫu không giúp được, còn giảm độ phức tạp chỉ làm tệ hơn. Chọn seed theo điểm là chọn lại cách đánh giá, không sửa được gì ở mô hình.
Trở lại câu chuyện câu lạc bộ
Model học trên các buổi trong năm học rồi đem dùng vào dịp hè có thể đoán kém, vì số đăng ký, lịch học và thói quen tham gia đều đổi. Hiện tượng dữ liệu lúc dùng khác dữ liệu lúc học gọi là distribution shift (thay đổi phân phối). Model chỉ đáng tin trong vùng dữ liệu đã học. Vài ví dụ:
- Học giá nhà 40–120 m² rồi đoán căn 600 m²: đoán ra ngoài vùng đã học (ngoại suy).
- Nhận diện khuôn mặt học trên người lớn, dùng cho trẻ em.
- Học trên ảnh chụp ban ngày, dùng cho ảnh ban đêm.
- Học trên dữ liệu năm 2023, dùng cho năm 2025.
Cách sửa gốc là đưa đúng loại dữ liệu sẽ gặp lúc dùng vào train, và chấm trên dữ liệu gần thời điểm dùng nhất. Vì vậy “model tổng quát hóa tốt” luôn phải nói rõ: tốt cho trường hợp nào. Đoán các buổi sau của cùng câu lạc bộ khác với đoán cho câu lạc bộ ở một trường mới; bài 1.3 sẽ chia dữ liệu theo thời gian và theo nhóm để đo từng trường hợp.
Hỏi nhanh
Ta cần dự báo cho tháng sau. Chia dữ liệu ngẫu nhiên thì MAE là 2. Giữ riêng tháng cuối làm validation thì MAE là 5. Nên tin con số nào?
Cách chia phải giống lúc dùng thật, tức là đoán tương lai. Giữ riêng tháng cuối làm đúng việc ấy. Chia ngẫu nhiên thì mô hình được học cả những ngày xen kẽ trong chính tháng đang chấm. Khoảng chênh giữa 2 và 5 là điều cần tìm hiểu tiếp: tháng cuối có gì khác. Chưa đủ căn cứ để đổ hết cho dữ liệu hay cho mô hình.
Khi đi thi
- Ghi cả lỗi train lẫn lỗi validation cho mỗi lần thử; một cột không đủ để chẩn đoán.
- Train tốt, validation kém: giảm độ linh hoạt hoặc thêm regularization. Cả hai cùng kém: thêm feature hoặc dùng model mạnh hơn.
- Chia validation giống lúc dùng thật: đoán tương lai thì giữ riêng đoạn thời gian cuối.
Tóm tắt
- Generalization là đoán tốt trên mẫu mới, trong đúng trường hợp sẽ dùng model.
- Lỗi train thấp chưa đủ; phải xem lỗi validation, và validation phải chia giống lúc dùng thật.
- Cả hai lỗi cùng cao: underfitting. Train thấp, validation cao hẳn: overfitting. Nhưng kiểm dữ liệu trước khi sửa model.
- Learning curve vẽ lỗi theo số mẫu train, cho biết thu thêm dữ liệu có đáng không.
Kiểm tra cuối bài
Câu 1
Một mô hình khớp train rất tốt. Bằng chứng nào cho thấy nó cũng sẽ đoán tốt khi đem dùng thật?
Muốn biết mô hình tổng quát hóa tốt không, phải đo trên mẫu mới. Dữ liệu ấy phải giống tình huống dùng thật và chưa tham gia quyết định nào. Khớp train, chạy lại ra cùng kết quả, hay tốn ít thời gian đều trả lời những câu hỏi khác.
Câu 2
kNN regression dùng trọng số đều, có 80 mẫu train, và ta chọn . Hai điểm cần đoán khác nhau sẽ nhận dự đoán thế nào?
Khi bằng đúng số mẫu train, điểm nào cũng lấy cả 80 mẫu làm hàng xóm. Trọng số đều nên khoảng cách không còn tác dụng, và dự đoán luôn là trung bình của 80 nhãn.
Câu 3
Bài phân loại văn bản 10 lớp, có 5000 mẫu. Ba mô hình cho tỉ lệ đúng trên train và validation như sau. A là một mô hình rất đơn giản: 68% và 67%. B là một mô hình rất lớn, 2 triệu tham số: 99% và 71%. C là mô hình vừa phải, có regularization: 85% và 83%. Chẩn đoán nào đúng?
Underfit đi với bias cao, overfit đi với variance cao. A sai nhiều ở cả train lẫn validation, tức mô hình quá đơn giản. B gần như thuộc lòng train, nhưng validation chỉ hơn A 4 điểm. C chịu khớp train kém hơn B để có validation cao nhất, đúng tinh thần chọn theo validation của bài.
Câu 4
kNN regression với , chấm trên chính tập train. Khi nào thì lỗi train chắc chắn bằng 0?
Giả sử hai buổi cùng có nhưng nhãn là 1 và 3. Cả hai đều cách điểm cần đoán một khoảng 0, và mô hình chỉ trả về một trong hai nhãn cho cả hai điểm, nên lỗi train khác 0. Dữ liệu thật hay có những bản ghi trùng như vậy. Vì thế, kiểm “lỗi train có bằng 0 không” cũng là một cách kiểm dữ liệu.
Câu 5
Một hàm của scikit-learn báo điểm neg_mean_squared_error bằng . MSE bằng bao nhiêu?
scikit-learn quy ước điểm càng lớn càng tốt. Với những metric đo lỗi như MSE, nó trả về số đối để giữ quy ước ấy, nên tên mới có chữ neg. MSE thật là 0.12, và MSE thì không bao giờ âm.
Câu 6
Trên cùng một cách chia, kNN cho MSE trên train và validation như sau. : 0 và 0.48. : 0.07 và 0.21. : 0.25 và 0.29. Chỉ chọn trong ba giá trị này thì chọn nào?
có MSE validation 0.21, thấp nhất trong những giá trị đã thử. Hai lỗi gần nhau chưa đủ để chọn: có cả hai lỗi đều cao hơn.
Câu 7
Khi tăng độ phức tạp của mô hình, chẳng hạn tăng bậc đa thức trong hồi quy, bias và variance thường thay đổi thế nào?
Mô hình linh hoạt hơn thì ít bị ép vào một dạng cố định, nên bias giảm. Nhưng nó cũng nhạy hơn với từng bộ train, nên variance tăng. Trong bài, nhỏ của kNN là phía phức tạp, còn là phía đơn giản nhất.
Câu 8
Giữ nguyên validation, tăng train từ 100 lên 400 rồi 1600 mẫu. MSE trên train là 0.03, 0.07, 0.10. MSE trên validation là 0.50, 0.30, 0.18. Nếu còn kinh phí, ta nên làm gì?
Lỗi validation giảm rõ mỗi lần thêm dữ liệu. Lỗi train tăng lên một chút vì khó khớp hết nhiều mẫu hơn, và hai đường đang tiến lại gần nhau. Xu hướng này ủng hộ việc thu thêm mẫu, dù không hứa lỗi sẽ giảm mãi.
Câu 9
Một đội chia ngẫu nhiên train và validation 50 lần, rồi chỉ báo MSE nhỏ nhất trong 50 lần ấy. Làm vậy sai ở đâu?
MSE nhỏ nhất trong 50 lần đo là con số may mắn nhất, thấp hơn mức sẽ gặp trên mẫu mới. Chọn cách chia theo điểm cũng là một quyết định dựa trên dữ liệu. Nên báo cả dải kết quả của 50 lần, hoặc dùng một phép đánh giá độc lập.
Câu 10
Mô hình đạt điểm tốt khi chia ngẫu nhiên từng hàng. Có chắc nó cũng đoán tốt cho một trường chưa có trong dữ liệu không?
Chia ngẫu nhiên từng hàng thì trường nào cũng có buổi nằm trong train. Khi đó validation chỉ đo việc đoán thêm buổi của những trường đã quen. Muốn biết với trường mới, ta phải để riêng trọn một số trường, không cho trường nào trong số đó vào train.
Đọc thêm
- Dive into Deep Learning — Generalization. Đọc để nối empirical risk, nhiễu và sự khác nhau giữa fitting với generalization.
- James và cộng sự — An Introduction to Statistical Learning, chương 2 và 5. Đọc trực giác bias–variance và cách ước lượng lỗi dự đoán.
- scikit-learn — Validation curves và learning curves. Xem đúng trục của từng loại đường và quy ước score.