Lớp cuối của mạng phải hợp với loại đầu ra cần dự đoán. Đoán một số thực, như số phút làm bài, thì để nguyên đầu ra và dùng MSE; đoán có/không thì dùng sigmoid với binary cross-entropy; chọn một trong nhiều lớp thì dùng softmax với cross-entropy. Ghép sai thì code vẫn chạy và loss vẫn giảm, nhưng model đang học sai bài toán. Bài này học các activation thường dùng ở lớp ẩn và lớp cuối, và cách chọn loss theo ý nghĩa của nhãn.
Activation là một phép biến đổi có mục đích
MLP cần phi tuyến giữa các lớp. ReLU giữ phần dương, đặt phần âm về 0. Tanh đưa số về khoảng ; sigmoid đưa về . Hãy nhìn đồ thị trước khi thuộc tên: ReLU có một cổng mở hoặc đóng, còn tanh và sigmoid dần nằm ngang ở hai đầu. Khi đầu ra gần như không đổi dù đầu vào đổi, gradient cũng nhỏ.
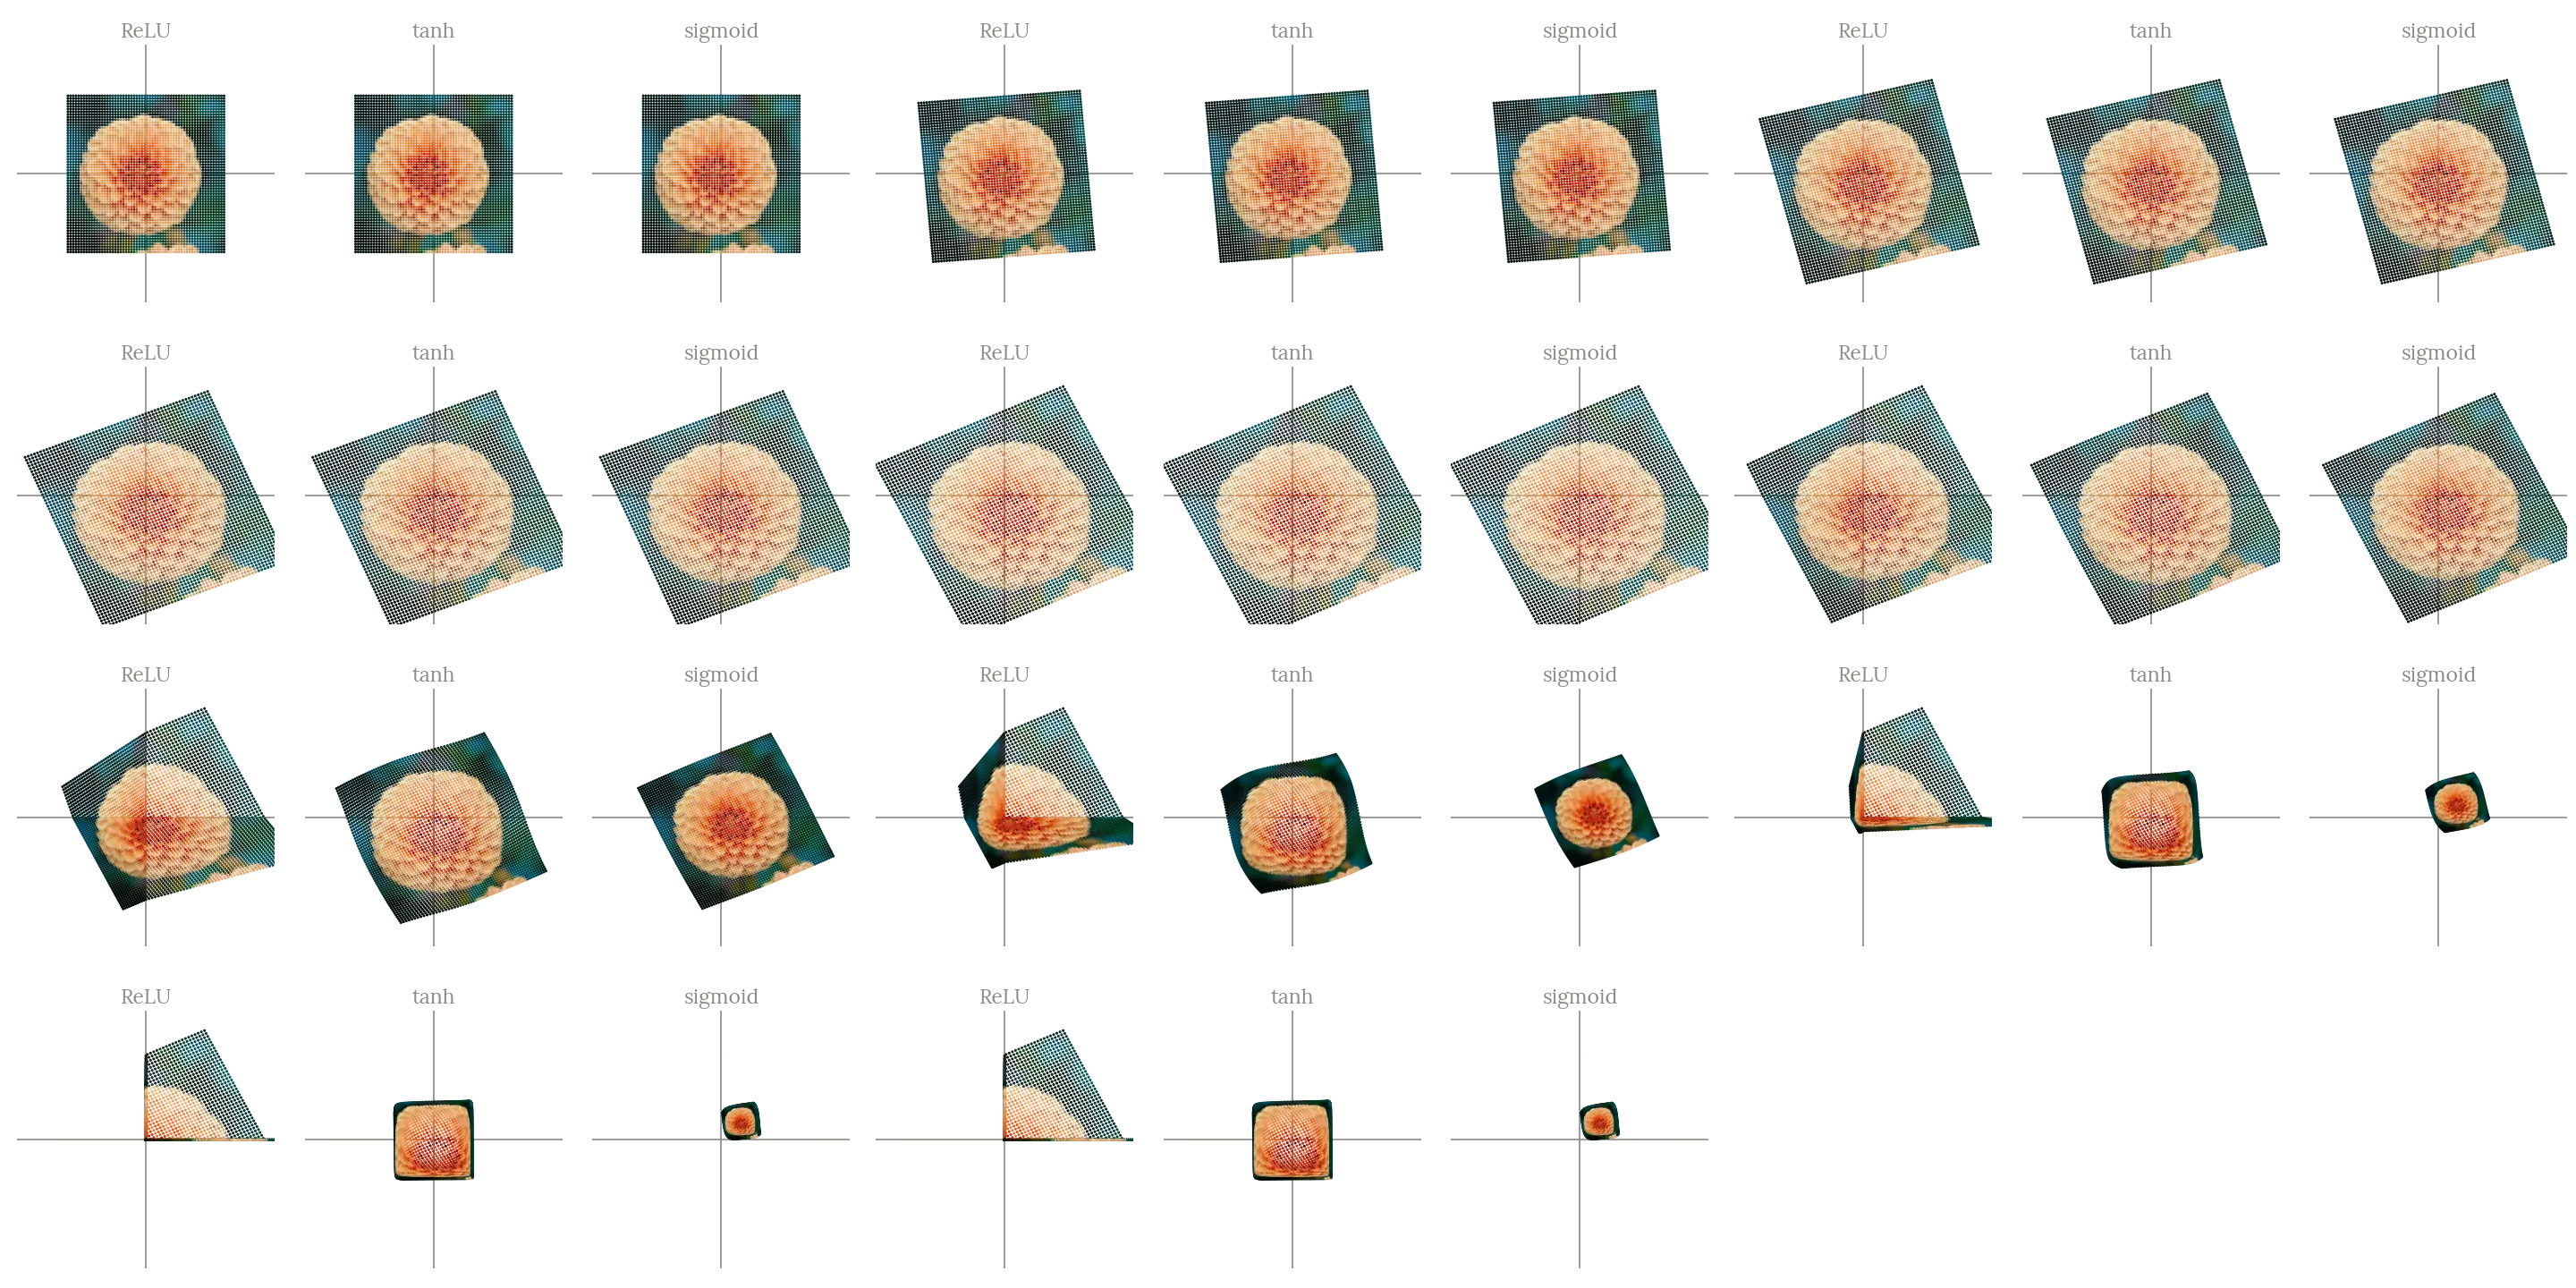
Các công thức là , và . Đạo hàm của sigmoid và tanh đọc được ngay từ đầu ra: , lớn nhất tại 0; , lớn nhất 1 tại 0. ReLU có đạo hàm 1 khi và 0 khi .
Ví dụ một nơ-ron có đầu vào , trọng số , bias 1: , ReLU cho 0. Sigmoid đang ra thì đạo hàm là . Đạo hàm tanh là , nên đi ngược qua tanh, gradient không bao giờ lớn thêm.
import numpy as np
import torch
from torch import nn
from torch.nn import functional as F

torch.set_num_threads(1)
torch.manual_seed(13)
z = torch.tensor([-10., 0., 10.], requires_grad=True)
torch.sigmoid(z).sum().backward()
print('sigmoid :', [round(v, 6) for v in torch.sigmoid(z).tolist()])
print("sigmoid':", [round(v, 6) for v in z.grad.tolist()])
z.grad = None                       # xóa gradient cũ trước lần backward thứ hai
torch.tanh(z).sum().backward()
print("tanh'   :", [round(v, 6) for v in z.grad.tolist()])
r = torch.tensor([-2., 0., 3.], requires_grad=True)
torch.relu(r).sum().backward()
print('relu    :', torch.relu(r).tolist(), "relu':", r.grad.tolist())
sigmoid : [4.5e-05, 0.5, 0.999955]
sigmoid': [4.5e-05, 0.25, 4.5e-05]
tanh' : [0.0, 1.0, 0.0]
relu : [0.0, 0.0, 3.0] relu': [0.0, 0.0, 1.0]
Hàng sigmoid' cho ở giữa và ở hai đầu; tanh' bằng 1 ở giữa và tròn về 0 trong float32 tại . Một neuron ẩn bão hòa (đầu ra nằm ở vùng phẳng) vì thế gần như ngừng học: mọi gradient đi qua nó bị nhân với một số gần 0.
Đây là độ nhạy của riêng activation, chưa có loss. Ở lớp đầu ra, sigmoid ghép với BCE cho đạo hàm theo logit rút gọn thành (kiểm ở mục nhị phân), nên bão hòa ở lớp cuối không gây cùng vấn đề.
ReLU không bão hòa ở phía dương và tính rất rẻ, vì thế là lựa chọn mặc định cho hidden layer.
Đổi lại, một neuron có pre-activation âm trên mọi mẫu, chẳng hạn sau một bước cập nhật quá lớn đẩy bias xuống rất âm, cho đầu ra 0 và gradient 0 cho chính trọng số của nó. Neuron ấy “chết” và không tự hồi lại. LeakyReLU, , giữ một độ dốc nhỏ phía âm để neuron vẫn nhận gradient. Khi nhiều neuron sigmoid đã bão hòa, giảm learning rate không giúp: gradient nhỏ vì đạo hàm của activation, không phải vì bước đi.
Hỏi nhanh
Một neuron ẩn dùng sigmoid có trên hầu hết các mẫu train. Trọng số đi vào neuron ấy được cập nhật thế nào?
, nên , và mọi gradient đi qua neuron đều bị nhân với số này. Phép rút gọn thành chỉ xảy ra khi sigmoid nằm ngay trước BCE ở lớp đầu ra, không áp dụng cho neuron ẩn. Gradient rất nhỏ nhưng vẫn khác 0, khác với ReLU chết có gradient đúng bằng 0.
Hỏi nhanh
ReLU không có đạo hàm tại . Vì sao huấn luyện bằng autograd vẫn chạy bình thường?
Output ở trên cho thấy PyTorch lấy đạo hàm bằng 0 tại 0. Mọi giá trị trong đều là một lựa chọn hợp lệ ở điểm gãy. Đạo hàm theo nghĩa thông thường không tồn tại tại 0, nên “bằng ” không phải sự thật, chỉ là một quy ước khác. Optimizer không xét từng mẫu, và float32 biểu diễn đúng được số 0.
Qua nhiều lớp: thang đo và khởi tạo
Một hidden layer tính với đầu vào (fan-in). Giả sử các trọng số độc lập, trung bình 0, phương sai , và độc lập với đầu vào. Khi đó các số hạng không tương quan với nhau và
Với ReLU và pre-activation đối xứng quanh 0, nửa âm bị đặt về 0 nên bằng một nửa phương sai pre-activation của lớp trước. Qua mỗi lớp, phương sai vì thế nhân với . Hệ số này lặp lại ở mọi lớp nên tác dụng là lũy thừa: nhỏ hơn 1 thì tín hiệu co theo cấp số nhân, lớn hơn 1 thì nổ. Backward đi qua chính các ma trận ấy (chuyển vị) và các mặt nạ ReLU, nên gradient về các lớp đầu cũng co hoặc nổ theo cùng cách.
Đặt hệ số bằng 1 cho
gọi là khởi tạo He (Kaiming), lựa chọn chuẩn cho mạng ReLU. Phương sai chỉ quyết định thang đo; bản thân các trọng số vẫn phải rút ngẫu nhiên, vì các neuron khởi tạo giống hệt nhau nhận cùng gradient và giống nhau mãi (bài 3.2).
Với activation khác:
- Tanh gần như là quanh 0 nên cần ; khởi tạo Xavier (Glorot) lấy trung bình fan-in và fan-out theo cùng tinh thần.
- Sigmoid còn thêm một hệ số: mỗi lớp nhân gradient với , nên chồng nhiều lớp sigmoid làm gradient của các lớp đầu tắt dần ngay cả khi trọng số vừa phải.
Vài ví dụ tính fan-in (số đầu vào của mỗi neuron):
- Lớp tuyến tính 512 đầu vào, theo He: .
- Lớp tích chập với 128 kênh vào (bài 5.1): fan-in , nên .
- Xavier dạng chuẩn dùng : lớp 300 vào, 100 ra có .
Cũng phép tính phương sai ấy cho thấy tích vô hướng của hai vector chiều độc lập, mỗi thành phần trung bình 0 và phương sai 1, có độ lệch chuẩn ; attention ở bài 3.9 chia cho vì vậy.
Thí nghiệm dưới đây dùng 10 lớp ReLU rộng 256, không bias, 512 mẫu đầu vào chuẩn. Hai cấu hình dùng cùng các ma trận ngẫu nhiên, chỉ khác hệ số nhân: hoặc He. Loss là trung bình đầu ra cuối, đủ để đo gradient chảy về lớp 1.
def depth_probe(std, depth=10, width=256):
    torch.manual_seed(0)                   # cùng dữ liệu và cùng ma trận cho mọi std
    h = torch.randn(512, width)
    weights = [(torch.randn(width, width) * std).requires_grad_() for _ in range(depth)]
    scales = []
    for w in weights:
        pre = h @ w                        # pre-activation, shape (512, 256)
        scales.append(pre.std().item())
        h = torch.relu(pre)
    h.mean().backward()                    # loss đơn giản để đo gradient về lớp 1
    return scales, weights[0].grad.norm().item()

scales_small, grad_small = depth_probe(0.01)
scales_he, grad_he = depth_probe((2 / 256) ** 0.5)
print('std pre-activation ở lớp 1, 4, 7, 10 và ‖grad W1‖:')
for name, scales, grad in [('N(0,0.01²)', scales_small, grad_small), ('He', scales_he, grad_he)]:
    print(f'{name:10s}', [float(f'{v:.2g}') for v in scales[::3]], f'{grad:.2g}')
std pre-activation ở lớp 1, 4, 7, 10 và ‖grad W1‖:
N(0,0.01²) [0.16, 0.00021, 3.1e-07, 4.9e-10] 2.8e-10
He [1.4, 1.3, 1.3, 1.4] 0.091
Lý thuyết dự đoán được các con số này. Với và , phương sai nhân mỗi lớp, tức độ lệch chuẩn nhân khoảng . Lớp 1 nhận đầu vào chuẩn nên có std ; sau chín lớp nữa còn , đúng như output. Gradient về lớp 1 nhỏ hơn bản He khoảng lần, nên mọi bước cập nhật gần như bằng 0 và loss đứng yên. Đầu ra không bằng 0, cũng còn rất xa giới hạn của float32 (cỡ ): tín hiệu chỉ bị co tới mức vô dụng.
Với He, std giữ quanh 1.4 ở mọi lớp.
Hai cấu hình khác nhau đúng hệ số ở mỗi lớp. Vì ReLU thuần nhất dương, với mọi , nên trong mạng không bias, nhân trọng số của một lớp với thì mọi lớp phía sau nhân đúng . Trên trục log, đường của vì thế gần như một đường thẳng đi xuống, cùng độ dốc ở mọi lớp.
nn.Linear của PyTorch mặc định lấy trọng số đều trong , tức độ lệch chuẩn , nhỏ hơn He. Với mạng ReLU sâu tự viết, gọi nn.init.kaiming_normal_(layer.weight, nonlinearity='relu') để giữ thang đo. BatchNorm (bài 3.6) và kết nối residual (bài 5.2) là hai cách khác giữ thang đo khi mạng rất sâu.
Hỏi nhanh
Mạng ReLU 10 lớp, không có bias. Giữ nguyên đầu vào, nhân mọi trọng số của cả 10 lớp với 2. Đầu ra cuối thay đổi thế nào?
, nên mỗi lớp nhân đầu ra thêm 2, và các hệ số nhân dồn lại thành . ReLU là hàm phi tuyến, nhưng tính chất này đủ để đoán chính xác. Cũng vì vậy mà khởi tạo với độ lệch chuẩn chỉ gấp đôi He đã làm tín hiệu tăng gấp đôi sau mỗi lớp. Có bias thì tính chất này không còn đúng chính xác.
Hỏi nhanh
Gradient đi ngược qua 10 lớp sigmoid. Bỏ qua trọng số, coi chúng bằng 1, thì tích các đạo hàm sigmoid trên đường đi lớn nhất là bao nhiêu?
Chain rule nhân các đạo hàm với nhau, không cộng. Mỗi thừa số , và chỉ đạt khi , nên tích không vượt quá . Sigmoid không phải lúc nào cũng bão hòa, và ngay cả khi không bão hòa, tích đã rất nhỏ. Trọng số lớn có thể bù hệ số này, nhưng lại đẩy ra xa 0 và gây bão hòa.
Hồi quy: đo mức sai bằng đơn vị
Đoán thời gian là hồi quy; đầu ra cuối thường để linear, không qua activation nào. Thêm sigmoid ở cuối là ép số phút vào mà không có lý do.
Với phần dư , MSE trung bình , MAE trung bình . MSE có đơn vị phút bình phương, MAE có đơn vị phút. MSE phạt một sai số 10 nặng gấp 25 lần sai số 2, còn MAE nặng gấp 5 lần: chọn loss là chọn mức phạt cho lỗi lớn.
Nếu model chỉ được đoán một hằng số, MSE chọn trung bình của target, còn MAE chọn trung vị; vài bài có thời gian bất thường vì thế kéo model MSE đi xa hơn nhiều.
prediction = torch.tensor([1., 5., 12.])
target = torch.tensor([2., 3., 2.])
assert prediction.shape == target.shape
print('residual:', (prediction - target).tolist())
print('MSE:', round(F.mse_loss(prediction, target).item(), 4))
print('MAE:', round(F.l1_loss(prediction, target).item(), 4))
print('per item:', F.mse_loss(prediction, target, reduction='none').tolist())
residual: [-1.0, 2.0, 10.0]
MSE: 35.0
MAE: 4.3333
per item: [1.0, 4.0, 100.0]
Phần dư cho MSE và MAE . Một mẫu cuối đóng phần lớn loss MSE. Kiểm reduction='none' giúp phát hiện một dòng dữ liệu bất thường thay vì chỉ nhìn con số trung bình.
Huber loss nối hai cách: gần 0 giống bình phương, xa giống trị tuyệt đối. Khi đề chấm MAE, train bằng L1 hoặc Huber thường khớp metric hơn MSE; chọn cụ thể bằng validation.
Hỏi nhanh
Đổi đơn vị nên target và dự đoán đều nhân 10. MSE thay đổi thế nào?
Phần dư nhân 10, bình phương của nó nhân 100. MAE thì chỉ nhân 10. Lấy trung bình không xóa được đơn vị, nên không so loss giữa hai thang đo chưa đổi về cùng đơn vị.
Hỏi nhanh
Năm bài có thời gian hoàn thành là 10, 12, 13, 15 và 90 phút. Nếu mô hình chỉ được đoán một hằng số, thì hằng số tốt nhất theo MSE và theo MAE lần lượt là bao nhiêu?
Tổng nhỏ nhất tại trung bình . Tổng nhỏ nhất tại trung vị 13. Một bài 90 phút kéo trung bình lên gấp đôi mức của bốn bài còn lại, còn trung vị gần như không đổi. Đề chấm MAE mà train bằng MSE thì mô hình bị kéo về phía những mẫu như vậy.
Nhị phân: đầu ra một logit
Đoán “cần đồ thị” dùng nhãn . Mạng cho một số thực , gọi là logit. Sigmoid biến thành xác suất . Logit 0 tương ứng xác suất 0.5; logit dương nghiêng về lớp 1, âm nghiêng về lớp 0. Logit không bắt buộc nằm trong khoảng 0–1.
Binary cross-entropy là . Nếu tự tính sigmoid rồi log với rất lớn, làm tròn có thể cho và gặp lỗi số. Dùng BCEWithLogitsLoss để ghép hai phép bằng dạng ổn định:
log1p tính ổn hơn khi rất nhỏ. Ta tự cài dạng này bằng NumPy rồi so thư viện:
logits_np = np.array([-2., 0., 2., -1000., 1000.])
labels_np = np.array([0., 1., 1., 0., 1.])
stable_bce = np.maximum(logits_np, 0) - logits_np * labels_np
stable_bce += np.log1p(np.exp(-np.abs(logits_np)))
logits = torch.tensor(logits_np, requires_grad=True)
labels = torch.tensor(labels_np)
individual = F.binary_cross_entropy_with_logits(logits, labels, reduction='none')
print(np.round(stable_bce, 6).tolist())
print('match:', np.allclose(stable_bce, individual.detach().numpy()))
individual.sum().backward()
print('gradient:', [round(v, 6) for v in logits.grad.tolist()])
[0.126928, 0.693147, 0.126928, 0.0, 0.0]
match: True
gradient: [0.119203, -0.5, -0.119203, 0.0, 0.0]
Loss tại hai logit cực lớn nhưng đoán đúng vẫn hữu hạn. Gradient của tổng loss theo từng logit là , nên tại nó là . Khi logit rất dương mà target là 0, gradient gần 1: mô hình sai rất tự tin vẫn nhận tín hiệu chỉnh rõ.
Từ đó có ba quy tắc cho lớp cuối của bài nhị phân:
- Lớp cuối là
nn.Linear(d, 1), không có sigmoid; sigmoid chỉ gọi lúc suy luận, khi cần xác suất. Ngưỡng 0.5 cho xác suất tương đương ngưỡng 0 cho logit. - Không đặt ReLU ngay trước đầu ra: logit không bao giờ âm nên , mô hình không thể đoán lớp 0.
nn.Linear(d, 2)đi với CrossEntropyLoss, không đi với BCEWithLogitsLoss.
Hỏi nhanh
Mô hình có nn.Sigmoid() ở lớp cuối, và đầu ra ấy lại được đưa vào BCEWithLogitsLoss. Với mẫu có nhãn 0, loss không bao giờ xuống dưới mức nào?
Hàm loss coi là logit. Với nhãn 0, loss là , luôn lớn hơn , giá trị đạt được khi . Vì vậy loss không bao giờ xuống 0. Con số là mức sàn của nhãn 1, khi . Code chạy im lặng, không báo lỗi gì; chỉ có loss đứng ở mức cao và xác suất đọc ra bị nén lại.
Nhiều lớp: mỗi hàng là một bộ logits
Chọn đúng một độ khó trong ba lớp là multi-class. Mạng trả (B, C) logits. Softmax theo chiều lớp tạo , tổng bằng 1. CrossEntropyLoss nhận logits và target là chỉ số lớp (B,) kiểu long; nó đã gộp sẵn log-softmax bên trong. (Loss này cũng nhận target là phân phối xác suất (B,C) kiểu float, dùng cho nhãn mềm; bài này dùng chỉ số lớp.)
Với logits , softmax là . Nếu nhãn đúng là 0, loss . Hai cách tính sau phải khớp:
scores = torch.tensor([[np.log(2.), 0.], [0., np.log(2.)]], dtype=torch.float64)
classes = torch.tensor([0, 1], dtype=torch.long)
probabilities = scores.softmax(dim=1)
hand_loss = -probabilities[torch.arange(2), classes].log().mean()
correct_loss = F.cross_entropy(scores, classes)
double_softmax_loss = F.cross_entropy(probabilities, classes)
print(probabilities.tolist())
print(round(hand_loss.item(), 6), round(correct_loss.item(), 6))
print('softmax twice:', round(double_softmax_loss.item(), 6))
print('prediction:', scores.argmax(dim=1).tolist())
[[0.6666666666666666, 0.3333333333333333], [0.3333333333333333, 0.6666666666666666]]
0.405465 0.405465
softmax twice: 0.540306
prediction: [0, 1]
Hai loss đầu bằng nhau; dòng “softmax twice” khác vì thư viện coi hai xác suất 2/3 và 1/3 như logits mới. Code vẫn chạy, nhưng biến đổi đã nén chênh lệch trước khi loss thực hiện log-softmax. Để lấy lớp có xác suất lớn nhất, scores.argmax(dim=1) đủ: softmax giữ thứ tự, không cần tốn thêm phép tính. Bài 10 lớp thì lớp ra có 10 neuron, mỗi neuron một logit.
Hỏi nhanh
Đầu ra (B, 3) là logits cho ba lớp loại trừ nhau. Ghép với hàm loss thế nào cho đúng?
CrossEntropyLoss đã gộp sẵn log-softmax bên trong. Đặt softmax hay sigmoid phía trước thì vẫn chạy, nhưng là giải một mục tiêu khác: dòng “softmax twice” cho 0.540 thay vì 0.405. Softmax rồi BCE vừa biến đổi hai lần, vừa bỏ mất ràng buộc chỉ có một lớp đúng.
Một mốc kiểm nhanh: khi mọi logit bằng nhau, mỗi lớp có xác suất và CE bằng . Model mới khởi tạo cho logits nhỏ nên loss ở batch đầu nằm gần mốc này: với ba mức khó, với mười lớp. Loss đầu tiên xa hẳn mốc thường báo logits khởi đầu quá lớn hoặc nhãn bị ghép sai.
Hỏi nhanh
Bài phân loại 10 lớp, mô hình vừa khởi tạo. CrossEntropyLoss mặc định, lấy trung bình, ở batch đầu tiên bằng 17.5. Nhận định nào hợp lý nhất?
Logits gần bằng nhau thì CE gần . Loss bằng 17.5 nghĩa là mô hình rất tự tin vào lớp sai, dấu hiệu logits lớn: khởi tạo quá to, đầu vào chưa chuẩn hóa, hoặc thiếu một phép chia thang đo. Batch đầu chưa qua bước cập nhật nào nên learning rate chưa có ảnh hưởng. CrossEntropyLoss nhận thẳng nhãn kiểu long.
Nhiều thuộc tính cùng lúc
Một bài có thể thuộc cả “đồ thị” lẫn “DP”: hai thuộc tính không loại trừ nhau. Khi đó mỗi thuộc tính là một nhãn nhị phân riêng, model cho (B,K) logits và BCEWithLogitsLoss với target float cùng shape. Softmax sẽ ép các thuộc tính tranh nhau tổng xác suất 1, trái với ý nghĩa “cả hai đều đúng”.
Khi suy luận, mỗi thuộc tính bật độc lập khi sigmoid của nó vượt ngưỡng; với ngưỡng 0.5, điều đó tương đương logit dương. Lấy argmax chỉ trả về một thuộc tính và làm mất đúng trường hợp “cả hai”.
Tóm lại bốn kiểu đầu ra của bài:
| Bài toán | Đầu ra model | Target thông thường | Loss |
|---|---|---|---|
| Hồi quy một số | (B,) float |
(B,) float |
MSE hoặc MAE |
| Nhị phân | (B,) logits |
(B,) float 0/1 |
BCEWithLogitsLoss |
| Một trong C lớp | (B,C) logits |
(B,) long |
CrossEntropyLoss |
| K thuộc tính độc lập | (B,K) logits |
(B,K) float 0/1 |
BCEWithLogitsLoss |
Tính tay với hai thuộc tính đều đúng và logits bằng 0: mỗi sigmoid là 1/2, mỗi BCE là . Reduction mean trên hai phần tử vẫn là , còn sum là . Mean chia cho số phần tử tham gia: với target (B,K), đó là , không phải .
Hai reduction chỉ khác nhau một hằng số nhân, nên có cùng điểm tối ưu; nhân loss với một hằng số dương không đổi nghiệm mà chỉ đổi độ lớn gradient. Với SGD, đổi reduction vì thế tương đương nhân learning rate với hằng số ấy.
Hỏi nhanh
Mô hình đa nhãn cho ba thuộc tính với logits , ngưỡng xác suất là 0.5. Những thuộc tính nào được dự đoán?
Sigmoid từng logit cho , và , nên hai thuộc tính có logit dương vượt ngưỡng. Argmax và softmax, cho , , , đều coi các thuộc tính loại trừ nhau, nên bỏ mất thuộc tính 2. Sigmoid luôn dương, nhưng ngưỡng là 0.5 chứ không phải 0.
Khi đi thi
- Model trả logits cho loss; chỉ gọi sigmoid hay softmax khi cần xuất xác suất.
- Kiểm loss ở batch đầu: lớp thì loss bắt đầu gần . Lệch xa thì xem lại logits và nhãn.
- Bài đa nhãn thì chọn ngưỡng cho từng thuộc tính trên validation, không giữ 0.5.
Tóm tắt
- Activation ở lớp ẩn tạo phi tuyến; đạo hàm của nó quyết định gradient đi qua được bao nhiêu. ReLU là mặc định; sigmoid, tanh bão hòa ở hai đầu.
- Khởi tạo phải giữ thang đo qua nhiều lớp: He cho ReLU.
- Hồi quy: đầu ra linear, loss MSE hoặc MAE (mức phạt lỗi lớn khác nhau).
- Nhị phân và đa nhãn: BCEWithLogitsLoss; nhiều lớp loại trừ nhau: CrossEntropyLoss. Cả hai nhận logits, không qua sigmoid hay softmax trước.
Kiểm tra cuối bài
Câu 1
Target hồi quy là số phút trong khoảng , không đổi thang đo. Vì sao lớp cuối dùng sigmoid không phù hợp?
Vấn đề nằm ở miền đầu ra: mô hình không thể đoán 30 hay 90 phút. Sigmoid có đạo hàm, MSE nhận mọi số thực, và target bằng 0 chỉ là một điểm ở biên. Lớp linear không ép miền giá trị. Nếu cần ràng buộc khác, chẳng hạn không âm, hãy thiết kế theo target rồi đổi ngược đơn vị.
Câu 2
Tại một điểm có . Đạo hàm của tại điểm ấy bằng bao nhiêu?
Lấy đạo hàm thương của được . là , quên lấy 1 trừ đi. là , quên bình phương. là , thiếu một lũy thừa.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 4.1
Câu 3
Một mạng ReLU 10 lớp được khởi tạo mọi trọng số theo . Loss gần như không đổi qua các epoch, còn đổi sang khởi tạo He thì mạng học được. Giải thích nào đúng?
Mỗi lớp nhân độ lệch chuẩn với , với là khoảng . Thí nghiệm trong bài cho độ lệch chuẩn ở lớp 10 cỡ , và gradient ở lớp 1 nhỏ hơn bản He khoảng lần. Đầu ra không bằng 0, vì nửa dương vẫn đi qua, và còn rất xa ngưỡng underflow của float32. Dấu của trọng số không phải vấn đề, vì He cũng có trọng số âm. He chọn để hệ số của mỗi lớp bằng 1.
Câu 4
Xét , với mọi , độc lập, và . Trường hợp (i): có trung bình 0, phương sai . Trường hợp (ii): , với đối xứng quanh 0 và có phương sai . Muốn , thì phải bằng bao nhiêu ở mỗi trường hợp?
Vì và các biến độc lập, , và số hạng độc lập cho . Ở trường hợp (i), , nên . Ở trường hợp (ii), ReLU chỉ giữ nửa dương, nên , và cần , đúng là khởi tạo He. là chia đôi sai chiều. và là phương sai chứ không phải độ lệch chuẩn.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 7.2
Câu 5
Dự đoán số người dự một sự kiện, với là số đoán và là số thật. Loss A bằng nếu , bằng nếu ngược lại. Loss B bằng nếu , bằng nếu ngược lại. Mọi hệ số đều dương. Loss B có tạo ra lựa chọn tối ưu nào mà loss A không tạo được không?
Chọn thì ở cả hai phía. Nhân loss với một hằng số dương không làm đổi điểm cực tiểu, chỉ đổi độ lớn của gradient, giống như đổi learning rate. Vì vậy chỉ tỉ lệ giữa hai phía là quan trọng. Đếm số tham số không quyết định được họ loss rộng hay hẹp. Loss A cũng phạt việc đoán thiếu, với hệ số 1.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q5(c)
Câu 6
Bài nhị phân. Mô hình A đưa hai logits vào CrossEntropyLoss. Mô hình B đưa một logit vào BCEWithLogitsLoss. bằng bao nhiêu thì B cho cùng xác suất lớp 1 và cùng loss với A?
Softmax hai lớp cho . CE bằng , đúng bằng BCE với logit 2. Vì vậy hai cách thiết kế đầu ra nhị phân là tương đương, và chỉ hiệu hai logits là có nghĩa. Ra 3 là bỏ qua , ra 4 là cộng thay vì trừ, còn là xác suất chứ không phải logit.
Phỏng theoCMU 10-601 · Exam 2 Practice · Q2.1
Câu 7
Sau một giai đoạn train với learning rate lớn, 40% neuron ReLU của một lớp ẩn cho ra 0 trên mọi mẫu train, và không hồi lại qua nhiều epoch. Đây là hiện tượng gì, và giảm nó bằng cách nào?
Pre-activation âm trên mọi mẫu, nên đầu ra và gradient vào trọng số, bias của neuron đều bằng 0. Không bước cập nhật nào kéo được nó trở lại. Learning rate lớn thường là thủ phạm đẩy bias xuống quá sâu. LeakyReLU giữ một độ dốc nhỏ ở phía âm, nên neuron vẫn nhận được gradient. Đây không phải overfitting. Tăng learning rate chỉ làm nặng thêm. Sigmoid thì đổi sang vấn đề bão hòa.
Câu 8
Bài đa nhãn: logits và targets cùng shape (B, K), target là 0 hoặc 1. Có ba cách viết loss:
# A
p = torch.sigmoid(logits)
loss_a = (-(targets * p.log() + (1 - targets) * (1 - p).log())).mean()
# B
loss_b = F.binary_cross_entropy_with_logits(logits, targets)
# C
q = torch.softmax(logits, dim=1)
loss_c = (-(targets * q.log()).sum(dim=1)).mean()
Dùng float32, và có logit lên tới 120. Nên dùng cách nào để train?
A đúng về toán và là cùng một hàm với B. Nhưng bị làm tròn thành đúng 1 trong float32, nên (1 - p).log() là . Với target 0, loss thành inf; với target 1 thì cho ra NaN. B dùng dạng , không bao giờ phải lấy log của 0. C ép các thuộc tính tranh nhau một tổng bằng 1, nên target không thể có hai xác suất bằng 1, sai với bài đa nhãn.
Phỏng theoNOAI 2026 Singapore · Chung kết · Câu 7
Câu 9
Mô hình đa nhãn train với batch (64, 5) và BCEWithLogitsLoss mặc định, tức reduction='mean'. Đổi sang reduction='sum', giữ nguyên SGD và learning rate. Bước cập nhật đầu tiên lớn gấp bao nhiêu lần?
Lấy trung bình là chia cho mọi phần tử tham gia, tức . Lấy tổng thì bỏ phép chia ấy, nên gradient và bước SGD nhân lên 320 lần. Ra 64 là nghĩ rằng trung bình chỉ chia theo batch size. Điểm tối ưu không đổi, nhưng bước đi thì đổi. Với Adam, bước gần như không đổi, vì Adam chia cho độ lớn của gradient (bài 3.5).
Câu 10
Một mẫu có nhãn lớp 0. Xác suất của hai mô hình lần lượt là A: và B: , cả hai đều đoán đúng theo argmax. So cross-entropy và accuracy trên mẫu này thế nào?
CE là của xác suất lớp thật: , nhỏ hơn . Accuracy chỉ nhìn nhãn thắng, nên trên mẫu này cả hai đều bằng 1. Đó là lý do loss có thể giảm trong khi accuracy đứng yên.
Đọc thêm
- PyTorch 2.9 — CrossEntropyLoss: tra quy ước logits, target index và reduction.
- PyTorch 2.9 — BCEWithLogitsLoss: đọc vì sao gộp hai phép ổn định hơn và cách dùng pos_weight.
- D2L — MLP: xem phi tuyến, activation và mạng nhiều lớp từ các ví dụ nhỏ.
- D2L — Numerical Stability and Initialization: vanishing/exploding gradient và lập luận phương sai dẫn tới Xavier.
- PyTorch 2.9 — torch.nn.init: tra
kaiming_normal_,xavier_uniform_và tham sốnonlinearity. - He, Zhang, Ren, Sun (2015) — Delving Deep into Rectifiers: bài báo gốc của khởi tạo He cho mạng ReLU sâu.
Nguồn ảnh: ảnh hoa là ảnh mẫu flower.jpg kèm scikit-learn (vultilion, Flickr, CC BY 2.0).