Autoencoder là mạng học cách nén dữ liệu thành ít số hơn rồi dựng lại dữ liệu ban đầu từ bản nén. Ví dụ bốn cảm biến cùng thay đổi theo mức hoạt động của máy thì có thể nén thành một số mà vẫn dựng lại gần đúng. Mẫu nào dựng lại sai nhiều là mẫu khác với dữ liệu đã học, nên autoencoder hay được dùng để phát hiện bất thường. Nhưng sai số dựng lại lớn chỉ là dấu hiệu cần kiểm, chưa phải kết luận máy hỏng.
Nén là một ràng buộc thông tin
Encoder đổi thành code ít chiều hơn; decoder đổi code thành . Training cực tiểu sai khác giữa input và reconstruction, trung bình trên batch mẫu, mỗi mẫu feature:
Code ít chiều, còn gọi là biểu diễn ẩn (latent), tạo nút thắt (bottleneck): model không đủ chỗ chép mọi chi tiết nên phải giữ cấu trúc chung. Ảnh chữ số nén về 32 chiều là bớt từ 784 xuống 32 số, khoảng 24.5 lần. Với ảnh, lỗi MSE cộng nút thắt hẹp thường làm ảnh tái tạo mờ: chi tiết nào không giữ được, model trả trung bình của chúng.
Nếu latent rộng bằng input hoặc encoder/decoder quá mạnh, model có thể học phép chép lại và tái tạo tốt cả mẫu lạ; vì vậy loss tái tạo nhỏ không tự chứng minh code hữu ích. Autoencoder bỏ thông tin theo loss, nên có thể bỏ luôn thứ mà một nhiệm vụ khác cần.
Hai nửa của model có thể chạy ở hai nơi. Khi nén để truyền, thiết bị chạy encoder và chỉ gửi ; nơi nhận giữ decoder để dựng . Khi phát hiện bất thường, hai nửa chạy liền nhau, vì score phải so với chính .
Hỏi nhanh
Một trạm có 100 cảm biến, đường truyền chỉ đủ gửi 8 số mỗi giây, còn máy chủ cần dựng lại đủ 100 số. Dùng autoencoder thế nào?
Chỉ gồm 8 số mới vừa đường truyền, và decoder phải đặt ở nơi cần 100 số. Gửi vẫn tốn 100 số. Gửi 8 cảm biến đầu là bỏ hẳn 92 cột, thay vì nén thông tin của cả 100. Đảo vai thì sai cả shape, vì decoder nhận 8 số chứ không nhận 100.
Dữ liệu có một cấu trúc biết trước
Ta sinh bốn cảm biến cùng phụ thuộc một số : cộng nhiễu nhỏ. Cấu trúc sạch thật sự chỉ có một bậc tự do, nên nén về một chiều có lý do. Train, validation và test được sinh riêng; mean/std chỉ lấy train. Các vector không bị ép vào 0–1, vì vậy decoder cuối để linear, không dùng sigmoid.
import numpy as np
import torch
from torch import nn

torch.set_num_threads(1)
torch.manual_seed(43)
g = torch.Generator().manual_seed(43)
direction = torch.tensor([1., 2., -1., .5])

def make_normal(n):
    t = torch.randn(n, 1, generator=g)
    clean = t * direction
    noisy = clean + .03 * torch.randn(n, 4, generator=g)
    return clean, noisy

clean_train, raw_train = make_normal(128)
_, raw_valid = make_normal(48)
_, raw_normal_test = make_normal(32)
_, raw_anomaly_test = make_normal(16)
raw_anomaly_test[:, 1] += 1.5
mean = raw_train.mean(dim=0)
scale = raw_train.std(dim=0, unbiased=False).clamp_min(1e-6)
train = (raw_train - mean) / scale
valid = (raw_valid - mean) / scale
test = (torch.cat([raw_normal_test, raw_anomaly_test]) - mean) / scale
test_labels = torch.cat([torch.zeros(32), torch.ones(16)]).long()
print(tuple(train.shape), tuple(valid.shape), tuple(test.shape))
(128, 4) (48, 4) (48, 4)
Các mẫu bất thường (anomaly) được tạo bằng cách lệch riêng cảm biến thứ hai. Đây là định nghĩa bất thường trong bộ mô phỏng này. Trong dữ liệu thật, nhãn hoặc hiểu biết chuyên môn phải quyết định điều gì đáng báo; một giá trị xa trung bình vẫn có thể là hoạt động hợp lệ.
Chuẩn hóa quan trọng vì MSE cộng theo feature: cảm biến có đơn vị lớn sẽ chi phối nếu không chọn thang đo hợp lý.
Hỏi nhanh
Target của autoencoder đã chuẩn hóa z-score, nên có giá trị âm và giá trị lớn hơn 1. Vì sao decoder để lớp cuối linear lại hợp hơn sigmoid?
Activation cuối phải phủ được miền của target. Target z-score có số âm và số lớn hơn 1, mà sigmoid không bao giờ cho ra được, nên lỗi tái tạo có một mức sàn không giảm nổi. Sigmoid vẫn có gradient khi input âm, chỉ nhỏ dần khi rất âm. Bias không liên quan tới việc tính MSE. Activation cuối cũng không quyết định khả năng phát hiện bất thường.
Tính thử với một encoder đặt tay. Với hai cảm biến sạch trên đường , chọn encoder và decoder . Mẫu tái tạo đúng. Mẫu cho , tái tạo , MSE . Phép chiếu bỏ phần lệch khỏi cấu trúc chung.
Nếu một mẫu lạ vẫn nằm trên đường ấy, ví dụ , công thức trên tái tạo đúng. Một anomaly về độ lớn dọc cấu trúc có thể không được reconstruction error phát hiện. Đây là giới hạn cần hiểu trước khi gọi model là bộ phát hiện bất thường.
Hỏi nhanh
Vẫn dùng encoder và decoder . Xếp ba mẫu A , B , C theo MSE tái tạo, từ lớn đến nhỏ.
A nằm đúng trên đường , nên lỗi bằng 0, dù xa gốc nhất. B được tái tạo thành , lỗi là . C được tái tạo thành , lỗi là . Tổng quát, lỗi bằng : score đo độ lệch khỏi đường, không đo độ lớn. Xếp A đầu tiên là nhầm score với khoảng cách tới gốc.
Tự cài baseline PCA trước
Với dữ liệu đã trừ mean, PCA một chiều chính là một autoencoder tuyến tính viết sẵn: encoder chiếu lên hướng chính (vector đơn vị), decoder chiếu ngược. Theo định lý Eckart–Young, trong mọi cách nén tuyến tính về chiều rồi dựng lại, thành phần chính đầu tiên cho MSE trên train nhỏ nhất.
Vì vậy PCA vừa là baseline vừa là cận dưới cho autoencoder tuyến tính: mạng tối ưu tốt sẽ học cùng phép chiếu, dù latent của nó có thể bằng tọa độ PCA nhân một hệ số khác 0.
train_np = train.numpy()
_, singular_values, vt = np.linalg.svd(train_np, full_matrices=False)
axis = vt[0]
latent_np = train_np @ axis
reconstruction_np = latent_np[:, None] * axis[None, :]
print('PCA latent shape:', latent_np.shape)
print('PCA train MSE:', round(float(np.mean((reconstruction_np - train_np) ** 2)), 6))
print('variance fraction:', round(float(singular_values[0] ** 2 /
                                       np.sum(singular_values ** 2)), 6))
PCA latent shape: (128,)
PCA train MSE: 0.001006
variance fraction: 0.998994
Hai số ăn khớp nhau. Sau chuẩn hóa, mỗi cột có phương sai 1, tổng phương sai là 4; MSE trung bình trên bốn cột đúng bằng phần phương sai bị bỏ: . Tỉ lệ giữ lại cao phù hợp thiết kế một biến điều khiển bốn cảm biến.
Nhưng phương sai lớn chưa chắc mang thông tin cho nhãn (bài 2.9): nhãn có thể phụ thuộc đúng một hướng ít phương sai mà phép nén đã bỏ. Baseline này kiểm mục tiêu reconstruction, không thay cho đánh giá của nhiệm vụ dùng code về sau.
Hỏi nhanh
Hai linear autoencoder không bias cho cùng một reconstruction trên mọi mẫu, nhưng latent của model B luôn gấp đôi latent của model A. Điều này có mâu thuẫn không?
Output là . Nhân với 2 và chia cho 2 thì tích không đổi. Vì vậy reconstruction không xác định duy nhất tọa độ latent, kể cả ở nghiệm tối ưu; tọa độ PCA chỉ là một cách chọn thang. Latent gấp đôi chỉ làm output gấp đôi khi decoder giữ nguyên. Seed cũng không phải nguồn duy nhất làm latent khác nhau.
Hỏi nhanh
Dữ liệu 5 cột đã chuẩn hóa, mỗi cột có phương sai 1. PCA giữ 2 thành phần, giải thích được 90% phương sai. MSE tái tạo trên train, lấy trung bình theo mẫu và theo cột, bằng bao nhiêu?
Tổng phương sai là 5, phần bị bỏ là . Chia cho 5 cột được , đúng bằng như ví dụ của bài. 0.5 là tổng bình phương lỗi của mỗi mẫu, chưa chia cho số cột. 0.02 là chia cho 5 hai lần. 0.9 là phần được giữ, không phải phần mất.
Học encoder/decoder bằng PyTorch
Ta dùng mạng linear không bias, vì dữ liệu đã center theo train và cấu trúc thật chỉ có một bậc tự do. Muốn học cấu trúc cong, autoencoder cần tầng ẩn có activation như ReLU; xếp thêm tầng linear mà không có activation chỉ tạo ra một phép tuyến tính khác, không vượt được PCA. Với dữ liệu thẳng như ở đây, mạng nhỏ nhất là đủ để kiểm pipeline.
class LinearAutoencoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Linear(4, 1, bias=False)
        self.decoder = nn.Linear(1, 4, bias=False)

    def forward(self, x):
        return self.decoder(self.encoder(x))

autoencoder = LinearAutoencoder()
optimizer = torch.optim.Adam(autoencoder.parameters(), lr=.03)
initial_loss = (autoencoder(train) - train).square().mean().item()
for _ in range(300):
    autoencoder.train()
    optimizer.zero_grad(set_to_none=True)
    reconstructed = autoencoder(train)
    assert reconstructed.shape == train.shape
    loss = (reconstructed - train).square().mean()
    loss.backward()
    optimizer.step()
autoencoder.eval()
with torch.no_grad():
    final_loss = (autoencoder(train) - train).square().mean().item()
    valid_loss = (autoencoder(valid) - valid).square().mean().item()
    codes = autoencoder.encoder(valid)
print('train MSE:', round(initial_loss, 6), '->', round(final_loss, 6))
print('validation MSE:', round(valid_loss, 6))
print('latent:', tuple(codes.shape))
train MSE: 0.22791 -> 0.001038
validation MSE: 0.00094
latent: (48, 1)
Train MSE giảm từ 0.22791 xuống 0.001038, chỉ cao hơn cận dưới PCA 0.001006 khoảng 3%: 300 bước Adam đã tới rất gần phép chiếu tối ưu. Validation 0.00094 thấp hơn train một chút; với 48 mẫu, chênh lệch cỡ này là dao động ngẫu nhiên của nhiễu, không phải dấu hiệu rò rỉ.
codes có shape (48,1), một số mỗi mẫu; dấu và thang của nó có thể đổi theo seed, nên khi dùng code làm feature cho clustering hay classifier, phải đánh giá lại trên split của nhiệm vụ ấy.
Hỏi nhanh
Sau khi train lâu hơn, một bạn báo linear autoencoder không bias đạt MSE 0.0009 trên train, trong khi trên đúng tập train ấy, PCA một chiều cho 0.001006. Nên nghĩ gì trước tiên?
Theo định lý Eckart–Young, không phép nén rồi dựng tuyến tính một chiều nào có MSE trên train nhỏ hơn PCA, dù có bao nhiêu weight hay dùng optimizer nào. Một con số thấp hơn cận dưới là dấu hiệu đo sai: tính trên tập khác, chuẩn hóa khác, hay chia cho mẫu số khác. Mạng có thể chạm cận dưới nhưng không vượt qua được. Còn “gấp đôi” thì không có cơ sở, vì bài vừa đo được 0.001038 so với 0.001006.
Từ reconstruction error tới ngưỡng báo
Bài toán này gọi là phát hiện bất thường (anomaly detection): hợp khi gần như chỉ có dữ liệu bình thường, còn lỗi thì hiếm và mỗi lần một kiểu, như máy hỏng, vết xước trên dây chuyền hay giao dịch gian lận.
Tính lỗi cho từng mẫu, trung bình theo feature, không gộp mất chiều batch. Chọn ngưỡng trên validation bình thường, chẳng hạn phân vị 95%; đây là cách đặt mức báo tương đối, không bảo đảm tỉ lệ báo nhầm đúng 5% trên mọi test. Validation nhỏ làm ngưỡng dao động; dữ liệu lệch phân phối có thể tăng số báo sai.
Cách cổ điển hơn là khớp một phân phối chuẩn cho từng đặc trưng rồi báo khi ; càng lớn thì càng ít bỏ sót nhưng càng báo nhầm nhiều.
def reconstruction_error(model, x):
    model.eval()
    with torch.no_grad():
        return (model(x) - x).square().mean(dim=1)

valid_error = reconstruction_error(autoencoder, valid)
threshold = torch.quantile(valid_error, .95).item()
test_error = reconstruction_error(autoencoder, test)
flag = test_error > threshold
true_positive = (flag & test_labels.eq(1)).sum().item()
false_positive = (flag & test_labels.eq(0)).sum().item()
false_negative = ((~flag) & test_labels.eq(1)).sum().item()
print('threshold:', round(threshold, 6))
print('normal/anomaly median error:', round(test_error[:32].median().item(), 6),
      round(test_error[32:].median().item(), 6))
print('TP FP FN:', true_positive, false_positive, false_negative)
threshold: 0.002907
normal/anomaly median error: 0.000808 0.106747
TP FP FN: 16 2 0
Hai median cách nhau hơn trăm lần (0.000808 so với 0.106747), nên score tách hai nhóm rất rõ. Ngưỡng bắt đủ 16 mẫu bất thường (FN = 0) và báo nhầm 2 trong 32 mẫu bình thường, tức 6.25%, gần mức 5% mà phân vị 95% nhắm tới; với 32 mẫu, mỗi mẫu đã là hơn 3 điểm phần trăm.
Nhãn test chỉ dùng để chấm, không dùng chọn ngưỡng. Nếu có validation chứa anomaly đã gắn nhãn, chọn ngưỡng tối đa F1 trên đó cũng hợp lệ, nhưng khi ấy bài toán đã dùng nhãn, không còn là phát hiện bất thường không giám sát.
Trên thang log, nhóm bất thường nằm cách ngưỡng hơn một bậc độ lớn, còn ngưỡng nằm sát đuôi của nhóm bình thường. Vì vậy dời ngưỡng trong vùng này chủ yếu đổi số FP, hầu như không đổi TP.
Hỏi nhanh
Bình phương sai số reconstruction có shape (B, 4). Muốn mỗi mẫu có một MSE anomaly score, phải gộp theo chiều nào?
Score của một mẫu gộp 4 feature của chính hàng ấy, nên lấy mean theo dim=1 và giữ lại số để so với ngưỡng. Gộp theo dim=0, dù là mean hay sum chia cho , cho ra lỗi trung bình của từng feature trên cả batch. Mean trên mọi chiều là loss của batch, cần khi train nhưng không xếp hạng được từng mẫu.
Hỏi nhanh
Đổi ngưỡng từ phân vị 95% lên phân vị 99% của cùng một tập validation, giữ nguyên model. Trên cùng tập test, câu nào về TP và FP luôn đúng?
Ngưỡng cao hơn thì tập mẫu bị đánh dấu chỉ có thể co lại, nên cả TP lẫn FP đều không tăng: báo nhầm ít hơn, đổi lại có thể bỏ sót thêm bất thường. Ba phương án còn lại đều khẳng định có ít nhất một số không giảm, điều chỉ đúng khi không có mẫu nào nằm giữa hai ngưỡng. Ở bài này, nhóm bất thường nằm xa ngưỡng, nên nâng ngưỡng chủ yếu là bớt FP.
Denoising thay target của việc học
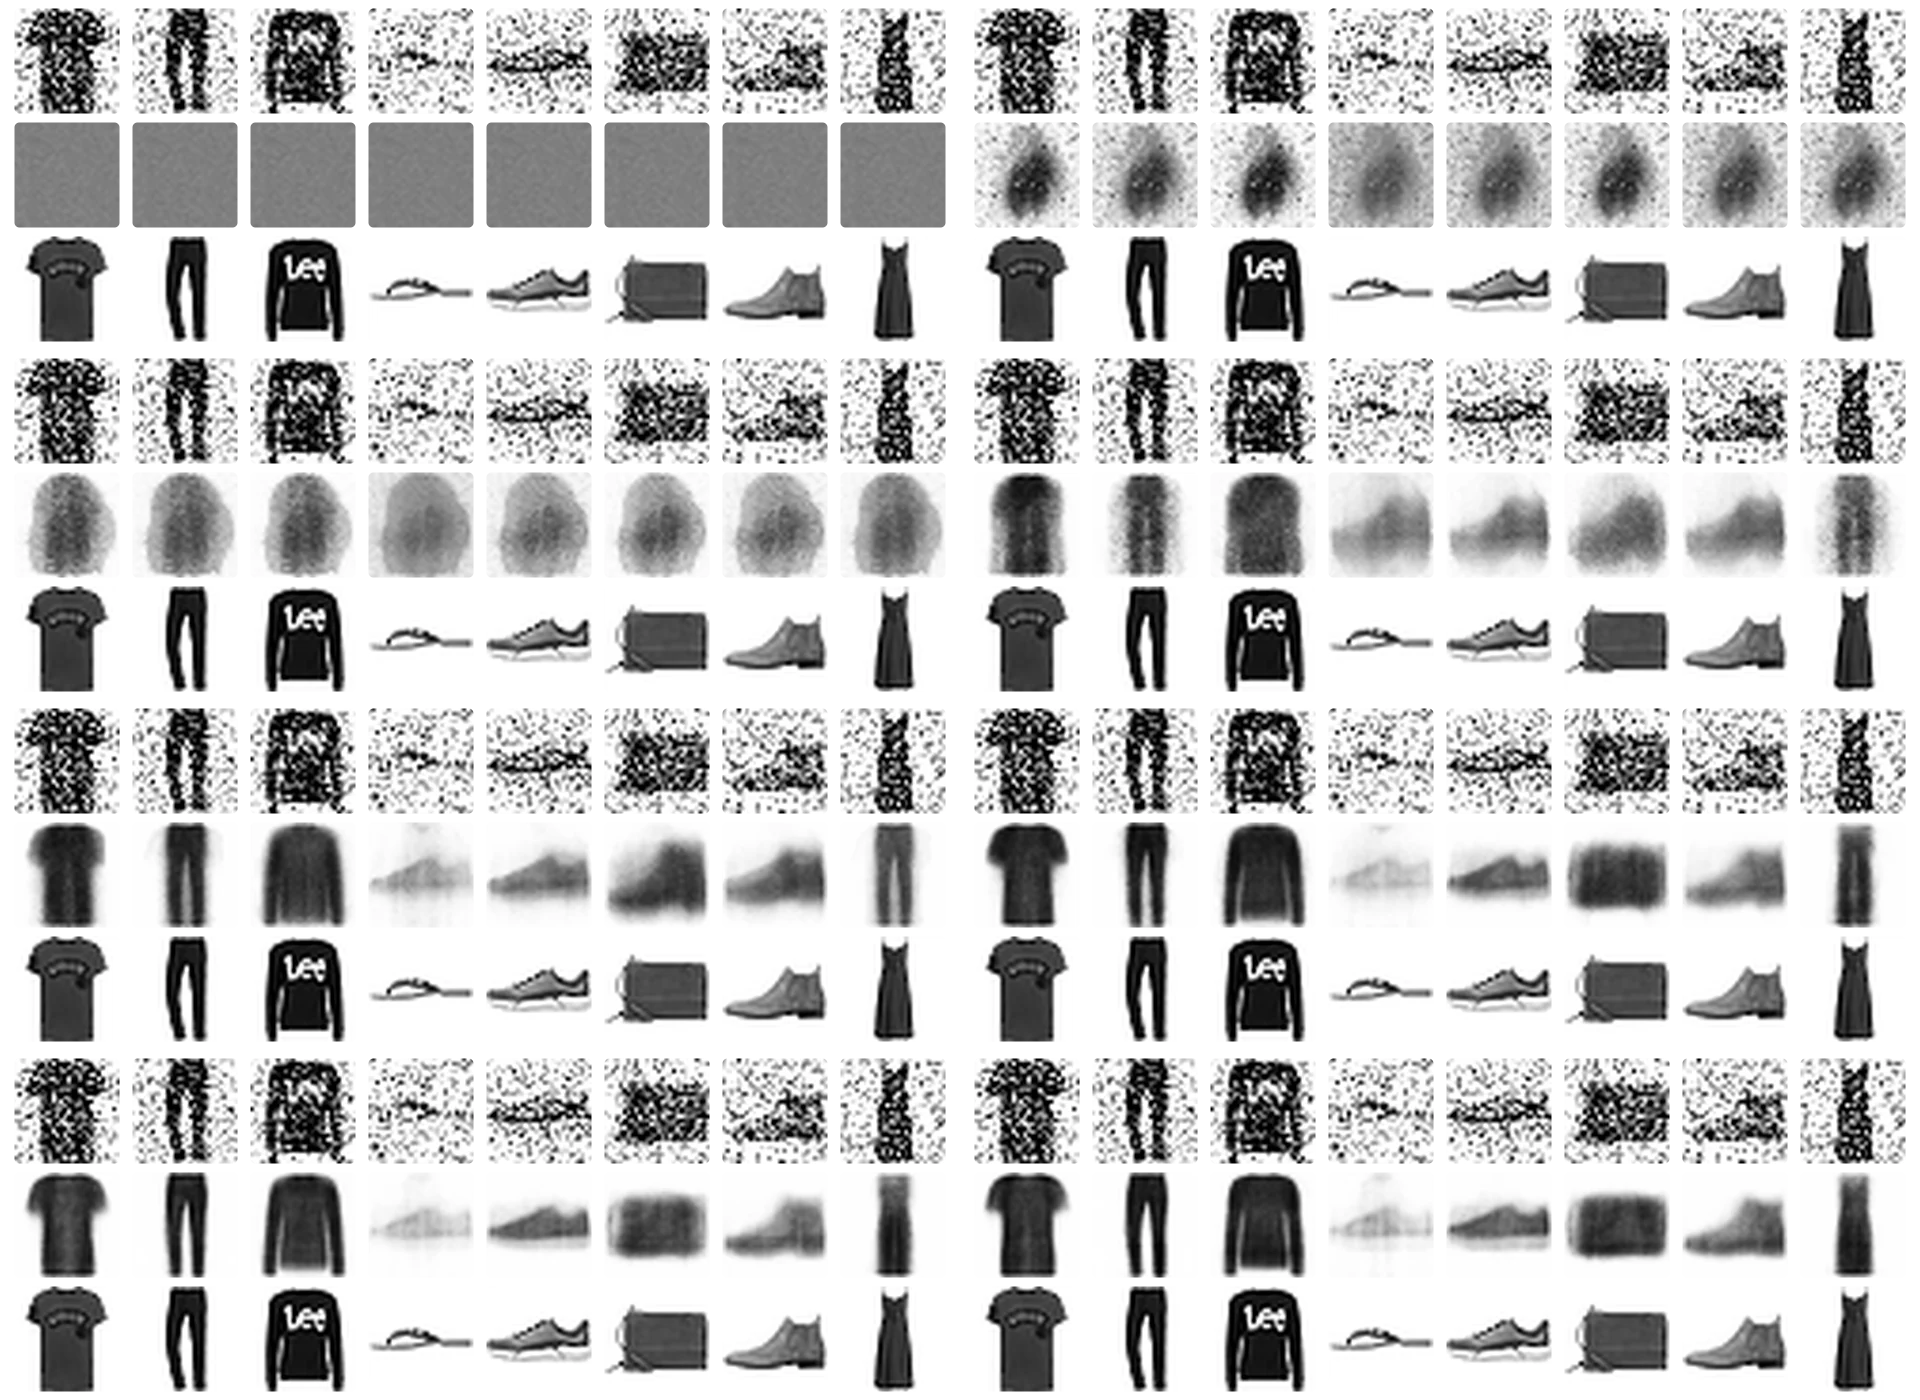
Autoencoder thông thường nhận và tái tạo ; denoising autoencoder nhận bản bị nhiễu nhưng target là sạch. Nếu target cũng nhiễu, model được thưởng khi giữ nhiễu. Lọc tiếng gõ phím, tiếng quạt mà giữ giọng nói trong ứng dụng họp trực tuyến là cùng bài toán trên âm thanh. Khi có cặp noisy/clean hoặc cơ chế mô phỏng nhiễu hợp lệ, ta cực tiểu .
Mô phỏng có sẵn clean_train, nên mỗi step ta tạo một bản nhiễu mới với độ lệch chuẩn 0.15 trên thang đã chuẩn hóa; model không thể học thuộc một bản nhiễu cố định. Đánh giá trên 24 cặp clean/noisy mới, dùng lại mean/std của train, và so với cách đơn giản nhất là giữ nguyên noisy input:
torch.manual_seed(47)
denoiser = LinearAutoencoder()
denoise_optimizer = torch.optim.Adam(denoiser.parameters(), lr=.03)
clean_scaled = (clean_train - mean) / scale
noise_generator = torch.Generator().manual_seed(47)
for _ in range(200):
    corrupted = clean_scaled + .15 * torch.randn(clean_scaled.shape, generator=noise_generator)
    denoise_optimizer.zero_grad(set_to_none=True)
    loss = (denoiser(corrupted) - clean_scaled).square().mean()
    loss.backward()
    denoise_optimizer.step()
clean_eval, _ = make_normal(24)
clean_eval = (clean_eval - mean) / scale
noisy_eval = clean_eval + .15 * torch.randn(clean_eval.shape, generator=noise_generator)
denoiser.eval()
with torch.no_grad():
    baseline = (noisy_eval - clean_eval).square().mean().item()
    denoised = (denoiser(noisy_eval) - clean_eval).square().mean().item()
print('noisy input MSE:', round(baseline, 6))
print('denoised MSE:', round(denoised, 6))
noisy input MSE: 0.019573
denoised MSE: 0.005335
Lỗi giảm từ 0.019573 xuống 0.005335, khoảng 3.7 lần. Hình học giải thích con số này: nhiễu Gaussian đẳng hướng rải đều năng lượng lên cả bốn chiều, còn tín hiệu sạch nằm trên một đường. Chiếu lên đường ấy chỉ giữ lại khoảng năng lượng nhiễu, , gần mức 0.005335 đo được.
Cơ chế này cần hai điều kiện: cấu trúc sạch ít chiều, và nhiễu lệch khỏi cấu trúc ấy. Với một dạng nhiễu khác, hoặc dữ liệu có chi tiết thật nằm ngoài cấu trúc đã học, phải đo lại trên đúng dữ liệu đó: phép chiếu xóa mọi thứ lệch khỏi đường, kể cả chi tiết thật.
Hỏi nhanh
Một đội viết vòng train denoising, nhưng dòng loss lại là loss = (model(corrupted) - corrupted).square().mean(). Mục tiêu học đã thành gì?
Target là chính input có nhiễu, nên đây chỉ là autoencoder thông thường trên dữ liệu nhiễu: model được thưởng khi dựng lại được cả nhiễu. Nút thắt hẹp có thể tình cờ bỏ bớt một phần nhiễu, nhưng loss không còn đòi điều đó nữa, và latent rộng thì sẽ chép nguyên nhiễu. Muốn dự đoán phần nhiễu thì target phải là corrupted - clean. Loss chỉ bằng 0 khi model đã thành phép đồng nhất.
Hỏi nhanh
Tín hiệu sạch nằm trên một mặt phẳng 2 chiều trong không gian 10 chiều. Nhiễu Gaussian đều theo mọi hướng cho MSE 0.05 so với bản sạch. Chiếu đúng lên mặt phẳng ấy thì MSE còn khoảng bao nhiêu?
Nhiễu đều theo mọi hướng thì chia đều năng lượng cho 10 chiều. Phép chiếu giữ lại 2 chiều, tức giữ , nên còn . 0.04 là nhầm phép chiếu bỏ 2 chiều thay vì giữ 2 chiều. 0.005 là chỉ giữ một chiều. 0.025 là chia đôi theo cảm tính. Đây là trường hợp lý tưởng; một denoiser thật còn phải cộng thêm sai số khi học ra mặt phẳng.
Khi đi thi
- Đề chấm AUC hay average precision thì nộp score liên tục; đề chấm F1 thì chọn ngưỡng trên validation.
- Chạy PCA trước: vài giây trên CPU, và autoencoder chỉ đáng giữ khi thắng nó.
- Kiểm chiều của score: đề quy ước score lớn là bất thường hay ngược lại.
Tóm tắt
- Autoencoder học nén rồi dựng lại; loss quyết định thông tin nào được giữ.
- Autoencoder tuyến tính tối ưu học đúng phép chiếu PCA, nên PCA vừa là baseline vừa là cận dưới MSE.
- Lỗi tái tạo là một điểm số: cần ngưỡng chọn trên validation và đánh giá bằng FP/FN; lỗi lớn chưa phải kết luận máy hỏng.
- Denoising dùng input nhiễu và target sạch, và chỉ được kiểm trên đúng loại nhiễu đã đo.
Kiểm tra cuối bài
Câu 1
Một autoencoder tuyến tính một chiều dùng encoder , với là vector đơn vị cùng hướng với . Với , latent bằng bao nhiêu?
, và , nên . Ra 25 là quên chuẩn hóa hướng. là hệ số của chưa chuẩn hóa trong bản tái tạo, không phải tọa độ trên vector đơn vị. là do sai dấu ở tích .
Câu 2
Tiếp Câu 1, decoder dựng . Vector sai số tái tạo là gì?
, nên . Kiểm nhanh: , phần dư vuông góc với hướng chính, đúng như một phép chiếu. là chính bản tái tạo. là , ngược dấu. là do tích vô hướng bị sai dấu, ra 9.
Câu 3
Một đội muốn nén mạnh hơn. Trên cùng một tập train đã trừ trung bình, họ đổi PCA từ thành phần, với MSE tái tạo , xuống thành phần đầu, với MSE . Câu nào luôn đúng?
Mỗi thành phần chính gánh một phần phương sai không âm, bằng trị riêng . Bỏ nó đi thì phần ấy chuyển sang lỗi tái tạo: , và chỉ bằng 0 khi . Chuẩn hóa không làm trị riêng bằng 0, và PCA không dùng nhãn. Với autoencoder học bằng SGD, “luôn” chỉ đúng khi cả hai model đã tới nghiệm tối ưu; hai lần train dở dang có thể cho thứ tự ngược lại.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q9.2(i)
Câu 4
Trong một bộ dữ liệu, phương sai lớn nhất nằm theo hướng , còn nhãn chỉ phụ thuộc vào hướng , nơi phương sai rất nhỏ. Lấy latent của một autoencoder tuyến tính một chiều đã train tốt làm feature duy nhất cho classifier. Kết quả dễ thấy nhất là gì?
Autoencoder tuyến tính tối ưu học ra phép chiếu PCA: giữ hướng phương sai lớn , bỏ , và thông tin về nhãn mất đúng ở chỗ ấy. Mục tiêu reconstruction không nhìn thấy nhãn, nên không có lý do gì để giữ . Giữ nhiều phương sai không có nghĩa là giữ thông tin cho nhãn. Latent một chiều không phải lúc nào cũng vô dụng: nếu nhãn phụ thuộc vào thì nó là đủ.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q9.2(iii)
Câu 5
Trên dữ liệu 20 cột đã trừ trung bình, một đội giữ đủ cả 20 thành phần PCA, rồi lấy lỗi tái tạo của từng mẫu làm score bất thường. Kết quả là gì?
PCA không bắt buộc phải giữ ít chiều hơn input: giữ tới đúng 20 thành phần vẫn được, và PCA(n_components=20) chạy bình thường. Khi đó 20 vector trực chuẩn tạo thành một cơ sở của cả không gian, , nên với mọi mẫu. Mẫu bất thường cũng là một vector trong không gian ấy, nên cũng được dựng đúng, score chỉ còn sai số làm tròn. Giữ đủ phương sai là nén không mất mát, nhưng xóa luôn tín hiệu cần đo: lỗi tái tạo chỉ phân biệt được các mẫu khi có nút thắt. Autoencoder có latent rộng bằng hoặc hơn input cũng gặp đúng chuyện này khi học được phép đồng nhất. Cách sửa là thu hẹp latent, hoặc dùng denoising hay regularization để model không chép thẳng được.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q9.2(iv)
Câu 6
Hai cảm biến: nhiệt độ đo bằng °C, độ lệch chuẩn khoảng 2, và áp suất đo bằng Pa, độ lệch chuẩn khoảng 500. Train autoencoder trên số liệu thô với MSE. Lỗi tái tạo sẽ chủ yếu phản ánh điều gì?
MSE cộng bình phương sai số theo đơn vị gốc. Một sai lệch cỡ độ lệch chuẩn của áp suất đóng góp , của nhiệt độ chỉ , chênh nhau khoảng 60 000 lần. Model dồn sức tái tạo áp suất, và score bất thường gần như chỉ nhìn vào áp suất. Lấy trung bình theo cột không cân lại được thang đo, và autoencoder cũng không tự chuẩn hóa. Hãy fit StandardScaler trên train, hoặc đặt trọng số cho từng cột theo mục tiêu.
Câu 7
Ngưỡng là phân vị 95% của score trên một tập validation gồm toàn mẫu bình thường. Sau đó nhà máy thay một loạt cảm biến mới, và phân bố dữ liệu chưa được kiểm lại. Ta kết luận được gì?
Phân vị chỉ bảo đảm khoảng 5% mẫu validation vượt ngưỡng. Cảm biến mới có thể làm dịch cả phân bố score, nên tỉ lệ báo nhầm phải đo lại trên dữ liệu mới. Recall thì cần mẫu bất thường có nhãn mới chấm được. Vượt ngưỡng chỉ nói mẫu ấy khác dữ liệu train, chưa chắc là lỗi.
Câu 8
Một đội viết autoencoder Linear(10,32) → Linear(32,2) → Linear(2,32) → Linear(32,10) nhưng quên đặt activation giữa các lớp. So với PCA 2 thành phần trên cùng tập train, MSE tái tạo tốt nhất mà mạng này đạt được là bao nhiêu?
Không có activation thì tích các ma trận vẫn là một ma trận, thêm bias thì thành một phép affine. Mọi thông tin phải đi qua nút thắt 2 chiều, nên hạng không quá 2. PCA 2 thành phần, tính trên dữ liệu đã trừ trung bình, đã là phép nén rồi dựng affine hạng 2 tốt nhất, nên mạng chỉ có thể bằng nó. Lớp rộng, train lâu hay nhiều weight đều không đổi được giới hạn này. Phải thêm ReLU giữa các lớp thì mạng mới học được cấu trúc cong.
Câu 9
Denoiser của bài được train với nhiễu Gaussian nhỏ cộng vào cả bốn cảm biến. Khi đem dùng thật, lỗi hay gặp lại là một cảm biến thỉnh thoảng bị kẹt và trả về 0. Trước khi dùng denoiser, ta nên làm gì?
Kết quả 0.019573 xuống 0.005335 chỉ được đo trên nhiễu Gaussian đều theo mọi hướng. Lỗi kẹt là một dạng nhiễu khác hẳn: lớn và dồn vào một cột. Phải tạo đúng dạng nhiễu ấy trên validation, nếu cần thì train lại với nó, theo kiểu masking noise của denoising autoencoder, rồi so với baseline giữ nguyên input. Tăng nhiễu Gaussian không biến nó thành nhiễu kẹt. Còn autoencoder không chỉ khử được nhiễu Gaussian; nó học khử đúng loại nhiễu mà nó được train.
Câu 10
Ở phần ngưỡng của bài, test có 32 mẫu bình thường và 16 mẫu bất thường, output in ra TP FP FN: 16 2 0. Precision và recall của lớp bất thường bằng bao nhiêu?
Precision là , tức cứ khoảng 9 lần báo thì có 1 lần nhầm. Recall là , không bỏ sót mẫu bất thường nào, nhờ nhóm bất thường nằm xa ngưỡng như trên hình lỗi tái tạo. 0.94 là tỉ lệ mẫu bình thường không bị báo, . Đổi chỗ precision với recall là nhầm định nghĩa.
Đọc thêm
- Goodfellow, Bengio, Courville — Deep Learning, chương 14: đọc nút thắt, giới hạn capacity và quan hệ với PCA.
- Vincent và cộng sự — Stacked Denoising Autoencoders: xem mục tiêu noisy input → clean target và học biểu diễn.
- Baldi, Hornik (1989) — Neural Networks and Principal Component Analysis: Learning from Examples Without Local Minima, Neural Networks 2(1). Chứng minh autoencoder tuyến tính tối ưu học đúng không gian PCA.
- PyTorch — Optimizing Model Parameters: dùng lại training loop đã học cho reconstruction loss.
Nguồn ảnh: ảnh quần áo lấy từ bộ Fashion-MNIST của Zalando (giấy phép MIT).