Phân cụm (clustering) chia dữ liệu thành các nhóm mà không có nhãn cho trước, ví dụ chia hồ sơ học sinh thành các nhóm có kiểu học giống nhau. Vì không có đáp án để so, kết quả phụ thuộc vào cách ta định nghĩa “gần nhau” và “một cụm”. Bài này học K-Means và DBSCAN, cách chọn số cụm, và vì sao hai thuật toán có thể chia cùng một dữ liệu theo hai cách đều hợp lý.
K-Means
Giả định: có cụm, mỗi cụm là một “đám” tròn quanh một tâm. K-Means tìm tâm cực tiểu tổng bình phương khoảng cách từ mỗi điểm đến tâm gần nhất (inertia):
Thuật toán Lloyd lặp hai bước đến khi không đổi:
- Gán: mỗi điểm thuộc cụm có tâm gần nhất.
- Cập nhật: mỗi tâm dời về trung bình các điểm của cụm.
Mỗi bước đều không làm tăng, và số cách chia là hữu hạn, nên thuật toán chắc chắn dừng. Nhưng nó chỉ dừng ở một cực tiểu địa phương: khởi tạo khác cho kết quả khác.
Hai cách giảm rủi ro kẹt:
- k-means++: chọn tâm đầu tiên ngẫu nhiên, rồi chọn mỗi tâm tiếp theo với xác suất tỉ lệ với bình phương khoảng cách từ điểm đến tâm gần nhất đã có. Nhờ vậy các tâm ban đầu thường nằm xa nhau.
- Chạy nhiều lần (
n_init) và giữ kết quả có nhỏ nhất.
Hỏi nhanh
Có ba điểm trên trục số: 0, 1 và 10. k-means++ đã chọn tâm đầu tiên là 0. Xác suất điểm 10 được chọn làm tâm thứ hai là bao nhiêu?
Bình phương khoảng cách tới tâm gần nhất lần lượt là 0, 1 và 100, nên xác suất là . Điểm ở xa gần như chắc chắn được chọn. Ra là quên bình phương.
Chi phí mỗi vòng là , nên K-Means chạy được trên dữ liệu rất lớn; MiniBatchKMeans còn nhanh hơn nữa.
Chọn K. Vẽ theo rồi tìm “khuỷu tay” (elbow method), hoặc chọn có hệ số silhouette trung bình cao nhất (mục Đánh giá cụm). Elbow chỉ là gợi ý; nên kiểm thêm cách chia có ổn định khi đổi seed, bớt mẫu không. Thường thì còn phụ thuộc mục đích: chia khách hàng thành 4 nhóm hay 6 nhóm là quyết định kinh doanh, không phải định lý.
Giới hạn. K-Means thích cụm tròn, kích thước gần bằng nhau, cùng mật độ. Với cụm hình trăng lưỡi liềm hay cụm lồng nhau, nó chia sai một cách rất tự tin. Tâm lại là trung bình, nên một điểm ngoại lệ đủ xa có thể kéo tâm rời khỏi đám điểm của nó: cụm gồm 1, 2, 3 và 100 có tâm ở .
Hỏi nhanh
Tăng lên bằng số điểm , mỗi điểm có một tâm riêng. Inertia tối ưu khi ấy bằng bao nhiêu?
Mỗi điểm trùng với tâm của nó, nên mọi khoảng cách đều bằng 0. Vì thế không thể chọn theo inertia nhỏ nhất: tiêu chí ấy luôn kéo về phía nhiều cụm hơn.
Khởi tạo tệ: tự sửa hay kẹt?
Kết quả của Lloyd phụ thuộc tâm khởi tạo. Lấy dữ liệu một chiều , , hai tâm đầu đặt tệ: , .
- Gán: về ; về .
- Cập nhật: , .
- Gán lại: điểm 2 giờ gần hơn (), nên cụm thành và .
- Cập nhật: , . Gán lại không đổi, dừng với .
Lần này khởi tạo tệ vẫn tự sửa được, và giảm qua từng bước: . Nhưng chỉ cần dời một điểm là sự may mắn ấy biến mất (câu hỏi bên dưới).
Trong hai chiều cũng vậy: ba điểm , , với tâm đầu đặt ở và dừng ở , với , trong khi , chỉ có .
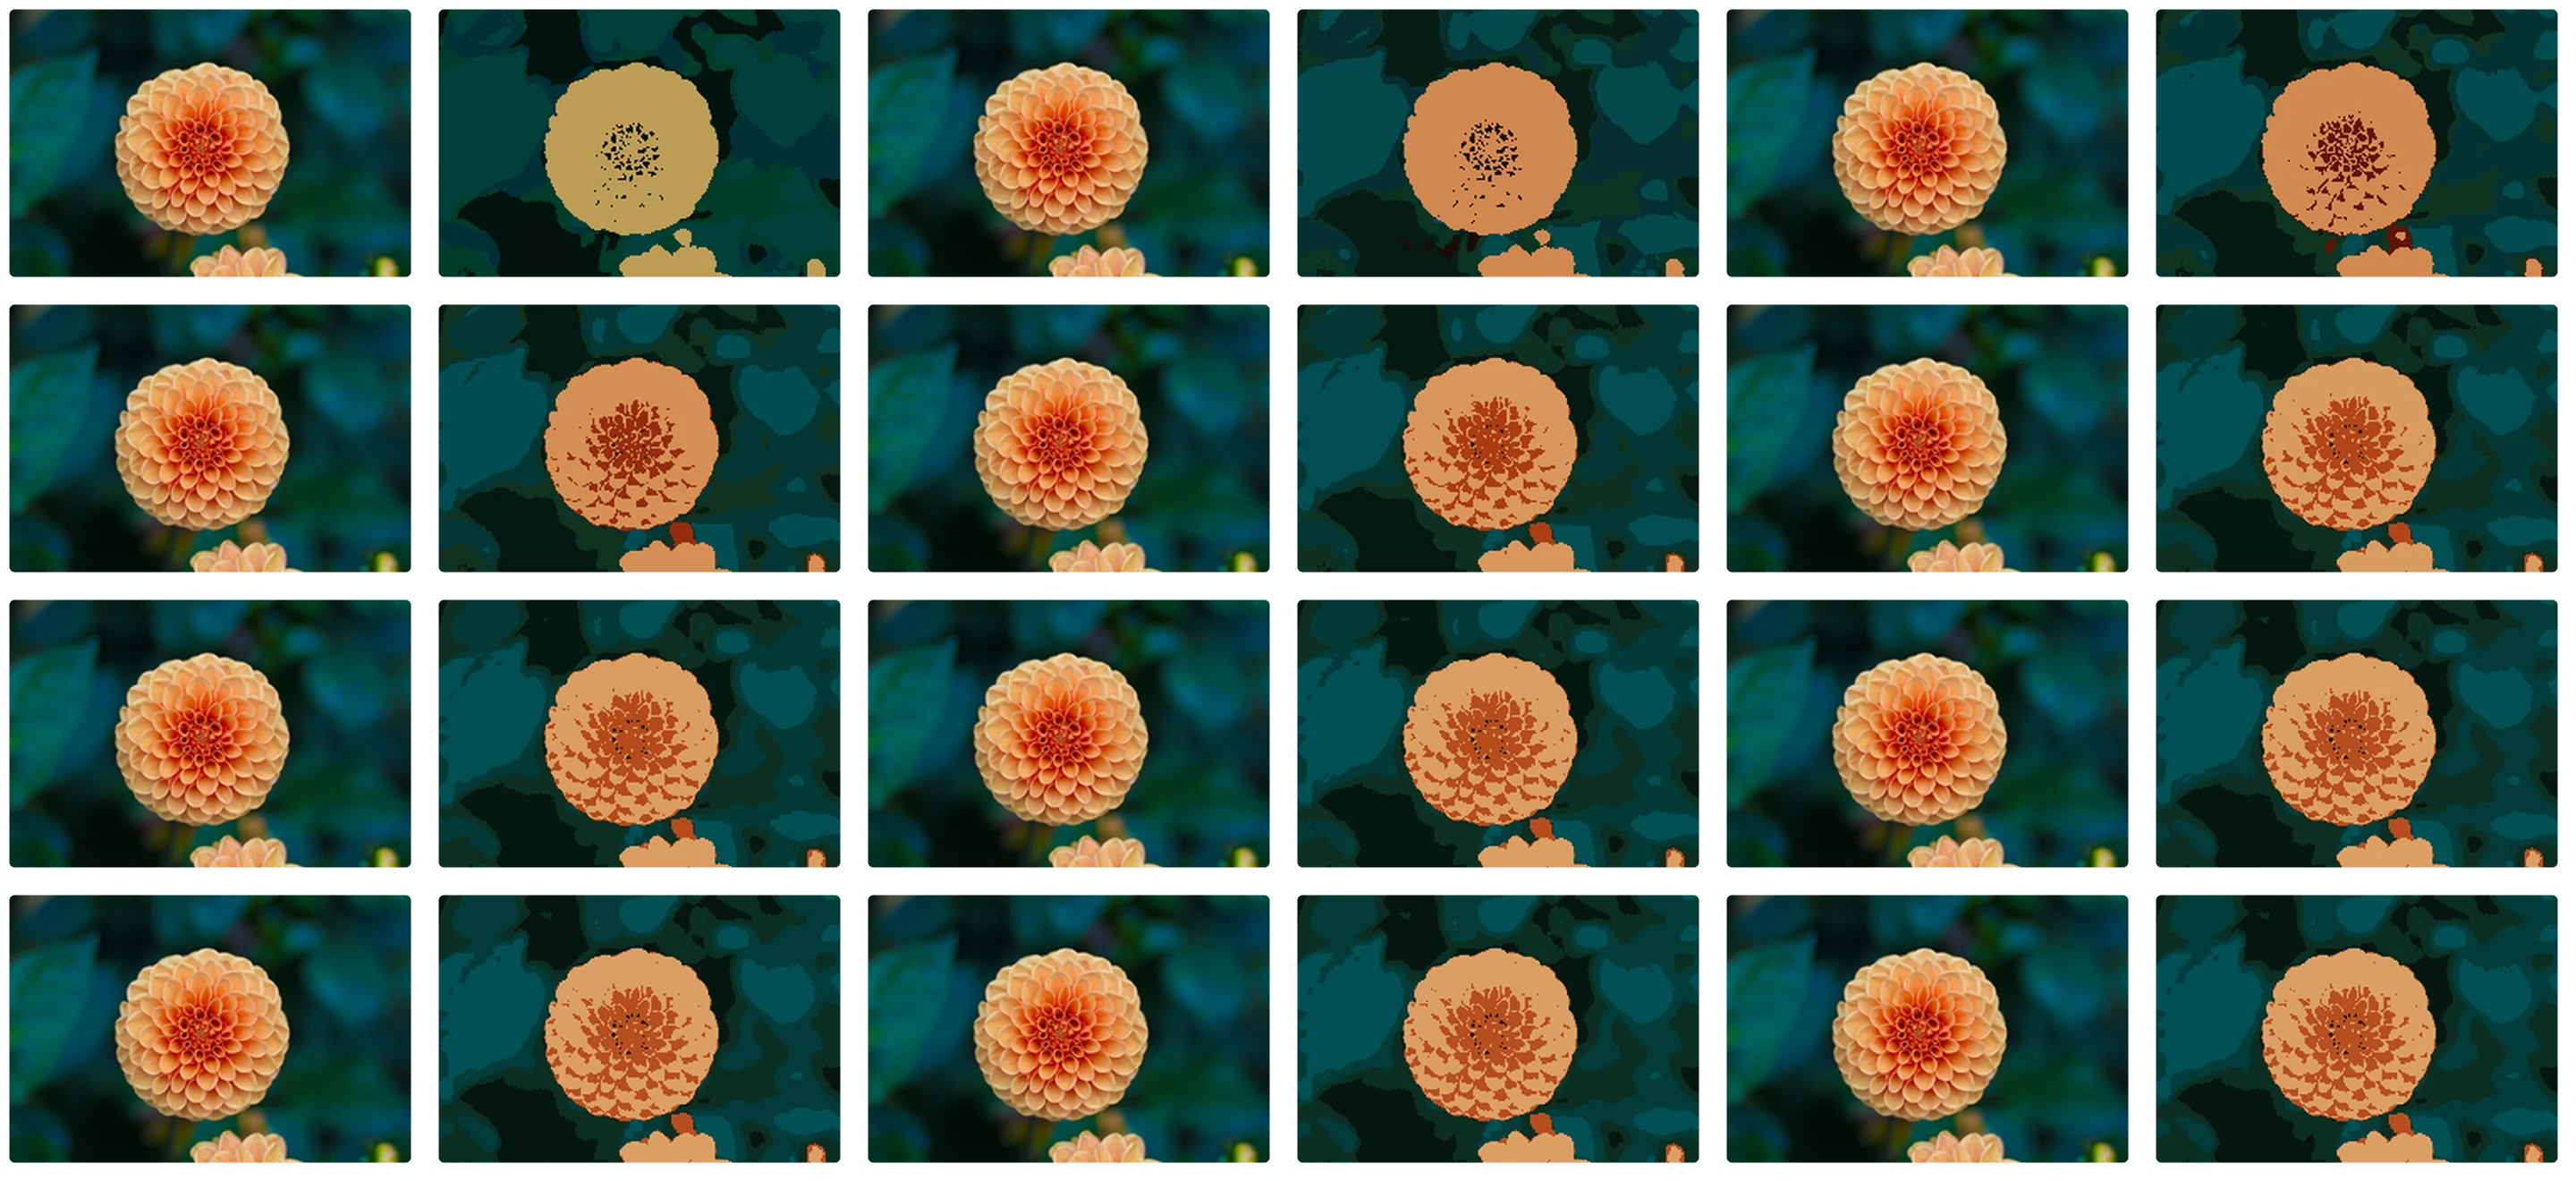
Hỏi nhanh
Giữ khởi tạo , , nhưng đổi điểm 2 thành 5, tức dữ liệu là 1, 5, 9, 10, 11. Thuật toán Lloyd dừng ở cách chia nào?
Sau vòng đầu, . Điểm 5 cách là 3.75, gần hơn so với (cách 4), nên không đổi cụm, và thuật toán dừng với . Cách chia và có , tốt hơn hẳn. Lloyd đã kẹt ở một cực tiểu địa phương, và n_init có mặt chính là vì vậy.
Cài một vòng Lloyd
Lấy bốn điểm một chiều 0, 1, 5, 6, hai tâm ban đầu 0 và 6. Mỗi điểm vào tâm gần nhất, nên nhóm trái gồm 0, 1 và nhóm phải gồm 5, 6. Tâm mới là 0.5 và 5.5. Inertia trước cập nhật là 2, sau cập nhật là 1. Code dưới cài đúng hai thao tác gán và cập nhật, và in ra các số vừa tính tay.
import numpy as np

values = np.array([[0.], [1.], [5.], [6.]])
centers = np.array([[0.], [6.]])
distance2 = np.sum((values[:, None, :] - centers[None, :, :]) ** 2, axis=2)
assigned = np.argmin(distance2, axis=1)
before = np.sum(distance2[np.arange(len(values)), assigned])
new_centers = np.array([values[assigned == k].mean(axis=0) for k in range(2)])
after = np.sum((values - new_centers[assigned]) ** 2)
print("gán:", assigned.tolist())
print("tâm mới:", new_centers.ravel().tolist())
print("inertia:", float(before), "->", float(after))
gán: [0, 0, 1, 1]
tâm mới: [0.5, 5.5]
inertia: 2.0 -> 1.0
Nếu một cụm không còn điểm nào, mean của mảng rỗng là NaN, và NaN lặng lẽ lan sang mọi bước sau. Ví dụ nhỏ trên không gặp, nhưng bản cài tổng quát phải chọn trước một quy tắc cho trường hợp này.
Hỏi nhanh
Tự cài Lloyd bằng NumPy, tới một vòng thì có một cụm không được gán điểm nào. Xử lý thế nào là hợp lý?
Trung bình của một tập rỗng không cho ra tâm nào cả. Có thể giữ tâm cũ, hoặc chuyển tâm tới điểm đang nằm xa tâm của nó nhất, như scikit-learn làm. Cách nào cũng được, miễn ghi rõ và kiểm lại xem thuật toán có hội tụ không.
DBSCAN
Giả định: cụm là vùng dày đặc, ngăn cách bởi vùng thưa. Hai tham số: bán kính eps và số điểm tối thiểu min_samples.
- Điểm lõi (core): có ít nhất
min_samplesđiểm trong bán kínheps. - Điểm biên (border): không phải lõi nhưng nằm trong bán kính của một điểm lõi.
- Điểm nhiễu (noise): không thuộc hai loại trên, gán nhãn .
Các điểm lõi nối với nhau thành cụm. DBSCAN không cần biết trước số cụm, tìm được cụm hình dạng bất kỳ và tự loại nhiễu. Điểm yếu: một eps duy nhất không hợp với dữ liệu có các cụm mật độ khác nhau. HDBSCAN khắc phục điều này và thường là lựa chọn tốt hơn khi có sẵn.
Hỏi nhanh
Dữ liệu có hai cụm. Cụm A dày, các láng giềng thường cách nhau . Cụm B thưa, các láng giềng thường cách nhau . Với eps=0.2, DBSCAN dễ cho ra kết quả nào?
Với bán kính 0.2, điểm của B hiếm khi có đủ hàng xóm. Tăng eps lên cỡ 0.8 thì B thành cụm, nhưng A có thể bị nối sang B nếu khe giữa hai cụm hẹp hơn mức ấy. Một giá trị eps không phục vụ được cả hai mật độ. HDBSCAN giải quyết việc này bằng cách quét qua nhiều mức mật độ.
DBSCAN trên năm điểm
Trong scikit-learn, số điểm trong bán kính eps được đếm tính cả chính nó. Từ một điểm core, cụm lan qua các core lân cận rồi nhận thêm border ở rìa. Vì vậy điểm border ít hàng xóm vẫn thuộc cụm; bản cài chỉ giữ các điểm đủ ngưỡng sẽ biến mọi border thành noise, và đó đã là một thuật toán khác.
from sklearn.cluster import DBSCAN

density_points = np.array([[0.], [0.1], [0.2], [0.35], [3.]])
db = DBSCAN(eps=0.16, min_samples=3).fit(density_points)
print("nhãn cụm:", db.labels_.tolist())
print("core:", db.core_sample_indices_.tolist())
assert db.labels_[-1] == -1
nhãn cụm: [0, 0, 0, 0, -1]
core: [1, 2]
Điểm 0.1 có ba điểm trong eps, còn 0 chỉ có hai; 0 vẫn vào cụm vì nó nối được với core 0.1. Điểm 3 quá xa nên nhãn −1. Số hiệu cụm 0, 1, … chỉ là tên tạm, có thể đổi thứ tự khi dữ liệu đổi. Một điểm border chạm được hai cụm thì thuộc cụm nào tùy thứ tự duyệt.
Hỏi nhanh
Giữ eps=0.16 như ví dụ trên, nhưng đặt min_samples=1. Điểm 3 nhận nhãn gì?
Với ngưỡng 1, điểm nào cũng tự đếm chính nó, nên điểm nào cũng là core. Điểm 3 thành cụm 1 một mình, và lúc này DBSCAN không còn điểm noise nào. Theo kinh nghiệm, người ta hay đặt min_samples cỡ , với là số chiều.
Hierarchical clustering
Agglomerative clustering bắt đầu với mỗi điểm là một cụm, rồi liên tục gộp hai cụm gần nhau nhất. Khoảng cách giữa hai cụm (linkage) có thể là:
- single: hai điểm gần nhất, tạo cụm dạng chuỗi dài;
- complete: hai điểm xa nhất, tạo cụm gọn;
- average: trung bình mọi cặp;
- Ward: mức tăng tổng phương sai khi gộp, gần với tinh thần của K-Means.
Kết quả là một cây gộp (dendrogram); cắt cây ở độ cao nào thì được số cụm tương ứng. Cách này cho cái nhìn nhiều tầng, nhưng tốn bộ nhớ nên chỉ hợp với vài chục nghìn điểm.
Hỏi nhanh
Hai cụm trên trục số là và . Khoảng cách giữa chúng theo single linkage và theo complete linkage lần lượt là bao nhiêu?
Single linkage lấy cặp gần nhất, . Complete linkage lấy cặp xa nhất, . Còn 6 là average linkage, trung bình của bốn cặp . Single linkage chỉ cần một cặp gần là gộp, nên dễ nối các cụm thành một chuỗi dài.
Spectral clustering
Spectral clustering làm ba bước:
- Dựng đồ thị tương đồng giữa các điểm, ví dụ nối mỗi điểm với các láng giềng gần.
- Lấy vài vector riêng của ma trận Laplacian của đồ thị làm tọa độ mới.
- Chạy K-Means trên tọa độ đó.
Hai điểm cùng nằm trên một “dải” dữ liệu sẽ gần nhau trong tọa độ mới dù xa nhau theo đường thẳng. Cách này mạnh với cụm không lồi, nhưng tốn kém với lớn.
Laplacian là , với ma trận trọng số cạnh và ma trận đường chéo chứa bậc của mỗi đỉnh. Số trị riêng bằng 0 đúng bằng số thành phần liên thông, nên các vector riêng ứng với trị riêng nhỏ nhất chỉ ra cách cắt đồ thị.
Với hai vòng đồng tâm còn một cách thủ công: thêm đặc trưng , bình phương khoảng cách tới tâm, rồi chạy K-Means.
Hỏi nhanh
Hai vòng tròn đồng tâm, mỗi vòng là một cụm. K-Means với cho ARI gần bằng 0, còn spectral clustering trên đồ thị láng giềng thì tách đúng. Lý do chính là gì?
Hai vòng có cùng tâm, nên mọi cách chia theo tâm gần nhất đều cắt ngang cả hai vòng. Trong đồ thị láng giềng, mỗi vòng gần như là một thành phần tách rời. Các vector riêng của Laplacian gần như không đổi trên từng thành phần, nên K-Means trên tọa độ mới tách được ngay. Với make_circles(factor=0.4), ARI là so với .
Gaussian mixture: gán mềm
K-Means gán mỗi điểm cứng vào đúng một cụm, và chỉ nhìn khoảng cách tới tâm. Gaussian mixture model (GMM) coi dữ liệu được sinh từ phân phối chuẩn, mỗi thành phần có trọng số , trung bình và hiệp phương sai riêng. Mỗi điểm nhận một xác suất thuộc từng thành phần (gán mềm), gọi là responsibility .
GMM học bằng thuật toán EM, lặp hai bước giống Lloyd:
- E-step: với tham số hiện tại, tính , xác suất điểm thuộc thành phần .
- M-step: cập nhật , , bằng trung bình có trọng số .
Khởi tạo thường lấy tâm của K-Means; lặp tới khi log-likelihood gần như không tăng. Cần một cụm cứng thì gán mỗi điểm vào thành phần có lớn nhất. K-Means là trường hợp đặc biệt khi mọi thành phần có cùng hiệp phương sai tròn và rất nhỏ.
Khác biệt hiện rõ khi hai cụm có độ rộng khác nhau. Dưới đây là 300 điểm quanh 0 với độ lệch chuẩn 0.5, và 300 điểm quanh 5 với độ lệch chuẩn 2.
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score
from sklearn.mixture import GaussianMixture

gen = np.random.default_rng(0)
x1 = np.concatenate([gen.normal(0, 0.5, 300), gen.normal(5, 2.0, 300)]).reshape(-1, 1)
truth = np.r_[np.zeros(300), np.ones(300)]
km = KMeans(n_clusters=2, n_init=10, random_state=0).fit(x1)
gm = GaussianMixture(n_components=2, random_state=0).fit(x1)
narrow = int(np.argmin(gm.covariances_.ravel()))
print("Tâm K-Means:", np.sort(km.cluster_centers_.ravel()).round(2),
      " ranh giới ở", round(km.cluster_centers_.mean(), 2))
print("GMM: trung bình", gm.means_.ravel().round(2),
      " độ lệch chuẩn", np.sqrt(gm.covariances_.ravel()).round(2))
print("Điểm 1.5 thuộc cụm hẹp với xác suất", gm.predict_proba([[1.5]])[0, narrow].round(2))
print("ARI: K-Means", round(adjusted_rand_score(truth, km.labels_), 2),
      " GMM", round(adjusted_rand_score(truth, gm.predict(x1)), 2))
Tâm K-Means: [0.14 5.4 ] ranh giới ở 2.77
GMM: trung bình [ 4.88 -0.04] độ lệch chuẩn [2.04 0.5 ]
Điểm 1.5 thuộc cụm hẹp với xác suất 0.11
ARI: K-Means 0.79 GMM 0.96
K-Means đặt ranh giới ở giữa hai tâm, 2.77, nên các điểm từ 1.5 tới 2.7 bị xếp vào cụm hẹp. GMM biết cụm quanh 0 rất hẹp: điểm 1.5 đã cách tâm 3 độ lệch chuẩn của cụm đó, nên chỉ có xác suất 0.11 thuộc về nó. Nhờ học cả độ rộng của từng cụm, GMM đạt ARI 0.96 so với 0.79.
Hỏi nhanh
GMM cho một điểm responsibility là với hai thành phần. So với một điểm có , ta biết gì?
Responsibility cho biết mức chắc chắn: là điểm nằm vùng giáp ranh, là điểm nằm sâu trong thành phần 1. Gán cứng thì cả hai vào thành phần 1, mất thông tin này. GMM không có khái niệm noise như DBSCAN. Tổng bằng 1 là theo từng điểm, và cả hai điểm đều thỏa điều đó.
Đánh giá cụm
Không có nhãn thì đo độ “gọn và tách biệt”. Với điểm , gọi là khoảng cách trung bình đến các điểm cùng cụm, là khoảng cách trung bình nhỏ nhất đến một cụm khác. Hệ số silhouette
gần 1 là điểm nằm đúng cụm, gần 0 là nằm giữa hai cụm, âm là có lẽ xếp nhầm. lấy cụm khác gần nhất, không phải xa nhất: , khoảng cách trung bình tới hai cụm khác là 0.9 và 0.6 thì .
Silhouette cũng “thích” cụm tròn, nên đánh giá thấp kết quả tốt của DBSCAN trên dữ liệu hình trăng (mục Dùng thư viện). Đừng chọn số cụm chỉ vì silhouette cao.
Inertia lại càng không dùng được để chọn : inertia tối ưu không tăng khi tăng, nên “chọn có inertia nhỏ nhất” luôn đẩy về rất nhiều cụm.
Hỏi nhanh
Một điểm có , tức khoảng cách trung bình tới cụm của nó, và , tức khoảng cách trung bình tới cụm khác gần nhất. Silhouette của điểm này bằng bao nhiêu?
, nên điểm khá gọn trong cụm của nó. Nếu đổi chỗ và thì ra , dấu hiệu điểm có lẽ đã bị xếp nhầm cụm.
Nếu có nhãn thật (đề thi chấm phân cụm thường có), dùng Adjusted Rand Index (ARI) hoặc Normalized Mutual Information (NMI). Nhãn chỉ dùng để chấm, không dùng khi fit. Cả hai không phụ thuộc cách đặt tên cụm: cụm “0” của mô hình có là cụm “3” của đáp án cũng không sao. Accuracy so thẳng thì khác: chỉ cần đổi tên cụm là điểm sụp.
Hỏi nhanh
Nhãn tham khảo là , mô hình trả về . Accuracy so thẳng và ARI lần lượt bằng bao nhiêu?
Hai cách chia giống hệt nhau, chỉ khác tên cụm. Accuracy so từng ID nên bằng 0. ARI xét từng cặp mẫu xem có cùng cụm hay không, nên bằng 1.
Dùng thư viện
from sklearn.cluster import DBSCAN, KMeans
from sklearn.datasets import make_moons
from sklearn.metrics import adjusted_rand_score, silhouette_score
from sklearn.preprocessing import StandardScaler

X, y = make_moons(n_samples=400, noise=0.06, random_state=0)
X = StandardScaler().fit_transform(X)
for name, model in [("K-Means", KMeans(n_clusters=2, n_init=10, random_state=0)),
                    ("DBSCAN ", DBSCAN(eps=0.3, min_samples=5))]:
    labels = model.fit_predict(X)
    print(name, "ARI =", round(adjusted_rand_score(y, labels), 2),
          " silhouette =", round(silhouette_score(X, labels), 2))
K-Means ARI = 0.47 silhouette = 0.5
DBSCAN ARI = 1.0 silhouette = 0.39
DBSCAN khớp nhãn hoàn toàn theo ARI, nhưng silhouette lại chấm K-Means cao hơn: đúng điều mục Đánh giá cụm đã cảnh báo. Con số eps=0.3 cũng chỉ có nghĩa sau StandardScaler: bán kính luôn đi kèm thang đo.
Hỏi nhanh
Trong code trên, nhân X đã chuẩn hóa lên 10 lần nhưng giữ eps=0.3. DBSCAN sẽ trả về gì?
Khoảng cách tăng 10 lần mà bán kính vẫn giữ nguyên, nên hầu hết các điểm không có đủ 5 hàng xóm. Chạy thử thì 98.75% số điểm nhận nhãn . Đổi đơn vị đo thì phải đổi eps theo.
Khi đi thi
- Chuẩn hóa các cột trước K-Means, DBSCAN và mọi thuật toán dựa trên khoảng cách.
- Chạy K-Means với nhiều lần khởi tạo (
n_init), vì Lloyd có thể kẹt ở cực tiểu địa phương. - Đề chấm bằng ARI hay NMI thì chọn thuật toán theo hình dạng cụm, đừng mặc định K-Means.
Tóm tắt
- Phân cụm không có đáp án; mỗi thuật toán là một giả định về hình dạng cụm.
- K-Means: cụm tròn quanh tâm, nhanh, cần , chỉ đạt cực tiểu địa phương; k-means++ và
n_initgiảm rủi ro kẹt. - DBSCAN: cụm là vùng dày đặc, tự tìm số cụm và nhiễu, nhạy với
epsvà thang đo. - Phân cấp cho cây gộp nhiều tầng; spectral xử lý cụm không lồi.
- GMM gán mềm theo xác suất, học trung bình và độ rộng của từng cụm bằng EM; K-Means gán cứng theo tâm gần nhất.
- Không nhãn thì dùng silhouette (cẩn thận với cụm không tròn); có nhãn thì dùng ARI, NMI.
Kiểm tra cuối bài
Mười câu kiểm cả cách hiểu, phép tính và quy trình. Câu sai chỉ ra phần cần đọc lại; hãy làm trước khi mở lời giải.
Câu 1
Ở bước cập nhật của K-Means, một cụm đang có ba điểm , và . Tâm mới của cụm là điểm nào?
Lấy trung bình theo từng tọa độ: . Đây là bước cập nhật của Lloyd, làm sau bước gán điểm.
Câu 2
Có bảy điểm , , hai tâm khởi tạo là và . Khoảng cách từ tới lần lượt là 3, 4, 4, 3, 6. Tới lần lượt là 2, 7, 1, 8, 1. Sau bước gán đầu tiên, hai cụm là gì?
So từng cặp khoảng cách. (3 so với 2), (4 so với 1) và (6 so với 1) về với . (4 so với 7) và (3 so với 8) về với . Bước gán chỉ cần khoảng cách, không cần tọa độ.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q8.3
Câu 3
Chạy k-means++ trên năm điểm , , , , với , tâm đầu tiên là . Xác suất được chọn làm tâm thứ hai là bao nhiêu?
Bình phương khoảng cách tới lần lượt là 5, 13, 10, 17, tổng là 45, nên xác suất là . Quên bình phương thì ra khoảng . Chọn đều thì ra hoặc .
Phỏng theoCMU 10-601 · Exam 3 Practice · Q8.2
Câu 4
Hai lần khởi tạo K-Means với cùng cho inertia 12 và 9 trên cùng dữ liệu. Theo inertia thì chọn kết quả nào, và điều gì vẫn chưa kết luận được?
Mỗi bước của Lloyd không làm mục tiêu tăng, nhưng điều đó không bảo đảm tới được nghiệm toàn cục. Chạy nhiều lần khởi tạo chỉ giúp chọn kết quả tốt nhất trong những lần đã thử.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q8.1(ii)
Câu 5
Một cụm K-Means gồm các điểm trên trục số 1, 2, 3. Thêm điểm ngoại lai 30 vào cụm. Tâm mới bằng bao nhiêu? Nếu thay trung bình bằng median thì sao?
Trung bình bị điểm ngoại lai kéo ra xa cả ba điểm còn lại, trong khi median là 2.5, gần như không đổi. K-Means nhạy với điểm ngoại lai chính vì bước cập nhật dùng trung bình. K-medians và K-medoids đổi lấy sự bền vững này.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q8.1(iii)
Câu 6
DBSCAN dùng khoảng cách Euclid, eps=1.1, min_samples=3, tính cả điểm đang xét. Ba điểm trên trục số là 0, 1 và 2. Điểm nào là core?
Lân cận của 1 có đủ ba điểm 0, 1, 2. Lân cận của 0 chỉ có 0 và 1, của 2 chỉ có 1 và 2, nên chưa đủ ba điểm.
Câu 7
Muốn phân cụm những vùng có mật độ khác nhau, trong bốn thuật toán sau thì thuật toán nào phù hợp hơn?
Trong bốn lựa chọn, chỉ DBSCAN định nghĩa cụm theo mật độ. Hai phương án hồi quy không phải thuật toán phân cụm, còn K-Means chia theo tâm gần nhất. Nhưng như đã thấy trong bài, một eps chung vẫn khó phục vụ các mật độ chênh nhau nhiều. Khi làm thật, HDBSCAN thường tốt hơn.
Câu 8
Trong spectral clustering, vì sao ta dùng các vector riêng của Laplacian đồ thị?
Nếu đồ thị gồm vài phần ít cạnh nối với nhau, các vector riêng ứng với những trị riêng nhỏ nhất gần như không đổi trên từng phần. Lấy chúng làm tọa độ thì các cụm thành những đám dễ tách. Số chiều cũng giảm, nhưng đó là hệ quả chứ không phải lý do.
Câu 9
Nhãn cụm của bốn mẫu là [0, 0, 1, 1]. Đổi tên các cụm thành [7, 7, 3, 3] mà không đổi cách chia nhóm. ARI so với cùng một nhãn tham khảo thay đổi thế nào?
ARI dựa vào việc từng cặp mẫu cùng cụm hay khác cụm, không dựa vào giá trị số của tên cụm.
Câu 10
Mỗi bộ dữ liệu gồm 400 điểm sinh từ bốn hàm: mũ, log, sin và tuyến tính, mỗi hàm 100 điểm có nhiễu. Baseline của đề chạy K-Means với trên , rồi fit riêng từng cụm. Bước phân cụm này yếu ở đâu?
Đề đã cho sẵn bốn hàm nên là đúng. Vấn đề là K-Means chia mặt phẳng thành những vùng lồi quanh các tâm, còn mỗi hàm là một đường cong trải dài và có thể cắt các đường khác. Phải gán điểm theo mức khớp với từng dạng hàm, rồi fit lại và lặp, thì mới bám đúng cấu trúc của bài.
Đọc thêm
- James, Witten, Hastie, Tibshirani — An Introduction to Statistical Learning, mục 12.4. K-Means, phân cụm phân cấp và cách đọc dendrogram.
- Arthur, Vassilvitskii (2007) — k-means++: The Advantages of Careful Seeding. Khởi tạo theo bình phương khoảng cách, kèm bảo đảm về sai số kỳ vọng.
-
Ester và cộng sự (1996) — A Density-Based Algorithm for Discovering Clusters in Large Spatial Databases with Noise. Bài gốc của DBSCAN.
-
scikit-learn — Clustering. Bảng so sánh trực quan các thuật toán, ý nghĩa
eps,min_samplesvà các metric đánh giá. - ISLP — Unsupervised learning lab. Thực hành PCA, K-Means và phân cụm phân cấp.
Nguồn ảnh: ảnh hoa là ảnh mẫu flower.jpg kèm scikit-learn (vultilion, Flickr, CC BY 2.0).