kNN (k-Nearest Neighbors) dự đoán cho một mẫu mới bằng cách tìm mẫu gần nó nhất trong dữ liệu đã có rồi lấy nhãn chiếm đa số. Ví dụ: xếp thành viên mới vào nhóm luyện dựa trên những thành viên có điểm thuật toán và số giờ tự học gần giống. Vì dựa hoàn toàn vào khoảng cách, kNN rất nhạy với đơn vị đo: đổi giờ sang phút có thể làm đổi kết quả. Bài này học cách kNN dự đoán, cách chọn và vì sao phải chuẩn hóa dữ liệu trước.
Thuật toán
Cho tập huấn luyện và một điểm cần dự đoán :
- Tính khoảng cách đến mọi điểm.
- Lấy tập gồm điểm gần nhất.
- Phân loại: chọn nhãn xuất hiện nhiều nhất trong . Hồi quy: lấy trung bình của .
Ví dụ năm điểm nhãn đỏ, đỏ, xanh, xanh, xanh. Truy vấn , , khoảng cách Euclid bình phương:
| Điểm | A | B | C | D | E |
|---|---|---|---|---|---|
| 2 | 1 | 5 | 13 | 1 |
Ba láng giềng gần nhất là , , : hai đỏ, một xanh, nên dự đoán đỏ. Với thì và cùng khoảng cách, nên cần quy tắc phá hòa, chẳng hạn chọn điểm có chỉ số nhỏ hơn. Đề chấm tự động thường ghi rõ quy tắc phá hòa; đọc sót nó là đủ để kết quả lệch đáp án.
Biến thể có trọng số cho láng giềng càng gần càng có tiếng nói lớn, ví dụ trọng số . Một láng giềng lớp A cách 1 và hai láng giềng lớp B cách 2, 3: bỏ phiếu đều thì B thắng 2–1, còn theo thì A được 1, B chỉ được . Hồi quy cũng vậy: giá trị 10, 20, 40 ở khoảng cách 1, 2, 4 cho , gần láng giềng sát nhất hơn trung bình thường .
kNN là học lười (lazy learning): “huấn luyện” chỉ là cất dữ liệu đi, mọi công việc dồn vào lúc dự đoán. Ngược lại, mô hình tuyến tính là học chăm (eager): học xong chỉ giữ , dữ liệu gốc có thể bỏ. kNN vẫn là học có giám sát, vì các láng giềng phải có nhãn mới bỏ phiếu được. Chữ ở đây là số láng giềng, khác hẳn của K-means ở bài 2.10, là số cụm.
Hỏi nhanh
Có ba láng giềng: một láng giềng nhãn 0 ở khoảng cách 1, hai láng giềng nhãn 1 ở khoảng cách 4 và 5. Bỏ phiếu đều thì ra nhãn nào? Bỏ phiếu theo trọng số thì ra nhãn nào?
Bỏ phiếu đều thì nhãn 1 có hai phiếu và thắng. Theo trọng số , nhãn 0 được 1 điểm, còn nhãn 1 chỉ được . Một láng giềng rất gần có thể thắng hai láng giềng ở xa. Chọn kiểu trọng số nào cũng là một hyperparameter.
Khoảng cách
| Tên | Công thức | Hợp với |
|---|---|---|
| Euclid (L2) | Đặc trưng số đã chuẩn hóa | |
| Manhattan (L1) | Ít nhạy với một chiều lệch lớn | |
| Cosine | Embedding, văn bản: quan tâm hướng, không quan tâm độ dài |
Với vector đã chuẩn hóa về độ dài 1, , nên xếp hạng theo Euclid và theo cosine là như nhau. Thư viện tìm kiếm embedding dùng đúng mẹo này. Đổi cách đo có thể đổi láng giềng: từ , điểm cách 3 theo cả hai cách, còn cách theo Euclid nhưng cách 4 theo Manhattan. Muốn một cột nặng ký hơn thì đánh trọng số ngay trong khoảng cách, .
Hỏi nhanh
Văn bản A là văn bản B chép lại hai lần, nên vector đếm từ của A đúng bằng 2 lần vector của B. Theo cosine và theo Euclid, A và B có gần nhau không?
Hai vector cùng hướng nên khoảng cách cosine bằng 0. Khoảng cách Euclid thì đúng bằng độ dài của B, lớn khi B dài. Với văn bản, độ dài thường không phải thứ cần so, nên người ta dùng cosine hoặc chuẩn hóa độ dài trước.
Thang đo quyết định tất cả. Hai đặc trưng “tuổi” (20 đến 60) và “thu nhập tháng” tính bằng đồng (5 triệu đến 50 triệu): khoảng cách gần như chỉ còn là chênh lệch thu nhập, tuổi chẳng còn tiếng nói nào. Khi đơn vị các cột không so sánh được, chuẩn hóa hoặc thiết kế trọng số khoảng cách là bước cần kiểm bằng validation.
Chọn k
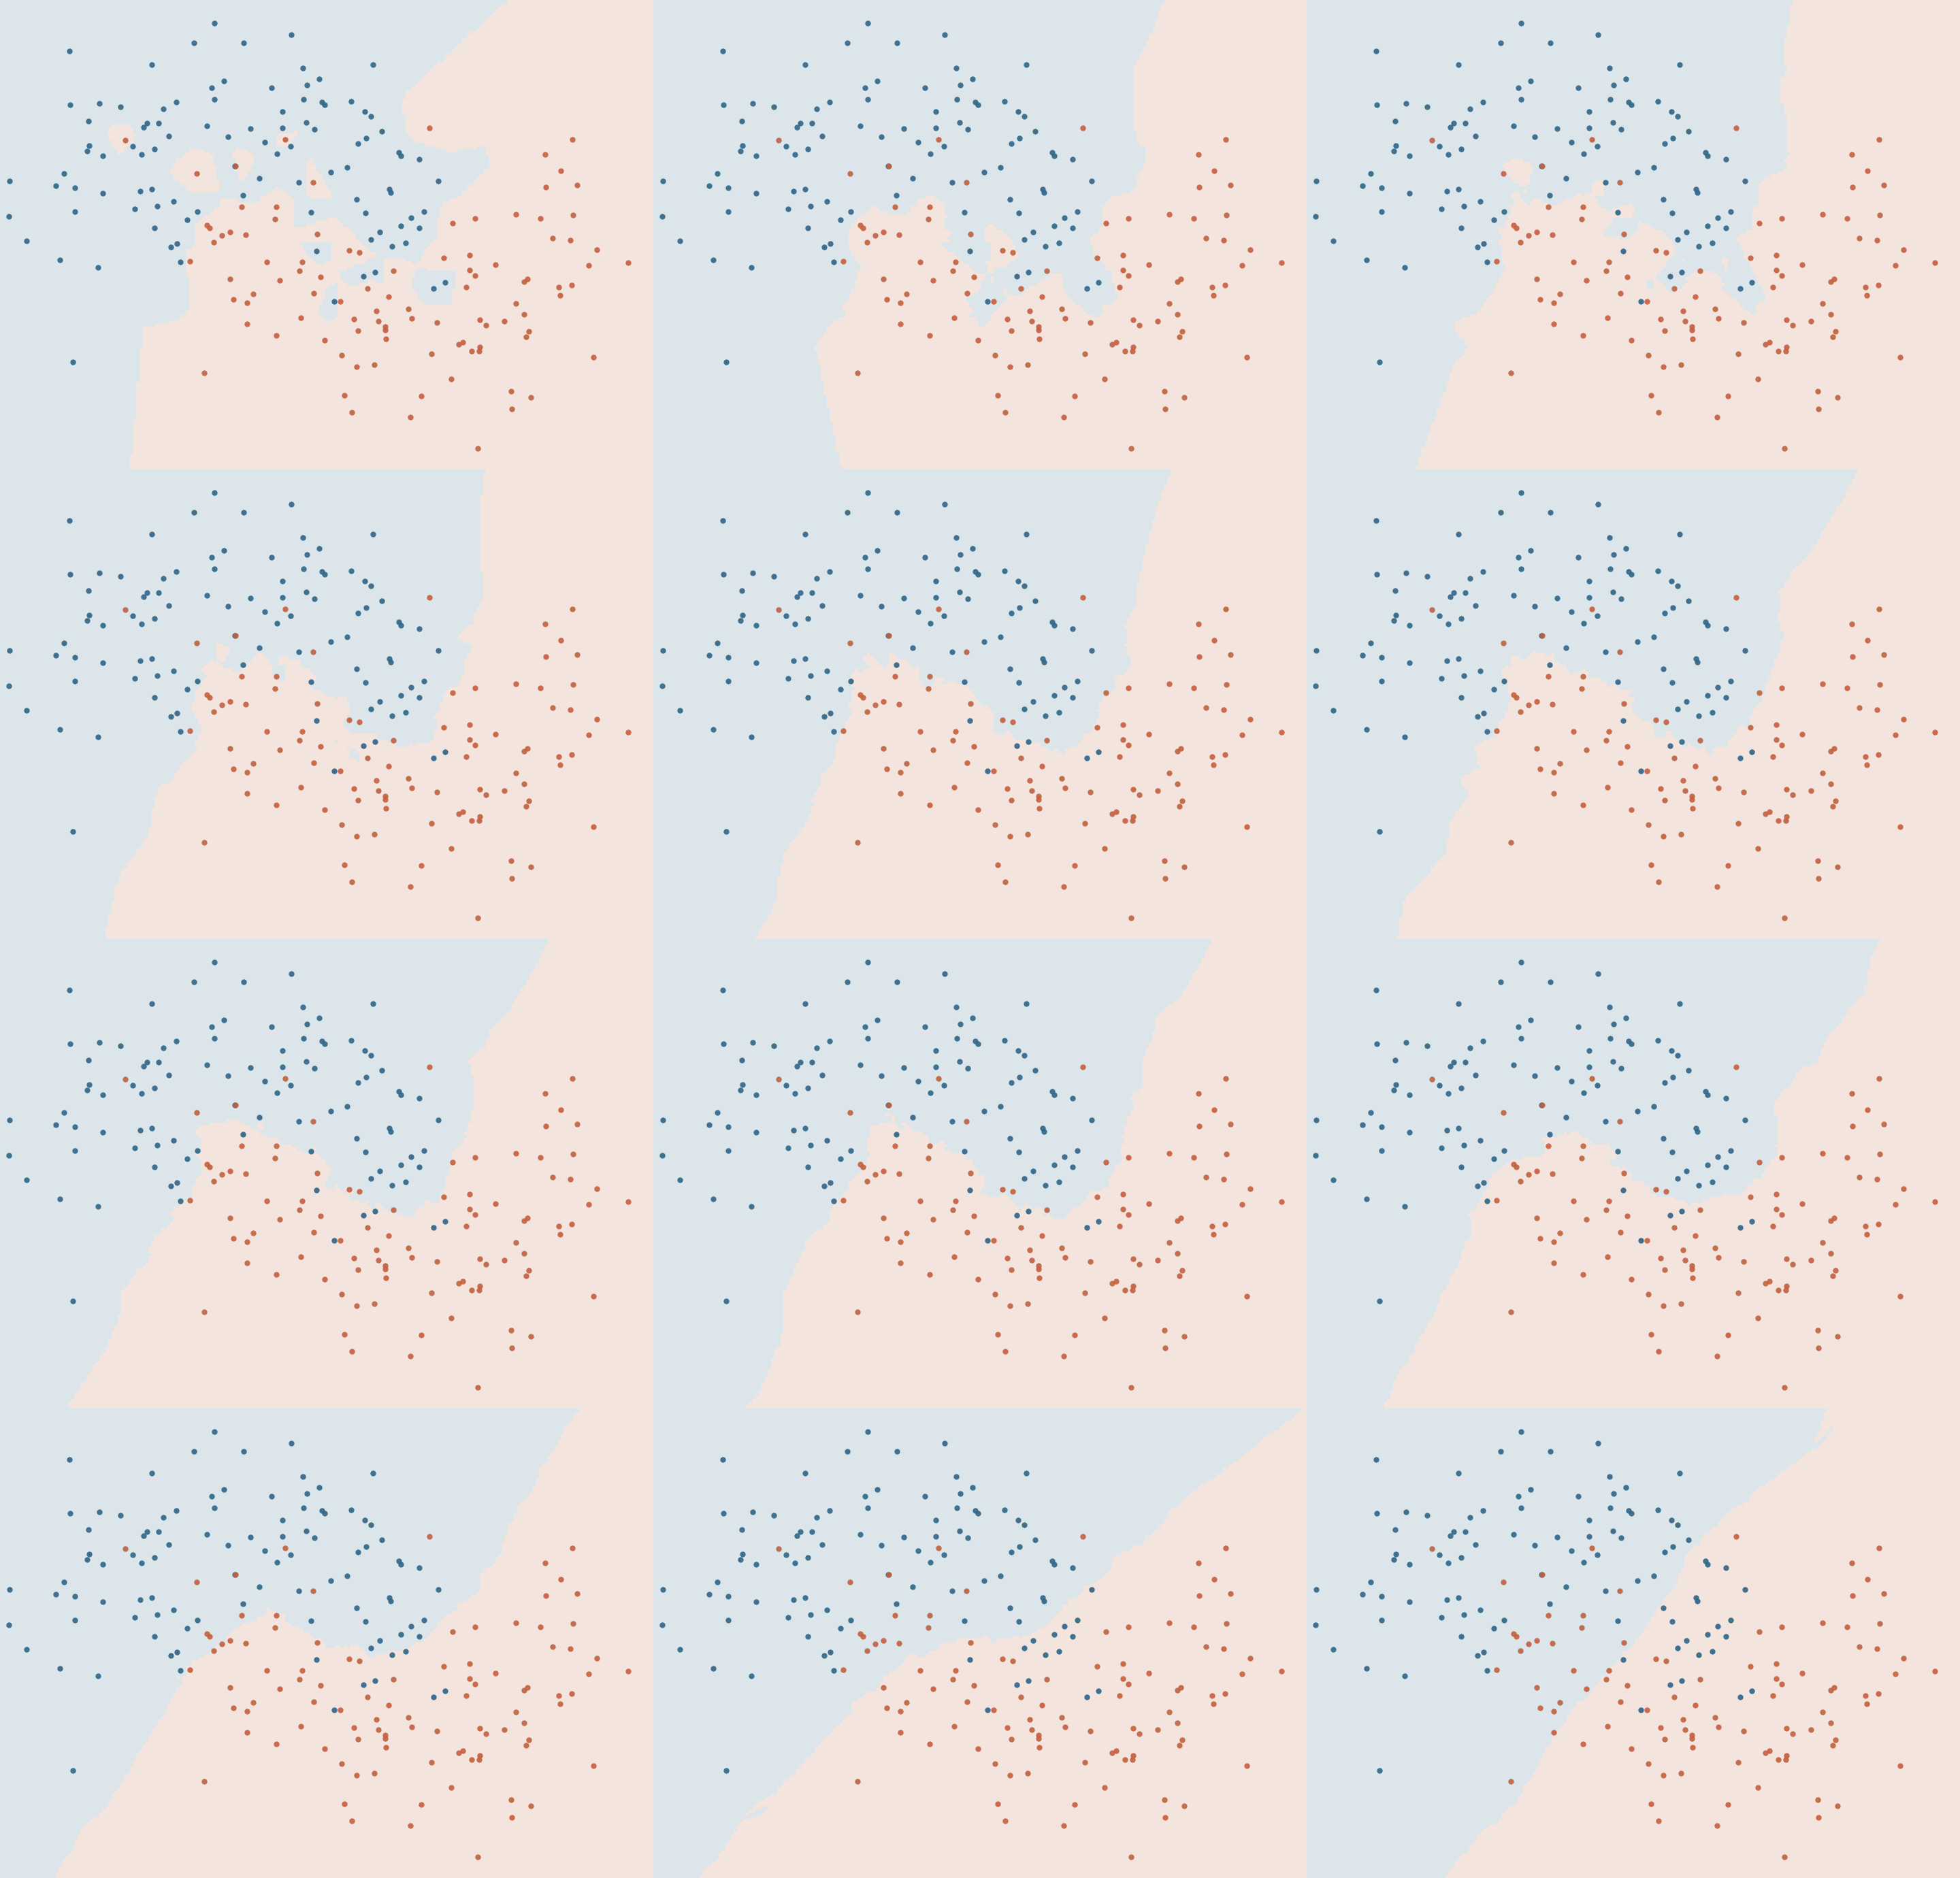
- : lỗi trên train thường bằng 0 nếu không có hồ sơ trùng nhau mang nhãn mâu thuẫn, ranh giới lởm chởm theo từng điểm nhiễu. Variance cao.
- lớn: ranh giới mượt, nhưng thì đoán mọi điểm là lớp đông nhất. Bias cao.
Chọn bằng cross-validation. Với phân loại nhị phân, lẻ tránh hòa phiếu. Leave-one-out (bài 1.3) rất rẻ với kNN: bỏ từng điểm ra rồi hỏi láng giềng trong phần còn lại, không phải học lại gì. Trên một trục số, 1-NN chỉ đổi dự đoán ở trung điểm giữa hai điểm liền kề khác nhãn, nên nó chính là một dãy ngưỡng.
Hỏi nhanh
Một bạn chọn , vì trong các đã thử, có lỗi train thấp nhất, bằng 0. Chọn như vậy có ổn không?
Mỗi điểm train là láng giềng gần nhất của chính nó, nên 1-NN gần như lúc nào cũng có lỗi train bằng 0. Lỗi train vì vậy không nói gì về điểm mới. Ta chọn bằng lỗi validation hoặc cross-validation. Chọn lớn nhất cũng chưa chắc tốt, vì ranh giới có thể bị làm mượt quá tay.
Phỏng theoCMU 10-601 · Exam 1 Practice · Q2.3(f)
Lời nguyền số chiều
Khi số chiều tăng, với dữ liệu trải đều, điểm gần nhất và điểm xa nhất cách truy vấn gần bằng nhau, nên “láng giềng” mất ý nghĩa. Dữ liệu thật thường nằm gần một cấu trúc ít chiều hơn nhiều, nên mức độ tệ còn tùy số chiều thực chất của nó. Một phép tính nhỏ cho thấy hiện tượng này. Dữ liệu rải đều trong khối lập phương đơn vị chiều. Muốn một khối lập phương nhỏ chứa 10% dữ liệu thì cạnh của nó phải dài :
- : cạnh , đúng là “lân cận”.
- : cạnh , gần hết cả khoảng.
- : cạnh .
Láng giềng gần nhất trong 100 chiều thực chất chẳng gần chút nào. Nhìn theo chiều ngược lại: khối lập phương đồng tâm cạnh chỉ chứa thể tích, gần như mọi điểm nằm sát biên. Muốn láng giềng gần nhất gần gấp đôi thì mỗi điểm phải phủ một quả cầu bán kính bằng nửa, thể tích nhỏ đi lần, nên cần khoảng lần số điểm. Vì vậy kNN chạy tốt trên đặc trưng ít chiều, hoặc trên embedding mà mô hình đã học sẵn để những thứ giống nhau nằm gần nhau, thường kèm giảm chiều bằng PCA (bài 2.9).
Hỏi nhanh
Dữ liệu rải đều trong một khối lập phương đơn vị 50 chiều. Một khối lập phương nhỏ chứa 1% dữ liệu thì có cạnh dài khoảng bao nhiêu?
Cạnh bằng . Muốn lấy chỉ 1% dữ liệu mà vẫn phải đi gần hết chiều dài mỗi trục. Nói cách khác, “vùng lân cận” đã gần bằng cả miền.
Chi phí
Dự đoán một điểm tốn . Với lớn, có ba cách tăng tốc:
- Cây không gian (KD-tree, Ball tree): nhanh khi nhỏ, dưới khoảng 20.
- Vector hóa bằng phép nhân ma trận trên GPU: tính một lần khoảng cách giữa cả lô truy vấn và cả tập dữ liệu.
- Tìm gần đúng (approximate nearest neighbor) như FAISS, HNSW: chấp nhận đôi khi sót láng giềng thật để nhanh hơn hàng trăm lần. Đây là nền của các hệ thống tìm kiếm ảnh và văn bản. Chúng có núm đổi tốc độ lấy độ đúng, như
ef_searchcủa HNSW: giữ nhiều ứng viên hơn khi duyệt thì ít sót láng giềng thật nhưng chậm hơn.
Vài lưu ý khi tự cài:
- Chọn phần tử nhỏ nhất: sort toàn bộ tốn ;
np.argpartitionchọn trước rồi chỉ sort phần tử thì rẻ hơn. - Với truy vấn một lúc, ma trận khoảng cách có thể hết RAM dù code chỉ một dòng; chia truy vấn thành từng batch.
- KD-tree không phải lúc nào cũng : ở nhiều chiều nó có thể phải duyệt gần hết cây.
Hỏi nhanh
Cần tìm ảnh giống nhau trong 1 triệu ảnh, mỗi ảnh là một embedding 512 chiều, và mỗi truy vấn phải trả lời trong vài mili giây. Cách nào hợp lý?
Ở 512 chiều, KD-tree gần như phải duyệt cả cây. Giảm cũng không bớt được phép tính khoảng cách nào. Duyệt hết bằng vòng for Python tốn cỡ phép tính cho mỗi truy vấn. Tìm gần đúng đổi một chút độ chính xác lấy tốc độ, đúng thứ ta cần ở đây.
Cài kNN bằng NumPy
Cài lại ví dụ năm điểm ở mục Thuật toán, chưa cần thư viện. Mỗi hàng là một hồ sơ, hai cột là hai đặc trưng. Trừ truy vấn khỏi từng hàng bằng broadcasting, bình phương từng độ lệch, rồi cộng theo axis=1 để được một khoảng cách cho mỗi hàng. Không lấy căn vì căn bậc hai tăng theo đối số: xếp hạng khoảng cách bình phương cho cùng thứ tự, tránh thêm một phép tính.
import numpy as np

points = np.array([[1, 1], [2, 1], [4, 3], [5, 4], [3, 2]], dtype=float)
labels = np.array([0, 0, 1, 1, 1])
query = np.array([2, 2], dtype=float)
distance2 = np.sum((points - query) ** 2, axis=1)
order = np.argsort(distance2, kind="stable")
neighbors = order[:3]
counts = np.bincount(labels[neighbors], minlength=2)
print(distance2.astype(int).tolist())
print(neighbors.tolist(), counts.tolist(), int(np.argmax(counts)))
assert neighbors.tolist() == [1, 4, 0]
[2, 1, 5, 13, 1]
[1, 4, 0] [2, 1] 0
Chỉ số trong code bắt đầu từ 0, nên [1, 4, 0] chính là B, E, A. stable giữ thứ tự ban đầu khi khoảng cách bằng nhau; argmax chọn nhãn có chỉ số nhỏ nhất khi số phiếu hòa. Đây là hai quy tắc của bản cài này, không phải quy tắc chung của mọi thư viện. Với k=1, đổi thứ tự dữ liệu có thể đổi dự đoán ở điểm hòa khoảng cách. Trong đề chấm chính xác, phải cài quy ước đề yêu cầu.
Hỏi nhanh
Vì sao không cần lấy căn của distance2 trước khi sắp xếp?
Ta chỉ cần thứ tự để chọn láng giềng, và căn bậc hai không làm đổi thứ tự ấy. Nhưng nếu dùng trọng số thì lại cần khoảng cách thật, không được âm thầm thay bằng .
Thang đo thay đổi người hàng xóm
Xét hồ sơ truy vấn (8 điểm, 5 giờ), hai hồ sơ A (9, 5) và B (8, 6). Trong đơn vị hiện tại cả hai cách truy vấn 1. Nếu đổi giờ thành phút, B cách 60 còn A vẫn cách 1; thông tin thực tế không đổi mà thuật toán đã thiên hẳn về A. Hình dưới cho thấy đổi đơn vị kéo một trục dài ra. StandardScaler đưa các cột về cùng thang đo; còn nếu biết một cột quan trọng hơn, có thể nhân cột đó với một hệ số lớn hơn, rồi kiểm bằng validation.
Cần phân biệt chuẩn hóa theo cột với chuẩn hóa độ dài từng vector. StandardScaler thường dùng cho các đặc trưng số khác đơn vị. Với embedding dùng cosine, ta thường chia mỗi hàng cho norm của chính hàng đó. Vector toàn 0 không có hướng, nên cosine chưa xác định; cần quy tắc xử lý riêng trước khi tính.
Hỏi nhanh
Mỗi ảnh là một embedding 512 chiều, và ta tìm ảnh giống nhau bằng cosine. Muốn chạy kNN theo Euclid cho nhanh, ta chuẩn hóa thế nào?
Khi mỗi hàng có độ dài 1 thì , nên Euclid xếp hạng y như cosine. Chuẩn hóa theo cột thì đổi hướng của các vector, tức đổi chính đại lượng mà cosine đang đo. Không chuẩn hóa thì hai cách xếp hạng chỉ trùng nhau khi mọi vector có cùng độ dài.
Dùng thư viện
from sklearn.datasets import load_wine
from sklearn.model_selection import GridSearchCV
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_wine(return_X_y=True)
for scale in [False, True]:
    steps = [StandardScaler()] if scale else []
    model = make_pipeline(*steps, KNeighborsClassifier())
    grid = GridSearchCV(model, {"kneighborsclassifier__n_neighbors": [1, 3, 5, 9, 15]}, cv=5)
    grid.fit(X, y)
    print("chuẩn hóa" if scale else "không chuẩn hóa", round(grid.best_score_, 3), grid.best_params_)
không chuẩn hóa 0.725 {'kneighborsclassifier__n_neighbors': 1}
chuẩn hóa 0.966 {'kneighborsclassifier__n_neighbors': 9}
Chênh lệch lớn có lý do cụ thể: cột proline chạy từ 278 đến 1680, trong khi phần lớn các cột khác chỉ cỡ 0.1 đến 30. Chưa chuẩn hóa, proline chiếm khoảng 99.8% bình phương khoảng cách, nên kNN gần như chỉ so một cột và phải dùng để vớt vát.
Hỏi nhanh
Trong bộ wine chưa chuẩn hóa, riêng cột proline chiếm khoảng 99.8% bình phương khoảng cách. Thêm một feature hữu ích nằm trong khoảng , thì kNN với khoảng cách thô sẽ ra sao?
Độ lệch của feature mới tối đa là 1, bình phương tối đa cũng là 1, trong khi độ lệch của proline cỡ hàng trăm. Khoảng cách thô gần như không nhìn thấy feature mới. Vì vậy chuẩn hóa phải nằm trong Pipeline, trước khi thử feature hay dò .
Khi đi thi
- Đọc kỹ kiểu khoảng cách và quy tắc phá hòa trong đề.
- Chuẩn hóa các cột trước khi tính khoảng cách; đặt scaler và kNN trong cùng Pipeline khi dò .
- Có embedding thì chuẩn hóa độ dài rồi dùng kNN theo cosine làm baseline.
Tóm tắt
- kNN dự đoán theo điểm gần nhất; không có giai đoạn học tham số.
- Chuẩn hóa đặc trưng và chọn khoảng cách đúng quan trọng hơn chọn .
- nhỏ thì variance cao, lớn thì bias cao; chọn bằng cross-validation.
- Nhiều chiều thì “gần” mất nghĩa; kNN mạnh nhất trên embedding tốt.
Kiểm tra cuối bài
Mười câu kiểm cả cách hiểu, phép tính và quy trình. Câu sai chỉ ra phần cần đọc lại; hãy làm trước khi mở lời giải.
Câu 1
Năm láng giềng có nhãn [1, 0, 0, 1, 0], bỏ phiếu đều. Nhãn dự đoán là gì, và xác suất lớp 1 tính theo tỉ lệ láng giềng là bao nhiêu?
Lớp 0 có 3 phiếu, lớp 1 có 2 phiếu, nên dự đoán là lớp 0. Xác suất lớp 1 theo tỉ lệ phiếu là .
Câu 2
Câu nào về kNN luôn đúng?
Giảm làm ranh giới gấp khúc theo từng điểm, tức phức tạp hơn. Tăng thì một điểm lạ chỉ còn là một phiếu giữa nhiều phiếu. Hồi quy thì lấy trung bình của các láng giềng. Feature dạng danh mục vẫn dùng được, với một khoảng cách phù hợp như Hamming, hoặc sau khi mã hóa.
Phỏng theoCMU 10-601 · Exam 1 Practice · Q2.4
Câu 3
Hai láng giềng có khoảng cách và , target lần lượt là 0 và 6. Nếu trọng số là , dự đoán hồi quy bằng bao nhiêu?
Trung bình có trọng số là . Ra 3 là bỏ qua trọng số. Ra 1.2 là dùng nhầm .
Câu 4
Dữ liệu một chiều, điểm đã sắp xếp, phân loại hai lớp bằng 1-NN với khoảng cách Euclid. Có dựng được một quy tắc chỉ gồm các phép so sánh dạng , nối tiếp nhau, mà cho dự đoán giống hệt 1-NN trên mọi đầu vào không?
Trên một trục, mỗi điểm “sở hữu” đoạn từ trung điểm với láng giềng bên trái tới trung điểm với láng giềng bên phải. Nhãn chỉ đổi ở trung điểm giữa hai điểm kề nhau khác nhãn. Vì vậy đặt các ngưỡng đúng tại những trung điểm ấy là cho cùng dự đoán, bỏ qua quy ước tại chính trung điểm. Bài 2.5 sẽ gọi quy tắc kiểu này là cây quyết định.
Phỏng theoCMU 10-601 · Exam 1 Practice · Q2.5
Câu 5
Một kNN dùng StandardScaler fit trên train. Đổi cột thu nhập từ triệu đồng sang đồng ở cả train lẫn validation, rồi fit lại scaler đúng trên train. Bỏ qua sai số làm tròn, khoảng cách sau chuẩn hóa thay đổi thế nào?
Với hệ số đổi đơn vị dương , ta có . Đây chính là tác dụng của chuẩn hóa, khác với tình huống dùng khoảng cách thô ở câu hỏi nhanh.
Câu 6
Đề phân loại hai lớp, 30 feature số, chấm bằng macro-F1. Đề bắt buộc kNN là mô hình học có giám sát duy nhất, còn tiền xử lý thì tùy ý. Hướng làm nào hợp lý nhất?
Với kNN, khoảng cách quyết định gần như tất cả, nên chuẩn hóa và chọn feature đáng công hơn dò . Mọi bước học từ dữ liệu nằm trong Pipeline và được chọn bằng cross-validation theo đúng metric của đề. Lấy dự đoán của một mô hình có giám sát khác làm feature là trái luật đề. Còn test ẩn thì không được tham gia fit scaler.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Problem 9
Câu 7
, ba láng giềng gần nhất mang ba nhãn khác nhau A, B, C, bỏ phiếu đều. Trước khi áp quy tắc xử lý hòa của thư viện, kết quả là gì?
lẻ chỉ tránh được hòa khi có đúng hai lớp và bỏ phiếu đều. Có ba lớp thì 1–1–1 vẫn xảy ra, nên ta phải biết thư viện đang phá hòa theo cách nào.
Câu 8
Hai vector đơn vị , có cosine bằng 0.5. Bình phương khoảng cách Euclid giữa chúng bằng bao nhiêu?
.
Câu 9
Có 10 000 truy vấn và 10 000 điểm tham chiếu. Ma trận khoảng cách kiểu float64 tốn bao nhiêu byte?
Ma trận có phần tử, mỗi phần tử float64 chiếm 8 byte, nên cần byte, khoảng 800 MB. Với cỡ này vẫn nên chia thành từng đợt nhỏ thay vì tạo cả ma trận một lúc.
Câu 10
Trên cùng các fold, = 1, 5, 21 cho accuracy trên validation lần lượt là 0.76, 0.84 và 0.79. Chỉ chọn trong ba giá trị này thì chọn gì?
có điểm cao nhất trong ba giá trị đã thử, và tăng không làm điểm tăng đều trên dữ liệu này. Muốn biết ra sao thì phải chấm thật, không suy ra bằng nội suy được.
Đọc thêm
- James, Witten, Hastie, Tibshirani — An Introduction to Statistical Learning, chương 2 và 4. kNN đặt cạnh các bộ phân loại khác, với lập luận bias–variance khi chọn .
- Cover, Hart (1967) — Nearest Neighbor Pattern Classification, IEEE Transactions on Information Theory. Bài báo gốc của cận hai lần lỗi Bayes.
- scikit-learn — Nearest Neighbors. So sánh metric, brute force, KD-tree và Ball tree; chú ý phần chi phí theo số chiều.
- ISLP — Classification lab. Đối chiếu kNN với mô hình xác suất và thực hành lựa chọn k.