CNN (convolutional neural network) xếp nhiều lớp convolution nối nhau: lớp đầu dò nét, các lớp sau ghép nét thành hình phức tạp hơn, cuối cùng ra một nhãn cho cả ảnh. Nhưng thêm lớp không phải lúc nào cũng tốt hơn: mạng quá sâu có thể học kém hơn mạng nông. ResNet sửa việc này bằng đường đi tắt (skip connection), cộng thẳng đầu vào của một khối vào đầu ra của nó. Bài này xây một CNN nhỏ, so một mạng 18 lớp có và không có đường đi tắt, rồi đọc cấu trúc ResNet-18 và ResNet-50.
Từ nét đến nhãn
CNN (convolutional neural network) dùng convolution để tạo feature map, rồi activation như ReLU để ghép các đặc trưng một cách phi tuyến. Thiếu activation, hai convolution liên tiếp vẫn chỉ là một phép affine của ảnh đầu vào (không padding thì đúng bằng một convolution ), nên xếp thêm lớp không tạo được ranh giới quyết định phức tạp hơn.
CNN nhỏ ở đây dùng conv , ReLU, max pooling, rồi conv , ReLU. Global average pooling lấy trung bình mỗi feature map thành một số. Tám số đi vào linear head để tạo hai logits. Logit là điểm chưa chuẩn hóa, không phải xác suất; CrossEntropyLoss nhận trực tiếp chúng.
| Bước | Shape với ảnh xám |
|---|---|
| Ảnh đầu vào | (N, 1, 12, 12) |
| Conv 3, padding 1, ReLU | (N, 8, 12, 12) |
| MaxPool 2 | (N, 8, 6, 6) |
| Conv 3, padding 1, ReLU | (N, 8, 6, 6) |
| Global average pooling | (N, 8) |
| Linear head | (N, 2) |
Trung bình toàn ảnh khiến head không cần một trọng số riêng cho từng vị trí, và head luôn nhận đúng 8 số dù ảnh vào lớn hay nhỏ; còn nếu flatten cả feature map thì số đặc trưng đổi theo kích thước ảnh.
Global max pooling lấy giá trị lớn nhất thay cho trung bình: nó trả lời “có chỗ nào khớp mẫu không”, còn trung bình đo “khớp nhiều đến đâu trên cả ảnh”. Đổi lại, cả hai làm head mất phần lớn thông tin tọa độ. Với câu hỏi “nét đứng hay ngang”, lựa chọn này hợp lý; với câu hỏi “nét nằm bên trái hay phải”, phải giữ hoặc bổ sung thông tin vị trí.
Nhờ global pooling, đặc trưng cuối chỉ còn 512 số, nên head 10 lớp có tham số.
Hỏi nhanh
Head trả về logits (N, 2). Nhãn đưa vào CrossEntropyLoss cùng logits ấy phải có shape và kiểu gì?
Mỗi ảnh có một chỉ số lớp là 0 hoặc 1, nên nhãn là vector (N,) kiểu long. One-hot kiểu long sẽ báo lỗi, vì CrossEntropyLoss chỉ nhận target (N, 2) khi đó là xác suất kiểu float. (N, 1) float là target của BCEWithLogitsLoss với một logit; đưa vào CrossEntropyLoss thì báo lỗi “multi-target not supported”. Mask theo pixel là target của bài toán phân đoạn (bài 5.6).
Một bộ dữ liệu biết rõ quy tắc
Ta tự sinh ảnh nét đứng và ngang dài 8 ô, rộng 2 ô, đặt ở một vị trí ngẫu nhiên rồi thêm nhiễu nhỏ. Mỗi ảnh chỉ có một nét, hai lớp xuất hiện cân bằng. Vì biết chính xác quy tắc sinh, ta biết model phải học được gì: nếu model không học nổi, nghi ngờ đầu tiên là cấu trúc hay vòng train, không phải dữ liệu.
Hàm dưới đặt nét tránh sát biên. seed của train và validation khác nhau để hai tập không dùng chung dãy nhiễu. Với ảnh thật, mọi ảnh của cùng một học sinh hay cùng một buổi chụp phải nằm cùng một phía của split, như group split ở bài 1.3.
import numpy as np
import torch
from torch import nn

torch.set_num_threads(1)
torch.manual_seed(52)

def make_lines(count, seed):
    rng = np.random.default_rng(seed)
    images = np.zeros((count, 1, 12, 12), dtype=np.float32)
    labels = np.arange(count) % 2
    for index, label in enumerate(labels):
        position = int(rng.integers(3, 8))
        if label == 0:
            images[index, 0, 2:10, position:position + 2] = 1.0
        else:
            images[index, 0, position:position + 2, 2:10] = 1.0
    images += rng.normal(0, 0.04, images.shape).astype(np.float32)
    images = np.clip(images, 0, 1)
    return torch.from_numpy(images), torch.tensor(labels, dtype=torch.long)

train_images, train_labels = make_lines(80, 1)
valid_images, valid_labels = make_lines(40, 2)
print(tuple(train_images.shape), torch.bincount(train_labels).tolist())
print(tuple(valid_images.shape), torch.bincount(valid_labels).tolist())
(80, 1, 12, 12) [40, 40]
(40, 1, 12, 12) [20, 20]
Ta kiểm cả shape và số ảnh mỗi lớp trước khi train. Hai lớp cân bằng nên đoán một lớp cố định đã được accuracy 0.5; model phải vượt mức đó trên validation mới chứng tỏ học được tín hiệu.
Hỏi nhanh
make_lines chọn vị trí nét bằng rng.integers(3, 8). Bỏ nhiễu đi thì có bao nhiêu ảnh sạch khác nhau, và validation kiểm được điều gì?
integers(3, 8) cho 5 vị trí, từ 3 đến 7, không gồm 8. Nhân với hai hướng là 10 ảnh sạch, và cả 10 ảnh đều có mặt ở cả train lẫn validation. Vì vậy validation đo khả năng chịu một chút nhiễu, không đo khả năng nhận ra nét ở vị trí hay độ dài chưa gặp. 5 là quên nhân với hai hướng. 80 là coi mỗi bản có nhiễu là một mẫu mới.
Dựng model và kiểm một batch
Trước khi chạy 100 bước, ta đưa thử hai ảnh qua model: lỗi shape lộ ra ngay ở đây, chỉ tốn một giây. flatten(1) giữ chiều batch, chỉ gộp các chiều còn lại.
class TinyCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 8, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(8, 8, 3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d(1),
        )
        self.head = nn.Linear(8, 2)

    def forward(self, images):
        features = self.features(images).flatten(1)
        return self.head(features)

model = TinyCNN()
print(tuple(model(train_images[:2]).shape))
print("parameters:", sum(p.numel() for p in model.parameters()))
(2, 2)
parameters: 682
Số tham số là 682: conv đầu có , conv sau có , head có . Shape kiểm các lớp có nối đúng với nhau không; số tham số kiểm cấu trúc có đúng như thiết kế không, chẳng hạn một lớp bị thêm nhầm hay số kênh gõ sai.
Hỏi nhanh
Tensor trước head có shape (8, 16, 4, 4). Gọi flatten(0) thay cho flatten(1) thì chuyện gì xảy ra?
flatten(0) gộp từ chiều 0 tới hết: số của cả tám ảnh thành một vector, nên head không còn mỗi ảnh một hàng. flatten(1) giữ chiều batch, ra (8, 256). Gộp riêng hai chiều không gian là flatten(2). Flatten không bao giờ đổi chỗ các chiều.
Hỏi nhanh
Đổi conv thứ hai thành Conv2d(8, 16, 3, padding=1) và head thành Linear(16, 2). TinyCNN mới có bao nhiêu tham số?
Conv đầu vẫn có 80. Conv sau có . Head có . Tổng là . 1266 là quên đổi head, vẫn tính 18. 1264 là quên bias của conv sau và của head. 682 là số cũ.
Huấn luyện rồi đọc kết quả
Mỗi bước dùng cả 80 ảnh (full batch): tập nhỏ nên vừa bộ nhớ và kết quả tái lập được; với tập ảnh lớn, ta chia mini-batch bằng DataLoader. Loss và accuracy trả lời hai câu khác nhau: loss còn đo mức tự tin, còn accuracy chỉ đếm nhãn đúng.
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.02)

def evaluate(images, labels):
    model.eval()
    with torch.no_grad():
        logits = model(images)
        loss = criterion(logits, labels).item()
        accuracy = (logits.argmax(1) == labels).float().mean().item()
    return loss, accuracy

print("before:", tuple(round(v, 4) for v in evaluate(valid_images, valid_labels)))
for step in range(100):
    model.train()
    optimizer.zero_grad()
    logits = model(train_images)
    loss = criterion(logits, train_labels)
    loss.backward()
    optimizer.step()

print("train:", tuple(round(v, 4) for v in evaluate(train_images, train_labels)))
print("valid:", tuple(round(v, 4) for v in evaluate(valid_images, valid_labels)))
before: (0.6981, 0.5)
train: (0.0, 1.0)
valid: (0.0, 1.0)
Validation đi từ accuracy 0.5, đúng mức đoán bừa, lên 1.0 sau 100 bước, và train với validation khớp nhau. Kết luận được phép: cấu trúc và vòng train học được cách phân biệt hai hướng nét trong quy tắc sinh đã mô tả.
Loss in 0.0 là số đã làm tròn bốn chữ số: loss thật nhỏ hơn nhưng không bằng 0, vì logits hữu hạn không bao giờ cho xác suất đúng bằng 1.
Hình dưới lấy một ảnh validation và ba kênh có phương sai lớn nhất sau Conv + ReLU đầu tiên của model đã train. Muốn kiểm tiếp, đổi một yếu tố có lý do (nhiễu lớn hơn, nét sát biên, nét chéo) và giữ nguyên validation khi so các cấu hình.
Hỏi nhanh
Đọc thấy train: (0.0, 1.0) và valid: (0.0, 1.0), một bạn kết luận “model overfit, vì loss train đã bằng 0”. Nhận xét nào đúng?
Overfit được nhận ra qua khoảng cách giữa train và validation. Ở đây validation cũng có loss gần 0 và accuracy 1.0, nên chưa có dấu hiệu gì. 0.0 chỉ là loss đã được làm tròn, nên không suy ra được xác suất bằng 1. Lý do “loss bằng 0 nghĩa là đúng trên mọi ảnh” cũng sai: 40 ảnh validation chỉ gồm 10 ảnh sạch cộng nhiễu, nên chúng không nói gì về những ảnh nằm ngoài quy tắc sinh.
Vì sao một mạng sâu cần đường đi tắt?
Giả sử một lớp mới chưa có gì hữu ích để thêm. Ta mong mạng sâu có thể ít nhất giữ hành vi mạng nông. Nhưng một chuỗi lớp thông thường phải học lại phép giữ nguyên qua nhiều trọng số và activation. Tối ưu có thể khó dù mạng đủ khả năng biểu diễn lời giải.
Residual block viết đầu ra dưới dạng . Nhánh học phần cần thay đổi; nếu thì còn đường giữ . Bài báo ResNet đặt trọng tâm vào việc học residual để xử lý khó khăn tối ưu khi tăng chiều sâu. Mục sau dựng một block nhỏ để thấy ý tưởng; cuối bài đọc ResNet-18 và ResNet-50 thật.
Nếu tạm bỏ activation sau phép cộng, gradient có dạng
là ánh xạ giữ nguyên. Chồng nhiều block, gradient nhân các thừa số ; khai triển tích ấy luôn có số hạng , tức một đường đi về các lớp đầu mà không phải nhân qua đạo hàm của mọi nhánh. Mạng không có đường tắt (gọi là mạng plain) chỉ có tích , nhỏ dần theo cấp số nhân khi mỗi thừa số nhỏ hơn 1.
Khai triển tích thừa số cho số hạng: tín hiệu đi qua đường, mỗi đường chọn đi tắt hay đi qua nhánh ở từng block. Đường tắt không bảo đảm gradient luôn tốt: có thể triệt tiêu một phần hoặc khuếch đại nó, và ReLU sau phép cộng vẫn chặn gradient ở các ô âm.
Một mẹo hay dùng là khởi tạo của BatchNorm cuối mỗi nhánh bằng 0, để lúc đầu mỗi block đúng là identity và mạng sâu khởi đầu như một mạng nông.
Hỏi nhanh
Mười block một chiều số , không có ReLU, block nào cũng có . Gradient đi qua cả mười block được nhân với bao nhiêu khi , và khi ?
Mỗi block nhân gradient với , nên mười block cho : và . và là , chỉ giữ số hạng bậc nhất của khai triển. “Đúng bằng 1” là chỉ tính đường đồng nhất. ở cả hai là cách tính của mạng thường với . Đường tắt cho gradient một lối đi, nhưng nhánh vẫn có thể làm nó nhỏ đi hay nổ lên, nên ResNet còn cần thêm BatchNorm và khởi tạo hợp lý.
Tính thử một block. Với và , phép cộng ra . Nếu block có ReLU sau cộng, kết quả là . Cần nói rõ vị trí ReLU; “residual block” là một họ cấu trúc, không phải mọi biến thể đều giống nhau.
class ResidualBlock(nn.Module):
    def __init__(self, channels):
        super().__init__()
        self.branch = nn.Sequential(
            nn.Conv2d(channels, channels, 3, padding=1),
            nn.ReLU(),
            nn.Conv2d(channels, channels, 3, padding=1),
        )

    def forward(self, x):
        return torch.relu(x + self.branch(x))

block = ResidualBlock(8)
with torch.no_grad():
    for parameter in block.parameters():
        parameter.zero_()
positive_input = torch.ones(2, 8, 6, 6)
print(torch.equal(block(positive_input), positive_input))
mixed_input = torch.tensor([[[[2., -1.]]]]).repeat(1, 8, 1, 1)
print(block(mixed_input)[0, 0].tolist())
True
[[2.0, 0.0]]
True ở dữ liệu dương xác nhận nhánh bằng 0 giữ được đầu vào qua ReLU. Dữ liệu âm bị cắt còn 0, nên ta không gọi block này là identity trên mọi . Nếu stride làm ảnh nhỏ đi hoặc số kênh đổi, nhánh skip cần projection, thường là conv có stride phù hợp: hai tensor khác số kênh hay khác kích thước không cộng được.
Hỏi nhanh
Nhánh chính cho ra (N, 16, 3, 3), còn đường tắt là (N, 8, 6, 6). Làm cách nào để cộng được, mà vẫn đúng nghĩa?
Conv chiếu stride 2 vừa đổi 8 kênh thành 16, vừa giảm cạnh từ 6 xuống 3, nên hai tensor cùng shape và cùng nghĩa vị trí. Broadcasting chỉ kéo được chiều có kích thước 1, nên báo lỗi. reshape cũng lỗi, vì khác , và kể cả khớp số phần tử thì vị trí cũng bị trộn lẫn. Bỏ đường tắt là mất đúng thứ mà residual cần.
Mười tám lớp có và không có đường tắt
Bài 3.3 và 3.6 đã đo mạng ReLU 10 lớp khởi tạo : tín hiệu và gradient co theo cấp số nhân, còn khởi tạo He hoặc BatchNorm giữ lại được thang. Thí nghiệm sau hỏi điều mới: giữ khởi tạo mặc định, chỉ thêm phép cộng , thì gradient có về tới lớp đầu không, và đường tắt còn cần BatchNorm không?
Mạng chồng 8 block lên sau conv đầu của TinyCNN: một conv, 16 conv trong các block và lớp linear cuối, tổng cộng 18 lớp có trọng số. DeepBlock có hai công tắc: skip bật phép cộng , norm chèn BatchNorm sau mỗi conv của nhánh và bỏ bias của conv. Bốn tổ hợp dùng cùng seed, cùng dữ liệu, cùng Adam và 100 bước, nên mỗi khác biệt chỉ do công tắc.
class DeepBlock(nn.Module):
    def __init__(self, channels, skip, norm):
        super().__init__()
        Norm = nn.BatchNorm2d if norm else nn.Identity
        self.skip = skip
        self.branch = nn.Sequential(
            nn.Conv2d(channels, channels, 3, padding=1, bias=not norm),
            Norm(channels),
            nn.ReLU(),
            nn.Conv2d(channels, channels, 3, padding=1, bias=not norm),
            Norm(channels),
        )

    def forward(self, x):
        out = self.branch(x)
        return torch.relu(x + out) if self.skip else torch.relu(out)

def deep_net(skip, norm, blocks=8):
    torch.manual_seed(0)
    layers = [nn.Conv2d(1, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2)]
    layers += [DeepBlock(8, skip, norm) for _ in range(blocks)]
    layers += [nn.AdaptiveAvgPool2d(1), nn.Flatten(), nn.Linear(8, 2)]
    return nn.Sequential(*layers)

def train_deep(net, steps=100):
    optimizer = torch.optim.Adam(net.parameters(), lr=0.01)
    losses = []
    for step in range(steps):
        net.train()
        optimizer.zero_grad()
        loss = criterion(net(train_images), train_labels)
        loss.backward()
        if step == 0:
            first_grad = net[0].weight.grad.norm().item()
        optimizer.step()
        losses.append(loss.item())
    net.eval()
    with torch.no_grad():
        accuracy = (net(valid_images).argmax(1) == valid_labels).float().mean().item()
    return first_grad, losses, accuracy

curves = {}
for name, skip, norm in [
    ("plain", False, False),
    ("plain + BN", False, True),
    ("residual", True, False),
    ("residual + BN", True, True),
]:
    grad, losses, accuracy = train_deep(deep_net(skip, norm))
    curves[name] = losses
    print(f"{name:<13} grad {grad:.1e}  loss@10 {losses[10]:.4f}  max {max(losses):7.4f}"
          f"  loss@99 {losses[-1]:.4f}  valid {accuracy}")
plain grad 2.5e-11 loss@10 0.6935 max 0.6980 loss@99 0.6931 valid 0.5
plain + BN grad 4.1e-01 loss@10 0.3354 max 0.7324 loss@99 0.0034 valid 1.0
residual grad 3.1e-02 loss@10 0.7010 max 19.1213 loss@99 0.0006 valid 1.0
residual + BN grad 2.6e-01 loss@10 0.0061 max 0.7157 loss@99 0.0001 valid 1.0
Cột grad là norm gradient của conv đầu ở bước đầu tiên; loss@10 và loss@99 là loss train sau 10 và 99 bước cập nhật; max là loss lớn nhất trong 100 bước. Đọc theo từng hàng:
- Plain, không BatchNorm không học gì: gradient tới conv đầu chỉ còn , loss đứng ở và validation 0.5, đúng mức đoán đều hai lớp. Đây vẫn là hiện tượng của bài 3.3: khởi tạo mặc định của PyTorch nhỏ hơn He, nên qua 17 conv + ReLU, phần tín hiệu phụ thuộc ảnh và gradient đi về đều co theo cấp số nhân.
- Plain + BN học được: BatchNorm kéo thang về sau mỗi conv, như ở bài 3.6.
- Residual, không BatchNorm là hàng mới: cùng khởi tạo, chỉ thêm phép cộng , gradient tới conv đầu lớn hơn khoảng lần. Đó là số hạng trong tích các thừa số ở mục trước: một lối đi về conv đầu không phải nhân qua các nhánh đang co. Mạng học tới loss 0.0006 mà không cần BatchNorm hay khởi tạo He, nhưng không ổn định: không gì giữ thang tín hiệu, nên khi các nhánh lớn lên trong lúc train, phần mỗi block cộng thêm vào dồn lại qua 8 block, logits phình ra và có bước loss vọt lên 19.1213.
- Residual + BN đi nhanh nhất: sau 10 bước loss đã là 0.0061, trong khi plain + BN còn 0.3354.
Đây đúng là công thức của ResNet: phép cộng giữ đường đi cho gradient, BatchNorm giữ thang của tín hiệu.
Bài báo ResNet thấy cùng hình ảnh ở quy mô lớn: trên ImageNet, mạng plain 18 lớp và ResNet-18 đạt độ chính xác gần nhau nhưng ResNet-18 hội tụ nhanh hơn; lên 34 lớp, mạng plain dù có BatchNorm lại có lỗi train cao hơn mạng plain 18 lớp, còn ResNet-34 tốt hơn ResNet-18. Mạng sâu hơn biểu diễn được mọi thứ mạng nông làm được (các lớp thừa chỉ cần là identity), nên lỗi train cao hơn là dấu hiệu khó tối ưu, không phải overfit.
Hỏi nhanh
Theo bốn dòng output, thí nghiệm này hỗ trợ kết luận nào?
Hai hàng có BatchNorm chỉ khác nhau ở phép cộng : sau 10 bước, residual cùng BN còn loss 0.0061, mạng thường cùng BN còn 0.3354. Residual không có BatchNorm có một bước loss vọt lên 19.1213, nên riêng đường tắt chưa đủ ổn định. Ở 18 lớp, mạng thường cùng BN vẫn học được, nhưng thí nghiệm không nói gì về mạng từ 34 lớp trở lên, nơi bài báo ResNet thấy mạng thường dù có BatchNorm vẫn train kém hơn mạng nông. Mạng thường kẹt ở 0.6931 ngay trên train, tức chưa học được gì, trái ngược với học thuộc.
Từ block nhỏ đến ResNet-18 và ResNet-50
ResNet thật ghép các block như DeepBlock(8, skip=True, norm=True) thành bốn stage. Cấu trúc:
- Stem (phần đầu): conv stride 2 và max pooling stride 2, giảm ảnh còn .
- Bốn stage: từ stage thứ hai, block đầu của mỗi stage dùng stride 2 để chia đôi cạnh và nhân đôi số kênh; đường tắt của block ấy là projection: conv stride 2 kèm BatchNorm.
- Cuối mạng: global average pooling và một lớp linear ra 1000 lớp của ImageNet.
weights=None dựng kiến trúc với trọng số ngẫu nhiên, không tải gì từ Internet.
from torchvision.models import resnet18, resnet50

resnet = resnet18(weights=None).eval()  # chỉ dựng kiến trúc, trọng số ngẫu nhiên
h = torch.zeros(1, 3, 224, 224)
with torch.no_grad():
    h = resnet.maxpool(resnet.relu(resnet.bn1(resnet.conv1(h))))
    print("stem  ", tuple(h.shape))
    for name in ["layer1", "layer2", "layer3", "layer4"]:
        h = getattr(resnet, name)(h)
        print(name, tuple(h.shape))
print(resnet.layer2[0].downsample[0])

def conv_parameters(module):
    return sum(m.weight.numel() for m in module.modules() if isinstance(m, nn.Conv2d))

resnet_50 = resnet50(weights=None)
print("ResNet-18:", sum(p.numel() for p in resnet.parameters()))
print("ResNet-50:", sum(p.numel() for p in resnet_50.parameters()))
print("bottleneck layer1[1]:", conv_parameters(resnet_50.layer1[1]))
stem (1, 64, 56, 56)
layer1 (1, 64, 56, 56)
layer2 (1, 128, 28, 28)
layer3 (1, 256, 14, 14)
layer4 (1, 512, 7, 7)
Conv2d(64, 128, kernel_size=(1, 1), stride=(2, 2), bias=False)
ResNet-18: 11689512
ResNet-50: 25557032
bottleneck layer1[1]: 69632
Đọc output:
- Cạnh ảnh giảm 32 lần (năm lần chia đôi) từ đầu vào đến
layer4: ảnh 224 cho map , ảnh 448 cho . Số kênh tăng từ 64 lên 512. - Dòng
Conv2d(64, 128, ..., stride=(2, 2), bias=False)là projection của block đầulayer2. - Số 18 đếm các lớp có trọng số: conv stem, 16 conv trong 8 block cơ bản (mỗi block hai conv ) và lớp linear cuối; projection không tính.
- Một block cơ bản 64 kênh có trọng số conv cộng 256 tham số , của hai BatchNorm.
Ở ResNet-50, layer2 trả (B, 512, 28, 28) và layer4 trả 2048 kênh; cả mạng có khoảng 25.6 triệu tham số, ResNet-18 khoảng 11.7 triệu.
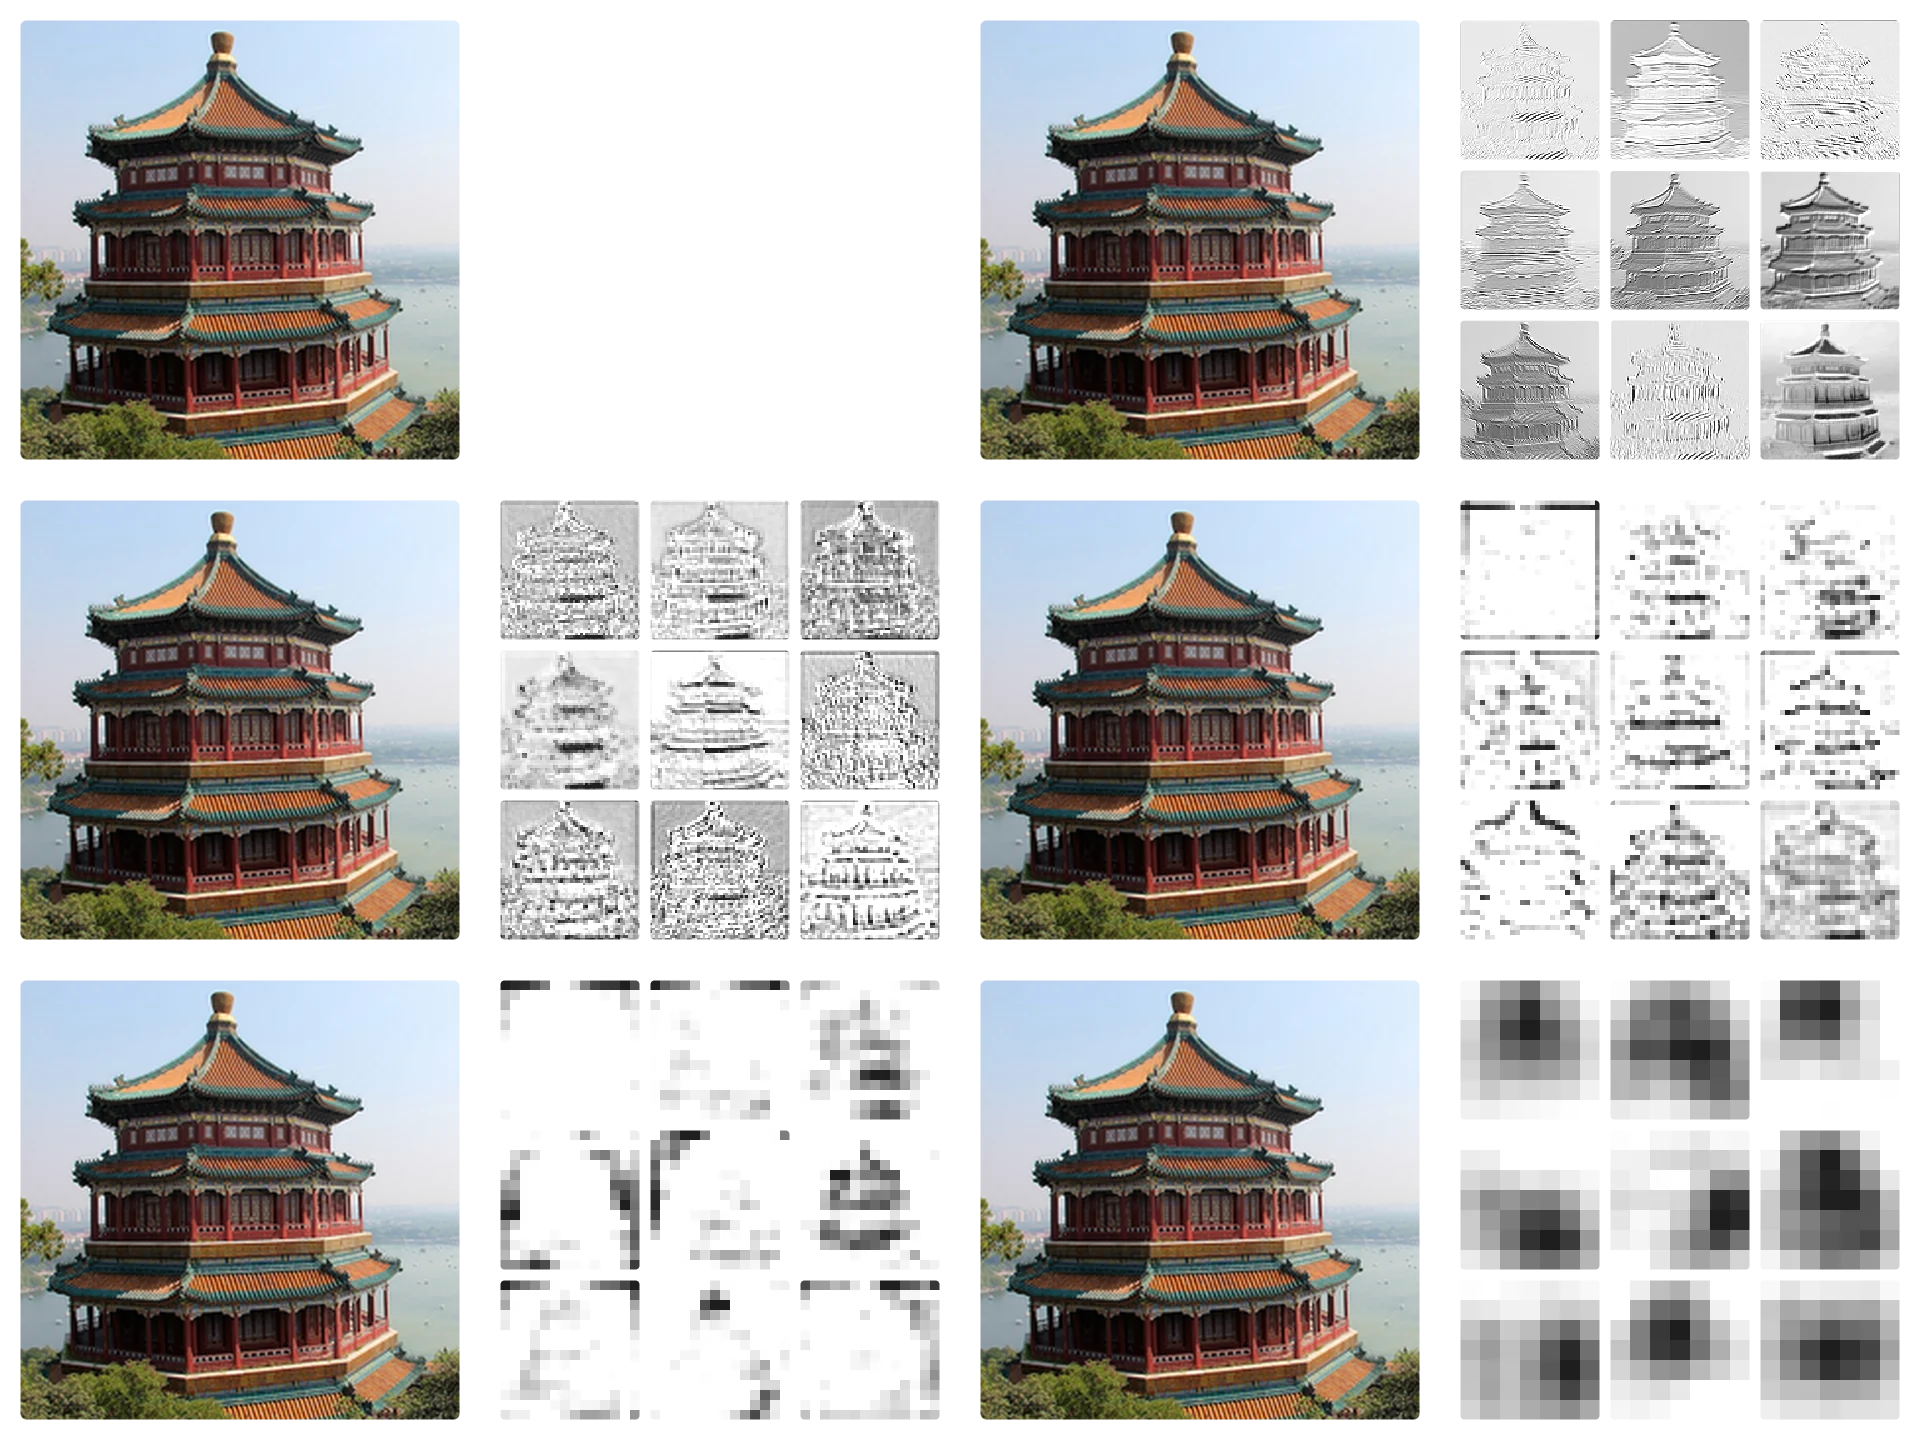
ResNet-50 trở lên dùng bottleneck: conv thu hẹp số kênh, conv làm việc ở chiều hẹp, rồi conv mở rộng lại gấp 4. Ở layer1, block nhận và trả 256 kênh nhưng conv chỉ chạy ở 64 kênh: tham số, khớp dòng cuối của output. Hai conv chạy thẳng ở 256 kênh cần , gấp gần 17 lần. Nhờ vậy ResNet-50 sâu gần gấp ba ResNet-18 mà chỉ nhiều tham số khoảng 2.2 lần.
Mọi conv trong ResNet đều có bias=False: BatchNorm ngay sau trừ mean theo từng kênh, nên hằng số bias cộng vào cả kênh bị trừ đi đúng bằng nó; việc dịch chuyển do của BatchNorm đảm nhận.
Hỏi nhanh
Conv2d(64, 128, 3) đứng ngay trước BatchNorm2d(128). Để bias=True thì thêm bao nhiêu tham số, và chúng có tác dụng gì không?
Mỗi kênh ra có một bias, tức 128. Bias cộng cùng một hằng số vào mọi vị trí của kênh, nên mean của kênh tăng đúng bằng nó, và BatchNorm trừ đi hết. Output không đổi dù bias là bao nhiêu, và gradient theo bias bằng 0. 8192 là , số cặp kênh vào và ra, không phải số bias.
Mạng cho điện thoại như MobileNet tiết kiệm hơn nữa bằng depthwise separable convolution: conv với groups bằng số kênh vào, mỗi bộ lọc chỉ đọc một kênh (depthwise), rồi conv trộn các kênh (pointwise). Số tham số không bias đi từ xuống , nhỏ hơn gần lần khi lớn; số phép nhân–cộng giảm cùng tỉ lệ. Ví dụ từ 32 ra 64 kênh: 18 432 trọng số thường, còn khi tách.
Khi một model đã fine-tune chạy quá chậm trên điện thoại, thử kiến trúc nhẹ như MobileNet, ảnh đầu vào nhỏ hơn hoặc trọng số lượng tử hóa.
Hỏi nhanh
nn.Conv2d(64, 64, 3, groups=64, bias=False).weight.shape là gì?
Weight có shape : mỗi kênh ra chỉ đọc một kênh vào, tổng cộng 576 tham số thay vì của conv thường. (64, 64, 3, 3) là conv thường. (1, 64, 3, 3) là một bộ lọc đọc cả 64 kênh. PyTorch luôn giữ đủ bốn chiều, nên không có (64, 3, 3).
CNN và ResNet đang giả định gì?
CNN và ResNet vẫn dựa vào tính cục bộ, chia sẻ trọng số và việc ghép nhiều mức chi tiết. Đường tắt giúp tối ưu mạng sâu; nó không thêm dữ liệu và không chống học thuộc.
Train từ đầu ResNet-50 với hơn 25 triệu tham số trên vài trăm ảnh dễ học thuộc tập train, trong khi một CNN nhỏ có thể tổng quát tốt hơn. Trọng số pretrained trên ImageNet có ích khi đặc trưng chuyển được sang ảnh mới (bài 5.3); ảnh y khoa, camera hồng ngoại hay ký hiệu rất nhỏ khác xa ImageNet, nên phải so với baseline trên cùng validation trước khi tin.
Với ảnh nét phấn thật, thứ tự hợp lý là: TinyCNN làm baseline dễ debug, rồi một ResNet nhỏ train từ đầu hoặc encoder ResNet pretrained thay head (nếu đề cho phép), so tất cả trên cùng split và metric.
Hỏi nhanh
Có 300 ảnh, đề cấm dùng model pretrained. ResNet-50 train từ đầu đạt 100% trên train, 55% trên validation. Một CNN nhỏ đạt 85% trên train, 78% trên validation. Bước tiếp theo hợp lý là gì?
ResNet-50 đã có residual và đã tối ưu tốt, đạt 100% trên train. Khoảng cách 45 điểm giữa train và validation là học thuộc, thứ mà đường tắt không chữa được. Chọn theo accuracy trên train là chọn model học thuộc giỏi nhất. ResNet-101 thêm tham số, làm học thuộc nặng hơn. Mạng nhỏ đang tổng quát tốt hơn, và augmentation, weight decay hay dropout có thể kéo nó lên thêm.
Khi đi thi
- Chạy một batch qua model, in shape sau từng stage và đếm tham số trước khi train.
- Bắt đầu bằng CNN nhỏ hoặc ResNet-18; chỉ tăng độ sâu khi loss train còn cao.
- Đề cho phép pretrained thì thay head của ResNet pretrained và dùng đúng preprocessing của checkpoint.
Tóm tắt
- CNN ghép các feature map cục bộ thành nhãn ảnh qua activation, pooling và head; global average pooling cho head số đặc trưng cố định nhưng xóa phần lớn thông tin vị trí.
- Mạng plain sâu có thể không học nổi vì tín hiệu và gradient tắt dần qua nhiều lớp.
- Residual giữ một đường đi thẳng cho gradient; BatchNorm giữ thang của tín hiệu. Hai nhánh phải cùng shape, dùng projection khi đổi kênh hay stride.
- ResNet ghép các block thành bốn stage; ResNet-50 dùng bottleneck để sâu mà vẫn gọn.
- Đường tắt giúp tối ưu, không chống được học thuộc.
Kiểm tra cuối bài
Câu 1
Trong TinyCNN, mỗi ô của feature map sau conv thứ hai, có shape (N, 8, 6, 6), chịu ảnh hưởng của một vùng ảnh đầu vào rộng bao nhiêu?
Conv đầu cho mỗi ô một vùng 3 ô. MaxPool 2 gộp hai ô liền nhau thành một vùng 4 ô, và hai ô kề nhau sau pooling cách nhau 2 pixel. Conv sau pooling đọc ba ô cách nhau 2, nên vùng là . là của hai conv liền nhau không có pooling. là nhầm với kích thước feature map. là cả ảnh, chỉ đạt được sau global average pooling. Một nét dài 8 ô vừa nằm trọn trong một vùng.
Câu 2
Trên ảnh vật thể , một đội so một CNN chỉ có hai lớp conv liền nhau với ResNet-18, cùng dữ liệu và cùng số epoch, và ResNet-18 có validation cao hơn hẳn. Lý do chính là gì?
Hai conv liền nhau chỉ nhìn một vùng của ảnh 224 pixel, đủ thấy cạnh nhưng không thấy hình dạng. Mạng sâu có receptive field lớn dần qua từng stage, nên học được đặc trưng theo tầng bậc: lớp đầu bắt cạnh, lớp giữa ghép thành kết cấu và bộ phận, lớp cuối đọc ra vật thể. ResNet-18 chạy chậm hơn, và có khoảng 11.7 triệu tham số, nhiều hơn hẳn. Mạng sâu cũng khó train hơn mạng nông; đó chính là lý do cần residual.
Câu 3
TinyCNN được train trên ảnh . Một bản khác thay AdaptiveAvgPool2d(1) bằng Flatten() và head Linear(288, 2). Đưa ảnh test vào hai model thì sao?
Ảnh qua pooling còn , feature map có shape (N, 8, 8, 8). Global average pooling lấy trung bình mỗi kênh nên vẫn ra 8 số. Flatten ra số, không khớp với 288 của Linear, và PyTorch báo mat1 and mat2 shapes cannot be multiplied. Chạy được chưa có nghĩa là dự đoán đúng: dữ liệu khác kích thước vẫn phải được kiểm trên validation có cùng kích thước ấy.
Câu 4
Bảng cấu hình ResNet-152 có conv , BatchNorm, pooling và phép cộng đường tắt. Thành phần nào là đóng góp riêng của ResNet, giúp train được mạng hơn 100 lớp?
Đường tắt là ý tưởng mới của ResNet: mỗi block chỉ học phần sửa , và gradient có lối đi thẳng qua phép cộng. BatchNorm có từ trước ResNet (Ioffe và Szegedy, 2015). ResNet dùng lại nó, và chính bài báo ResNet cho thấy mạng thường 34 lớp, dù có BatchNorm, vẫn train kém hơn mạng 18 lớp. Các block của ResNet giữ bộ lọc như VGG. Thêm pooling chỉ làm ảnh nhỏ đi, không giúp gradient đi qua 100 lớp.
Câu 5
Một chuỗi 10 neuron một chiều có đường tắt: , với , là sigmoid và mọi . Đạo hàm nằm trong khoảng nào?
Mỗi lớp cho , với , nên mỗi thừa số nằm trong . Tích của mười thừa số nằm giữa 1 và . Bỏ đường tắt đi, cùng chuỗi ấy chỉ còn tích các , với cận trên : đó là vanishing gradient. “Đúng bằng 1” là chỉ tính đường đồng nhất, bỏ qua phần đóng góp của các nhánh.
Phỏng theoCMU 10-601 · Exam 2 Practice · Q4.5
Câu 6
Một đội train hai CNN thường, không có đường tắt, cùng dữ liệu, cùng BatchNorm và khởi tạo He. Mạng 20 lớp có lỗi 6% trên train, 9% trên validation. Mạng 56 lớp có lỗi 11% trên train, 14% trên validation. Chẩn đoán và cách sửa nào hợp lý?
Mạng 56 lớp tệ hơn ngay trên train, nên không phải overfit; overfit thì lỗi train thấp, validation cao. Nó biểu diễn được mọi thứ mạng 20 lớp làm được, nên vấn đề nằm ở việc tối ưu. Residual cho gradient một lối đi thẳng qua các block, và giúp mỗi block dễ học gần phép đồng nhất. Clip gradient chữa gradient bùng nổ, mà ở đây không có dấu hiệu loss nổ. Giảm số kênh làm mạng yếu đi mà không gỡ được khó khăn của việc tối ưu.
Phỏng theoNOAI 2025 Singapore · Phần 1 · Câu 9
Câu 7
Mỗi block tính , không có ReLU sau phép cộng, và nhánh là conv, ReLU, rồi conv. Khởi tạo conv cuối của mọi nhánh bằng 0, cả weight lẫn bias. Ở bước train đầu tiên, mạng 50 block hoạt động thế nào?
nên mỗi block trả về nguyên : mạng sâu bắt đầu như một mạng nông, tín hiệu và gradient đi thẳng qua 50 block, và đầu ra là chứ không phải 0. Gradient theo weight của conv cuối là gradient ở đầu ra nhân với đầu vào của nó, tức , khác 0. Gradient về conv đầu phải đi qua weight của conv cuối, đang bằng 0, nên ở bước đầu nó bằng 0, sang bước sau mới có. torchvision có tùy chọn zero_init_residual, làm cùng ý tưởng ấy với của BatchNorm cuối nhánh.
Câu 8
Đưa ảnh , cỡ của CIFAR-10, vào ResNet-18 của torchvision, giữ nguyên phần stem cho ImageNet. Output của layer4 có kích thước không gian bao nhiêu?
Conv stem stride 2 đưa xuống . Max pooling stride 2 đưa xuống . layer1 giữ 8. layer2, layer3, layer4 mỗi stage chia đôi: . Tổng cộng giảm 32 lần, như trong code của bài; là chép đúng con số ấy. layer3 và layer4 chỉ còn rồi vị trí cho conv làm việc, nên bản ResNet cho CIFAR thường thay stem bằng conv stride 1 và bỏ max pooling.
Câu 9
Thay một conv thường, từ 64 lên 128 kênh, bằng depthwise separable: depthwise trên từng kênh, tức groups=64, rồi pointwise lên 128 kênh. Mọi conv đều không có bias. Số tham số trước và sau là bao nhiêu?
Conv thường có tham số. Depthwise có , pointwise có , tổng cộng , ít hơn khoảng 8.4 lần, và số phép nhân cộng tại mỗi vị trí cũng giảm theo cùng tỉ lệ. là tính depthwise như một conv đầy đủ từ 64 sang 64. là conv groups=64 đi thẳng lên 128 kênh mà thiếu bước pointwise trộn các kênh. là quên của conv thường.
Phỏng theoNOAI 2025 Singapore · Phần 1 · Câu 14
Câu 10
Đề cho 4000 ảnh , 10 lớp, chấm bằng accuracy, cấm dùng model pretrained, ngân sách 3 giờ GPU. Kế hoạch nào hợp lý nhất?
Mạng nhỏ cho ra một bản nộp được chỉ sau vài phút, và checkpoint theo validation giữ model tốt nhất phòng khi hết giờ. Còn thời gian thì mới tăng độ sâu hay thêm augmentation. ResNet-152 có hơn 60 triệu tham số, trên 4000 ảnh rất dễ học thuộc, và checkpoint cuối chưa chắc là tốt nhất. Dùng model pretrained là trái luật đề. Bỏ validation từ đầu thì không còn gì để chọn checkpoint hay so các cấu hình. Gộp lại để train lần cuối chỉ hợp lý sau khi đã chọn xong cấu hình.
Đọc thêm
- He và cộng sự — Deep Residual Learning for Image Recognition: đọc vấn đề tối ưu khi tăng chiều sâu và ý tưởng học residual.
- PyTorch — Defining a Neural Network: đối chiếu cách tổ chức
nn.Modulevàforward. - Howard và cộng sự — MobileNets: depthwise separable convolution và cách đổi độ chính xác lấy tốc độ trên thiết bị nhỏ.
- Dive into Deep Learning — ResNet: xem biến thể có projection và cấu trúc nhiều stage; block minh họa của bài nhỏ hơn mạng trong sách.
Nguồn ảnh: ảnh tháp là ảnh mẫu china.jpg kèm scikit-learn (danielbuechele, Flickr, CC BY 2.0).
Tải gói recipe của chương — gồm các module phụ và hướng dẫn chuẩn bị asset.