Optimizer quyết định dùng gradient để cập nhật trọng số thế nào. Gradient descent thường (SGD) gặp khó khi loss dốc theo hướng này nhưng thoải theo hướng khác: learning rate nhỏ thì đi chậm, lớn thì dao động mạnh. Momentum và Adam khắc phục bằng cách nhớ các bước trước và điều chỉnh độ dài bước cho từng trọng số. Bài này so sánh SGD, momentum và Adam trên một hàm loss đơn giản trước khi dùng cho mạng thật.
Gradient chỉ độ dốc, optimizer chọn bước
Các thuật toán dùng gradient để cập nhật trọng số, như SGD hay Adam, gọi chung là optimizer. Cùng một gradient, mỗi optimizer đi một bước khác nhau.
SGD cập nhật , với learning rate quyết định độ dài bước. Chữ stochastic (ngẫu nhiên) đến từ việc tính trên một minibatch lấy ngẫu nhiên thay vì trên toàn bộ dữ liệu. Gradient của một minibatch lệch khỏi gradient đầy đủ một ít, nhưng khi minibatch được lấy ngẫu nhiên đều thì kỳ vọng của nó đúng bằng gradient đầy đủ: mỗi bước rẻ hơn nhiều, đổi lại đường đi hơi nhiễu.
Có ba cỡ dữ liệu cho mỗi bước:
- Gradient descent dùng cả tập: gradient chính xác nhưng mỗi bước đắt.
- SGD thuần dùng một mẫu: rất rẻ nhưng rất nhiễu; một epoch bước tốn cỡ một bước trên cả tập mà cập nhật được lần.
- Minibatch đứng giữa và là cách dùng mặc định.
Nhiễu của gradient minibatch có độ lệch chuẩn tỉ lệ : tăng batch từ 16 lên 64 thì nhiễu giảm một nửa, còn batch quá nhỏ làm đường đi chập chờn. Tăng batch lần thì số bước mỗi epoch giảm lần; quy tắc tỉ lệ tuyến tính cho SGD nhân learning rate với , thường kèm warmup, và vẫn phải kiểm lại trên validation.
Hỏi nhanh
So gradient tính trên một minibatch (SGD) với gradient tính trên toàn bộ dữ liệu (GD). Câu nào đúng?
Nếu minibatch được lấy ngẫu nhiên đều, thì trung bình trên mọi cách lấy đúng bằng gradient đầy đủ. Từng bước SGD vẫn có thể đi lệch, thậm chí ra xa nghiệm, vì gradient của một minibatch có nhiễu. Nhiễu lấy mẫu là của SGD; GD dùng mọi mẫu nên không có. Lồi chặt không phải điều kiện bắt buộc: gradient descent vẫn hội tụ trên nhiều hàm không lồi chặt khi learning rate phù hợp.
Phỏng theoCMU 10-601 · Exam 2 Practice · Q1.3
Một mặt loss kiểm nhỏ là . Gradient thay đổi gắt theo chiều , nên một bước SGD tách thành hai phép nhân độc lập: và . Chiều chỉ ổn định khi , tức ; ngay cả với sát , chiều vẫn chỉ được nhân mỗi bước.
Tổng quát với hàm bậc hai, chiều cong nhất (trị riêng lớn nhất của Hessian, ở đây 16) đặt ngưỡng , còn chiều thoải nhất (ở đây 2) quyết định tốc độ. Độ cong hai chiều càng chênh, thung lũng càng hẹp và SGD càng chậm. Con số là ngưỡng của riêng hàm này; trong mạng neural, độ cong đổi theo từng vùng của mặt loss.
Hỏi nhanh
Đổi mặt loss thành . Learning rate của SGD phải dưới ngưỡng nào thì chiều không nổ?
Gradient theo là , nên mỗi bước nhân với . Cần , tức . Ngưỡng là quên hệ số 2 khi lấy đạo hàm bình phương. là điều kiện để không đổi dấu, tức không đi zigzag, chưa phải điều kiện hội tụ. chỉ là ngưỡng của chiều . Ngay dưới , chiều chỉ được nhân mỗi bước: thung lũng càng hẹp thì SGD càng chậm.
Nếu biết độ cong của mọi chiều, có thể chia bước cho độ cong: phương pháp Newton nhân gradient với nghịch đảo Hessian (ma trận đạo hàm bậc hai). Trên hàm bậc hai lồi, một bước Newton tới thẳng cực tiểu từ bất kỳ đâu; vì vậy với ít tham số, như logistic regression, Newton cần rất ít bước dù mỗi bước đắt.
Cái giá nằm ở kích thước. Mạng có tham số có Hessian ; với đã là phần tử, và nghịch đảo tốn cỡ phép tính mỗi bước, trong khi phép cập nhật bậc một chỉ tốn cỡ phép tính sau khi backward đã cho gradient. Vì vậy deep learning dùng optimizer bậc một; momentum và Adam là những cách rẻ để bù một phần độ cong mà không cần dựng Hessian.
Momentum nhớ hướng trước
Một quy ước thường dùng, cũng là dạng SGD momentum của PyTorch khi không bật dampening hay Nesterov, là
cộng dồn gradient với hệ số nhớ . Gradient cùng dấu qua nhiều bước thì được cộng lên, bước dài dần; gradient đổi dấu qua lại thì triệt nhau một phần. Vì vậy momentum tiến nhanh dọc đáy thung lũng thoải và hãm dao động ở chiều dốc, nhưng quán tính quá lớn cũng đưa đường đi vượt đáy. là trạng thái số được optimizer lưu giữa các bước, không phải vận tốc vật lý.
Hỏi nhanh
cũ bằng 2, gradient mới bằng , . Theo quy ước , mới bằng bao nhiêu?
: hướng đi vẫn dương, vì ký ức của bước trước chưa mất hết. là bước SGD thuần, bỏ qua cũ. đúng độ lớn nhưng sai dấu, nhầm với hướng đi . là trừ gradient như khi cập nhật , trong khi thì cộng gradient.
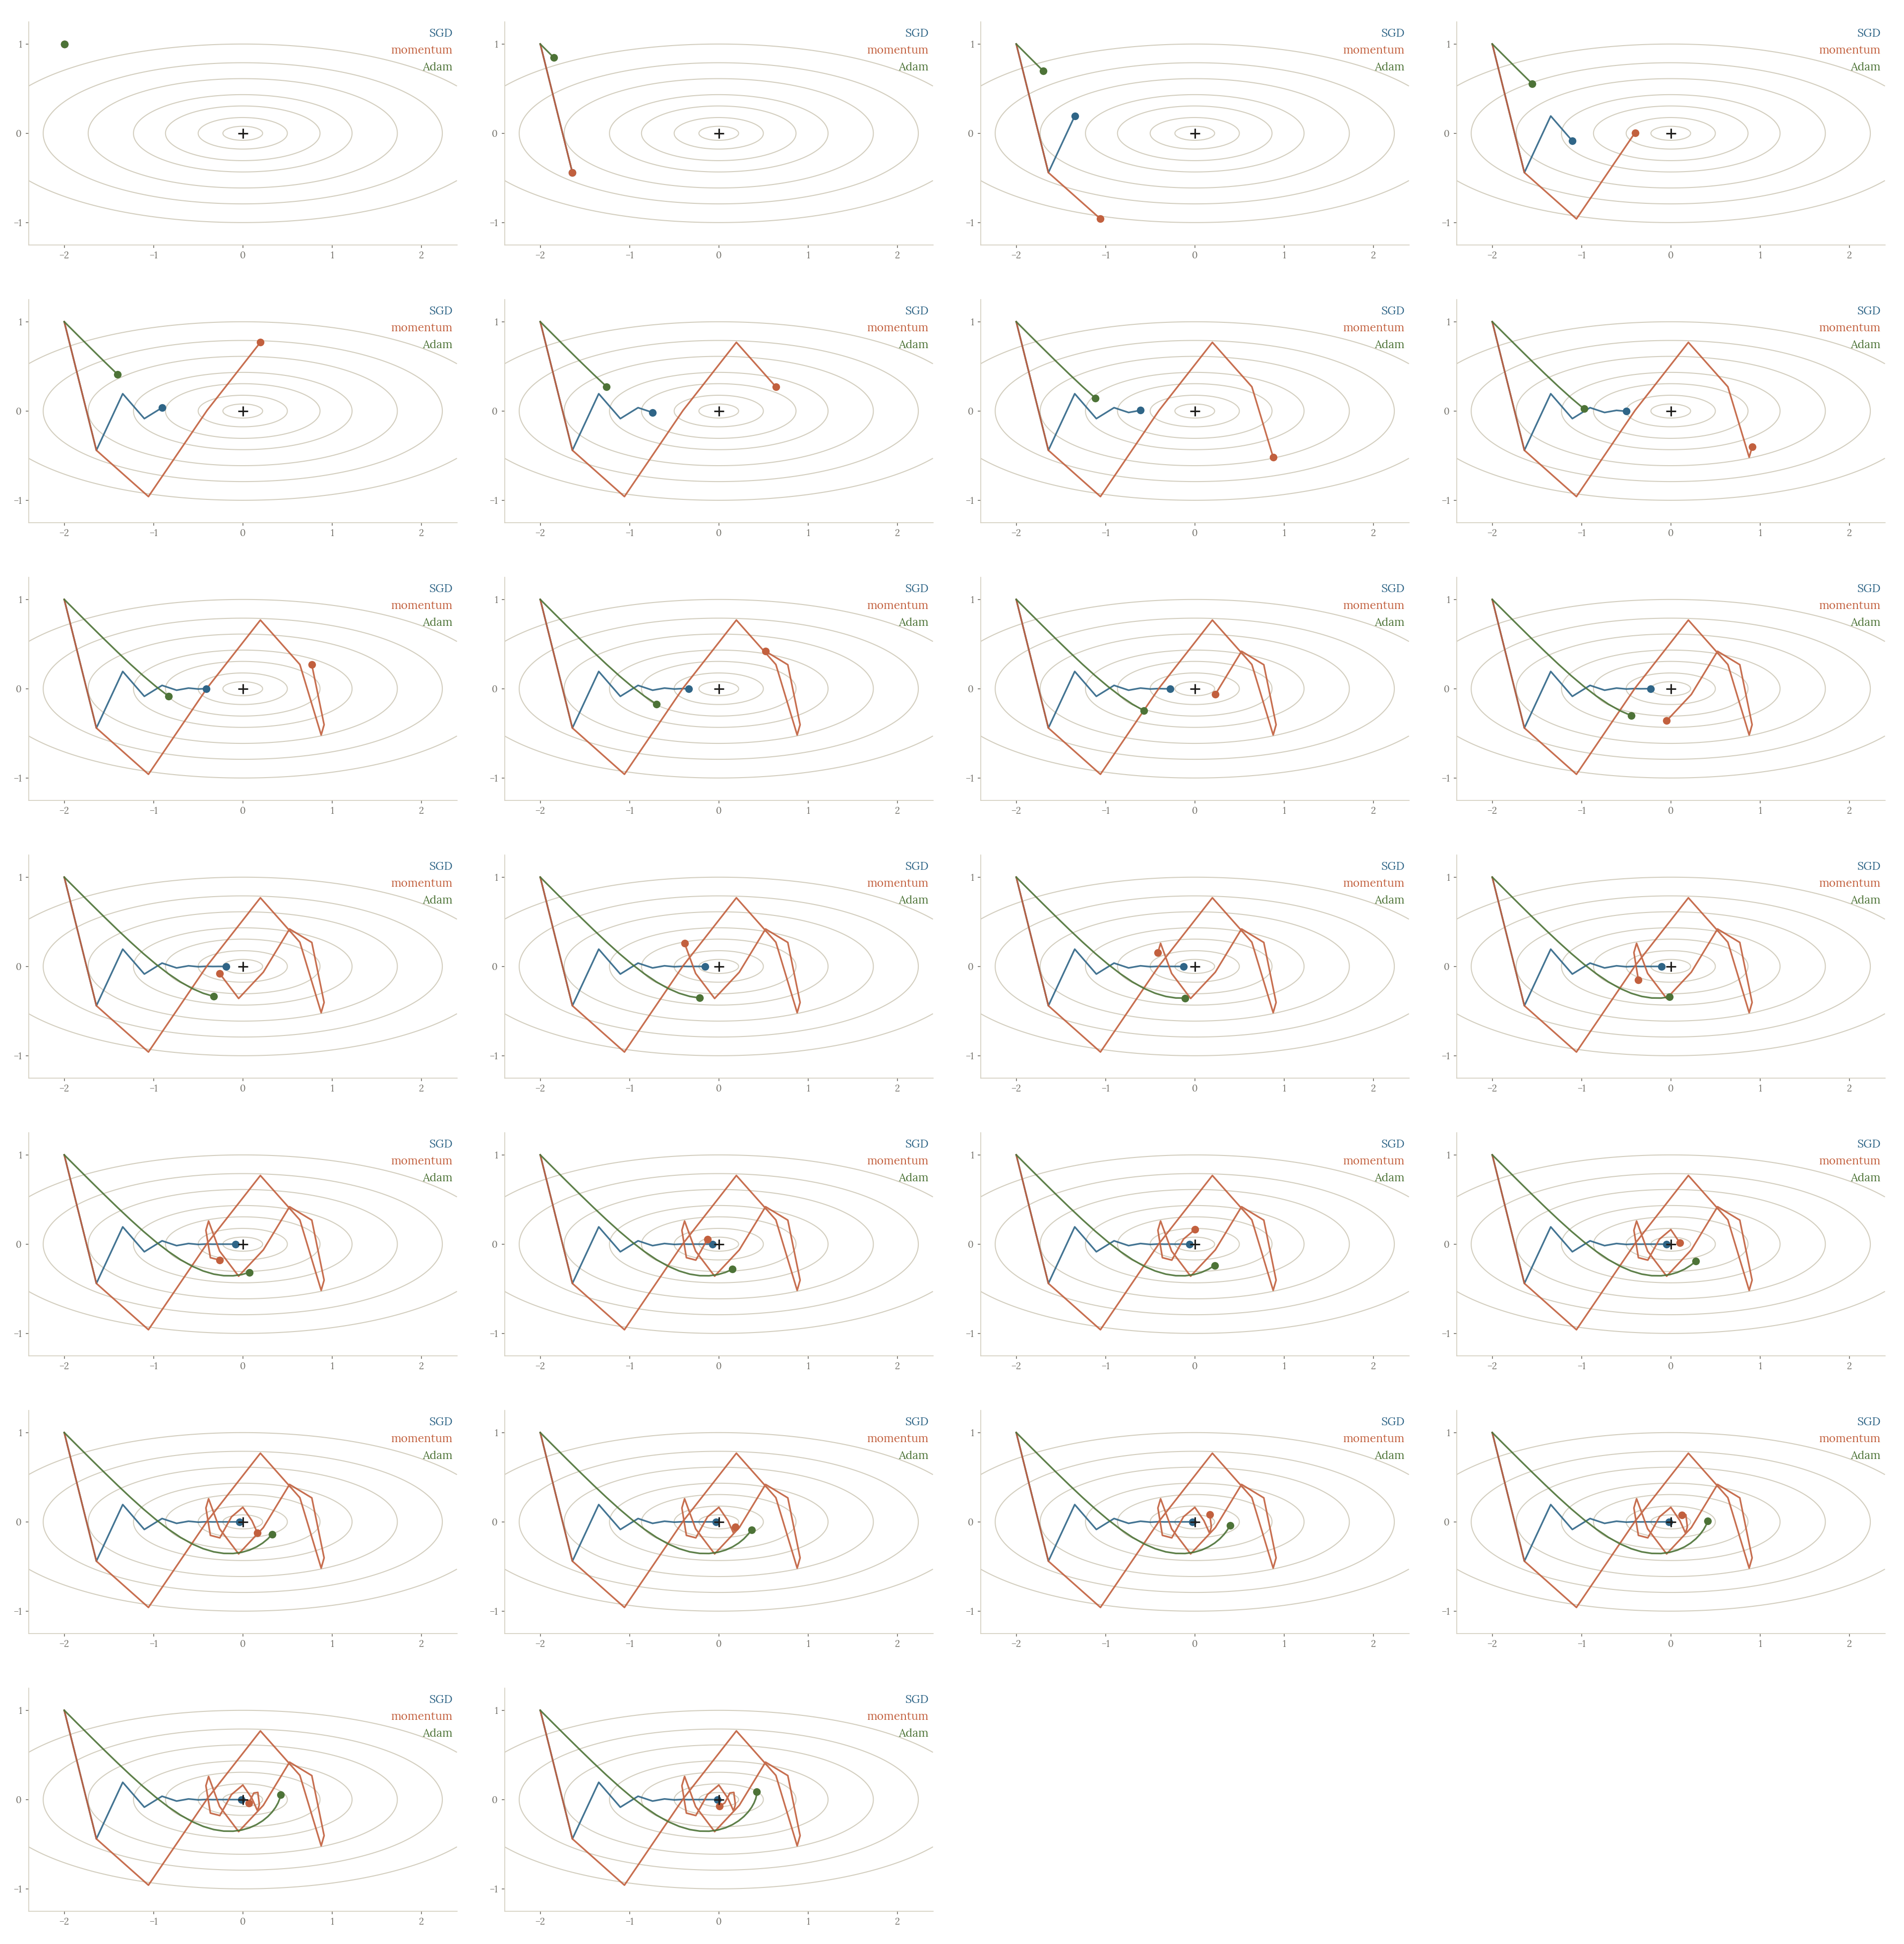
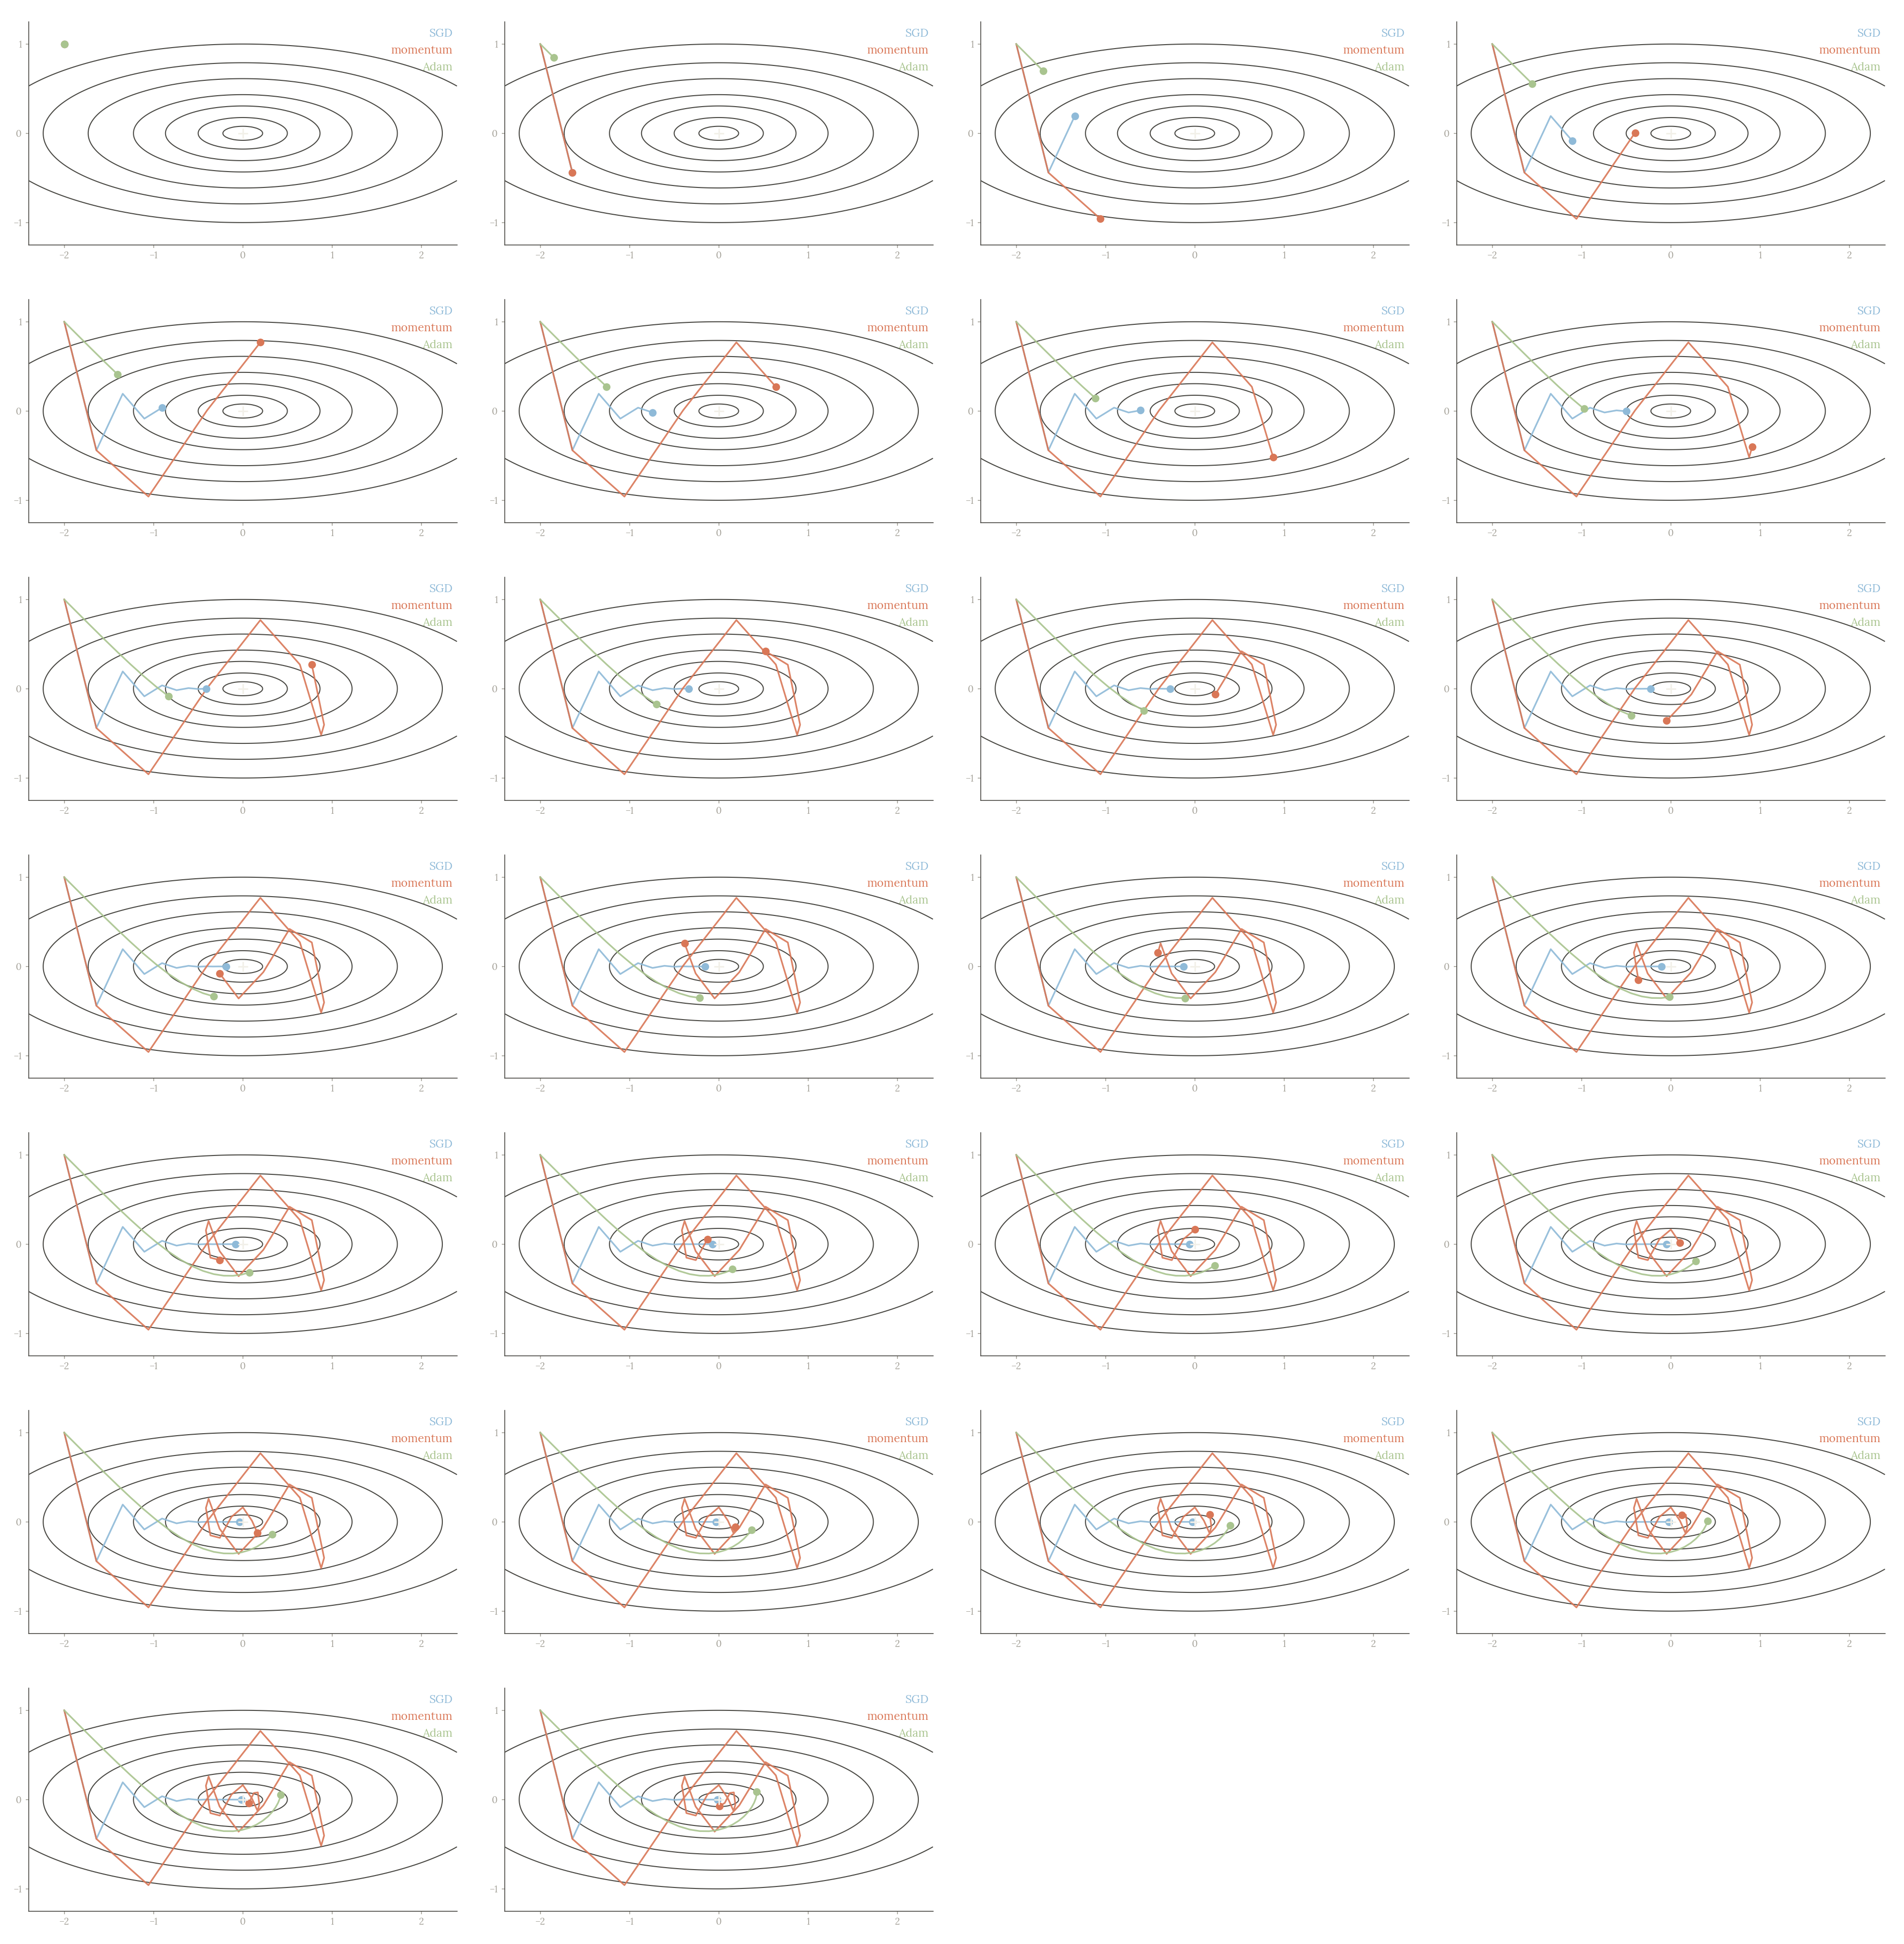
Hình chạy 25 bước trên từ điểm với . SGD nhân với mỗi bước, nên đổi dấu liên tục: đường đi zigzag nhưng co nhanh. Chiều được nhân mỗi bước nên tiến đều về đáy. Thêm momentum với cùng , quán tính tích lũy ở những bước đầu đưa đường đi vượt qua đáy rồi vòng lại: momentum bước dài hơn hẳn SGD, nên và phải chọn cùng nhau.
Hỏi nhanh
Gradient giữ nguyên bằng qua rất nhiều bước, , quy ước . Về sau, bước dài gấp khoảng bao nhiêu lần bước SGD ?
là tổng cấp số nhân , tiến tới . 1.9 lần chỉ là giá trị sau hai bước. 9 lần là quên số hạng của bước hiện tại. 0.9 lần là coi như hệ số làm bước ngắn lại. Đây là lý do momentum trong hình vượt qua đáy, dù dùng cùng với SGD.
Một số sách viết , tức trung bình có trọng số thay cho tổng. Ở quy ước này với và gradient luôn bằng 1, là rồi , nên bước đầu ngắn hơn hẳn. Khi gradient ổn định, hai quy ước chênh nhau đúng hệ số ở độ dài bước, nên learning rate chép từ tài liệu dùng quy ước này sang quy ước kia phải đổi thang. Mọi phép tính trong bài dùng quy ước đầu.
Nesterov là biến thể tính gradient sau khi đã nhích trước theo quán tính (nesterov=True trong PyTorch).
Adam điều chỉnh từng tọa độ
Adam giữ trung bình có trọng số của gradient, (giống momentum dạng có ), và của bình phương gradient, (ý tưởng của RMSprop):
Ở đây bình phương và chia là theo từng phần tử. Vì khởi tạo , các trung bình đầu bị kéo về 0; Adam sửa bằng và . Bước mới là
Với và gradient luôn bằng 1, còn : bước sửa lệch (bias correction) trả về đúng gradient.
Phép chia cho làm độ dài bước gần như không phụ thuộc thang gradient. Nếu một tọa độ luôn có gradient cố định thì , , và bước bằng , dù là 100 hay 0.01. Tọa độ có gradient lớn không còn bước quá dài, tọa độ có gradient nhỏ vẫn được đi bước đủ dài. Vì thang bước khác hẳn SGD, learning rate tốt của Adam (mặc định của PyTorch là ) không chép sang SGD được, và ngược lại. tránh chia cho 0 khi gần 0.
Adam không biết feature nào quan trọng; nó chỉ chỉnh thang bước theo lịch sử gradient của từng tọa độ. Thích nghi theo tọa độ cũng không bảo đảm validation tốt hơn: nhiều thực nghiệm đã công bố, nhất là ở phân loại ảnh, ghi nhận SGD momentum với lịch rate được dò kỹ đạt validation ngang hoặc tốt hơn Adam (Wilson và cộng sự, 2017). Vì vậy chọn optimizer vẫn là một thí nghiệm.
Hỏi nhanh
Chạy Adam rất nhiều bước với . Tọa độ A lúc nào cũng có gradient . Tọa độ B có gradient luân phiên . So độ dài bước của B với A thế nào?
Với A, và , nên bước bằng . Với B, ở mọi bước nên cũng bằng 1, nhưng chỉ dao động quanh , nên bước chỉ cỡ . Bước không bằng 0, vì trung bình có trọng số nghiêng về các gradient gần nhất. Tọa độ dao động bị hãm lại, còn tọa độ đi đều giữ được bước dài: đúng thứ mà một thung lũng hẹp cần.
Tính thử một bước rồi đối chiếu với PyTorch. Lấy , bắt đầu , gradient . SGD với cho . Adam bước đầu với có , sau bias correction ; bước có độ lớn gần 0.1 nên gần 2.1. Không phải Adam tính sai đạo hàm: như đã nói ở trên, bước đầu của Adam dài cỡ dù gradient là hay .
import numpy as np
import torch

torch.set_num_threads(1)
torch.manual_seed(23)
w = 2.
g = 2 * (w - 3)
m = .9 * 0 + .1 * g
v = .999 * 0 + .001 * g ** 2
m_hat = m / (1 - .9)
v_hat = v / (1 - .999)
w_adam = w - .1 * m_hat / (np.sqrt(v_hat) + 1e-8)
print('SGD:', round(w - .1 * g, 6))
print('Adam states:', round(m, 6), round(v, 6))
print('Adam:', round(w_adam, 6))

p = torch.nn.Parameter(torch.tensor(2., dtype=torch.float64))
adam = torch.optim.Adam([p], lr=.1)
adam.zero_grad(set_to_none=True)
((p - 3) ** 2).backward()
adam.step()
print('library match:', np.isclose(p.item(), w_adam))
SGD: 2.2
Adam states: -0.2 0.004
Adam: 2.1
library match: True
Đọc library match để đối chiếu bản một bước với PyTorch, dùng cùng epsilon và beta mặc định. Đối chiếu một bước không thay cho kiểm một loop dài, nhưng giúp phát hiện quên bias correction hoặc dùng gradient chưa bình phương.
Hỏi nhanh
Chạy tiếp ví dụ: sau bước đầu , gradient mới là . Với và , bằng bao nhiêu?
. Ở , hệ số sửa là , nên . Con số này nằm giữa hai gradient và , đúng như một trung bình phải thế. là chia cho của bước 1. là quên bước sửa độ lệch. là chỉ lấy gradient mới, bỏ mất ký ức.
So đường loss với ngân sách bằng nhau
Ta chạy ba optimizer từ cùng điểm khởi tạo, cùng 40 bước, trên hàm bậc hai ở đầu bài. Phép so này đo tiến trình tối ưu theo số bước; nó không đo thời gian chạy và không đo validation. Mỗi optimizer có thang learning rate riêng, nên mỗi cái dùng một rate hợp với nó thay vì ép chung một con số.
def run_optimizer(kind, lr, steps=40):
    p = torch.nn.Parameter(torch.tensor([-2., 1.]))
    if kind == 'momentum':
        optimizer = torch.optim.SGD([p], lr=lr, momentum=.8)
    elif kind == 'adam':
        optimizer = torch.optim.Adam([p], lr=lr)
    else:
        optimizer = torch.optim.SGD([p], lr=lr)
    start = (p[0] ** 2 + 8 * p[1] ** 2).item()
    for _ in range(steps):
        optimizer.zero_grad(set_to_none=True)
        loss = p[0] ** 2 + 8 * p[1] ** 2
        loss.backward()
        optimizer.step()
    end = (p[0] ** 2 + 8 * p[1] ** 2).item()
    return start, end

for kind, lr in [('sgd', .03), ('momentum', .03), ('adam', .15), ('sgd', .2)]:
    start, end = run_optimizer(kind, lr)
    print(kind, lr, f'{start:.4g}', f'{end:.4g}')
sgd 0.03 12 0.02833
momentum 0.03 12 0.0005109
adam 0.15 12 0.01883
sgd 0.2 12 1.981e+28
Dòng SGD rate 0.2 vượt ngưỡng đã tính: chiều bị nhân mỗi bước nên loss lên tới cỡ . Ba dòng còn lại đều hội tụ; ở bước 40 momentum thấp nhất, rồi đến Adam, rồi SGD. Thứ hạng ấy gắn với đúng ngân sách 40 bước. Cắt ở bước 30 thì sao?
for steps in (30, 40):
    _, sgd_end = run_optimizer('sgd', .03, steps)
    _, adam_end = run_optimizer('adam', .15, steps)
    print(steps, 'bước:', f'SGD {sgd_end:.3g}', f'Adam {adam_end:.3g}')
30 bước: SGD 0.0977 Adam 0.314
40 bước: SGD 0.0283 Adam 0.0188
Ở bước 30, SGD thấp hơn Adam hơn ba lần; mười bước sau thứ tự đảo lại. Hình cho thấy nguyên nhân: SGD với rate nhỏ đi xuống đều, còn Adam và momentum vừa xuống vừa dao động, nên thứ hạng tại một bước cụ thể phụ thuộc pha dao động lúc dừng.
Trong mạng thật, train loss giảm nhanh chỉ tiết kiệm thời gian tìm nghiệm; validation mới cho biết nghiệm ấy có tốt trên dữ liệu mới không.
Hỏi nhanh
Một đội có 2 giờ GPU và cần chọn giữa SGD momentum và AdamW cho bài thi. So thế nào thì kết luận mới dùng được?
Hai optimizer hợp với những thang learning rate khác nhau, nên một learning rate chung thường thiên vị một bên. Hãy dò trên thang log, như , , , rồi thu hẹp lại cho từng cái. Thứ hạng ở đoạn đầu có thể đảo ngược về sau, như SGD và Adam đổi chỗ giữa bước 30 và 40 ở trên; không optimizer nào “luôn nhanh hơn”. Và train loss không đo chất lượng trên dữ liệu mới: so cuối cùng vẫn phải trên validation.
AdamW và weight decay
L2 regularization (bài 2.2) thêm vào loss, tạo gradient phụ . Với SGD thường, bước đúng là co trọng số một hệ số rồi bước theo gradient dữ liệu. Phép co này gọi là weight decay; với SGD, L2 và weight decay trùng nhau.
Với Adam thì khác: đi vào , và bị chia cho như mọi gradient khác, nên phép co không còn là một hệ số chung cho mọi tham số. AdamW (Loshchilov và Hutter) tách hai phần: bước Adam chỉ dùng gradient dữ liệu, còn phép co áp thẳng lên trọng số. Trong PyTorch, torch.optim.Adam(..., weight_decay=λ) vẫn làm theo kiểu L2; muốn kiểu tách phải dùng AdamW.
Để thấy riêng phần co, dùng AdamW vừa khởi tạo với các moment bằng 0 và cho gradient dữ liệu bằng 0. Nếu optimizer đã có lịch sử, moment cũ vẫn có thể tạo bước cập nhật dù gradient hiện tại bằng 0. Lưu ý grad=None có thể khiến optimizer bỏ qua tham số; ta đặt gradient tensor toàn 0 để kiểm decay:
q = torch.nn.Parameter(torch.tensor([2.]))
adamw = torch.optim.AdamW([q], lr=.1, weight_decay=.2)
q.grad = torch.zeros_like(q)
adamw.step()
print('after decay:', round(q.item(), 4))
after decay: 1.96
, khớp output. Với SGD, weight_decay cộng vào gradient: , gradient 0.5, , cho . Decay quá lớn ép model underfit, nên cũng được chọn bằng validation. Mô hình lớn thường tách nhóm tham số để bias và tham số của các lớp normalization không bị decay.
Hỏi nhanh
Thay AdamW trong đoạn code trên bằng torch.optim.Adam(..., weight_decay=.2), giữ nguyên mọi thứ khác: , learning rate 0.1, gradient bằng tensor 0, optimizer vừa tạo. Sau một bước, bằng bao nhiêu?
Adam kiểu L2 coi là gradient. Bước đầu của Adam dài cỡ , bất kể gradient lớn hay nhỏ, nên . 1.96 là kết quả của AdamW, hoặc của SGD với cùng mức decay. 2.0 là nghĩ rằng gradient bằng 0 thì không có gì thay đổi. 1.6 là nhân với , quên mất .
Scheduler thay learning rate theo thời gian
Đầu quá trình, bước lớn giúp tiến nhanh; về sau, bước nhỏ giúp đi sâu vào đáy thay vì dao động quanh nó. Với SGD minibatch còn một lý do nữa: ngay cả khi tham số đã ở đúng nghiệm, gradient của từng minibatch vẫn khác 0, nên bước cố định tiếp tục đẩy tham số đi lệch; chỉ khi giảm thì vùng dao động mới thu nhỏ.
StepLR nhân rate với gamma sau mỗi step_size lần gọi. Cosine giảm trơn từ về trong bước:
nên ở giữa lịch, , rate đúng bằng trung bình hai đầu. Các lịch khác:
- Warmup làm ngược lại ở đầu train: tăng tuyến tính từ gần 0 lên rate mục tiêu trong một số bước, rồi mới giảm. Với Adam, ở những bước đầu mới tổng hợp từ vài gradient nên chưa phản ánh thang thật, trong khi bước Adam dài cỡ ở mọi tọa độ cùng lúc. Mô hình lớn khởi tạo ngẫu nhiên như Transformer dễ nổ loss nếu nhận loạt bước dài như vậy ngay từ đầu.
- OneCycle gộp hai pha trong một chu kỳ: tăng lên đỉnh rồi giảm sâu.
- ReduceLROnPlateau nhận một metric và chỉ giảm rate khi metric ngừng cải thiện. Với
patience=2, metric không cải thiện quá hai lần gọi liên tiếp thì rate bị nhân vớifactor.
Mọi lịch chỉ điều chỉnh độ dài bước; chúng không sửa gradient sai hoặc dữ liệu rò rỉ.
r = torch.nn.Parameter(torch.tensor(2.))
sgd = torch.optim.SGD([r], lr=.1)
scheduler = torch.optim.lr_scheduler.StepLR(sgd, step_size=3, gamma=.5)
rates = []
for epoch in range(9):
    rates.append(sgd.param_groups[0]['lr'])
    sgd.zero_grad(set_to_none=True)
    ((r - 3) ** 2).backward()
    sgd.step()
    scheduler.step()
print([round(value, 4) for value in rates])
[0.1, 0.1, 0.1, 0.05, 0.05, 0.05, 0.025, 0.025, 0.025]
Rate được đọc trước khi cập nhật; scheduler.step() chạy sau optimizer.step(), một lần mỗi epoch. Ví dụ rate 0.1 với StepLR(step_size=10, gamma=0.1) gọi mỗi epoch: epoch 0–9 dùng 0.1, epoch 10–19 dùng 0.01.
Lịch theo step đếm số batch, lịch theo epoch đếm số epoch. Đổi batch size mà giữ nguyên lịch theo step thì số batch mỗi epoch đổi, nên rate giảm ở một thời điểm khác tính theo lượng dữ liệu đã học. Ngược lại, OneCycle tạo với total_steps=len(loader) * 10 mà chỉ gọi step() mỗi epoch thì sau 10 epoch lịch mới đi 10 bước, rate còn chưa lên tới đỉnh.
Hỏi nhanh
StepLR được thiết kế để giảm learning rate sau mỗi 3 epoch, và mỗi epoch có nhiều batch. Gọi scheduler.step() ở đâu thì lịch chạy đúng thiết kế?
StepLR chỉ đếm số lần được gọi, không tự biết đâu là một epoch. Gọi sau mỗi batch thì learning rate giảm sau 3 batch thay vì 3 epoch. Gọi trước bước đầu tiên thì mất learning rate ban đầu. Truyền metric vào là cách dùng của ReduceLROnPlateau, không phải của StepLR.
Khi đi thi
- Bắt đầu từ AdamW với learning rate ; dò thêm trên thang log bằng vài trăm bước.
- Loss tăng vọt hay thành
nanở những bước đầu thì giảm learning rate hoặc thêm warmup. - Cosine và OneCycle cần biết trước tổng số bước:
epochs * len(train_loader).
Tóm tắt
- SGD đi ngược gradient; chiều cong nhất đặt ngưỡng learning rate, chiều thoải nhất quyết định tốc độ.
- Momentum cộng dồn hướng; Adam chia bước cho độ lớn gradient của từng tọa độ, nên bước gần như không phụ thuộc thang gradient.
- AdamW tách phép co trọng số khỏi bước của Adam.
- Scheduler (step, cosine, warmup) đổi rate theo bước hoặc epoch.
- Optimizer và rate được chọn bằng thử nghiệm, so trên validation với cùng ngân sách.
Kiểm tra cuối bài
Câu 1
Một bạn cài phương pháp Newton cho một mạng nhỏ 3 lớp có khoảng 10 nghìn tham số. Mô hình hội tụ tốt hơn, nhưng tổng thời gian chậm hơn Adam 100 lần, và profiler cho thấy 95% thời gian nằm ở một phép toán. Nhiều khả năng đó là phép nào?
Ma trận Hessian có phần tử, và nghịch đảo nó tốn cỡ phép tính mỗi bước. Trong khi đó, forward và backward của mạng tham số chỉ tốn cỡ vài lần phép tính mỗi mẫu. Adam cũng phải forward, backward và đọc dữ liệu, nên ba phần ấy không giải thích được khoảng chênh 100 lần.
Câu 2
Dùng gradient descent tìm cực tiểu của , xuất phát từ , với learning rate cố định . Trong các giá trị , những giá trị nào đưa về nghiệm 0?
Mỗi bước . cho hệ số 0, tới đáy chỉ sau một bước. cho hệ số : nhảy mãi, loss không giảm. cho hệ số nên nổ tung. đứng yên ở . Đây đúng là ngưỡng của bài, và dấu bằng thì chưa đủ.
Phỏng theoCMU 10-601 · Exam 2 Practice · Q1.1(b)
Câu 3
Linear regression với squared loss, dữ liệu có nhiễu nên không điểm nào được khớp hoàn toàn. Khởi tạo trọng số đúng bằng nghiệm OLS , rồi chạy với learning rate nhỏ cố định. Batch GD, dùng gradient trên toàn bộ dữ liệu, và SGD, dùng một điểm mỗi bước, lần lượt làm gì với trọng số?
Tại , tổng gradient trên mọi điểm bằng 0, nên batch GD không di chuyển. Gradient của từng điểm riêng lẻ thì khác 0, vì phần dư khác 0. Vì vậy mỗi bước SGD đẩy trọng số lệch đi một chút. Trung bình các cú đẩy bằng 0, nên trọng số chỉ lắc quanh . Muốn SGD dừng sát nghiệm thì phải giảm dần learning rate, và đó là một lý do cần đến scheduler.
Câu 4
Momentum theo quy ước , . Với cũ bằng , , , , , giá trị mới bằng bao nhiêu?
mới bằng , nên . Tham số vẫn đi theo hướng cũ, dù gradient hiện tại dương. 0.80 là bước SGD thuần, bỏ qua cũ. 0.96 là sai dấu ở bước cập nhật . 1.10 là quên nhân , lấy .
Câu 5
Train bằng Adam kiểu L2, tức cộng vào gradient trước khi tính , . Tham số A có lịch sử gradient dữ liệu rất lớn, tham số B có gradient dữ liệu rất nhỏ, và hai tham số đang cùng giá trị. So với AdamW có cùng , lực kéo về 0 tác động lên A và B thế nào?
Với Adam kiểu L2, đi qua phép chia cho . A có lớn, nên phần decay của nó bị chia nhỏ. B có nhỏ, nên bị kéo mạnh. AdamW co mọi tham số cùng một hệ số , không đi qua . Đây chính là lý do Loshchilov và Hutter tách weight decay ra khỏi gradient.
Câu 6
Train từ đầu một mô hình ngôn ngữ lớn (BERT-base) bằng AdamW, với ba cách đặt learning rate. Cách A: cố định , loss giảm đều tới 2.3 ở bước 10K. Cách B: ngay từ bước 0, loss lên 12.7 ở bước 100, tệ hơn cả mức 9.5 lúc khởi tạo, rồi thành NaN ở bước 300. Cách C: tăng tuyến tính từ 0 lên trong 5K bước đầu (warmup) rồi giữ nguyên, loss xuống 1.8 ở bước 10K. Vì sao B nổ còn C thì thành công, dù cùng mức đỉnh?
Ở những bước đầu, trọng số ngẫu nhiên cho gradient lớn và đổi nhanh, còn mới tổng hợp từ vài gradient nên chưa phản ánh đúng thang đo. Lúc ấy, bước của Adam dài cỡ ở mọi tọa độ. Đặt ngay từ đầu thì một loạt bước dài đồng loạt đẩy mô hình ra khỏi vùng ổn định. Warmup giữ nhỏ đúng ở giai đoạn ấy. Warmup không đổi batch size. Clipping giới hạn độ lớn gradient chứ không gây nổ. “Học thuộc trước” không giải thích được chuyện ra NaN.
Câu 7
Lịch learning rate gồm warmup rồi cosine:
def get_lr(step, total_steps, warmup_steps, base_lr, min_lr=1e-6):
    if step < warmup_steps:
        return base_lr * step / warmup_steps
    progress = (step - warmup_steps) / (total_steps - warmup_steps)
    return min_lr + 0.5 * (base_lr - min_lr) * (1 + math.cos(math.pi * progress))
Với base_lr=1e-3, warmup_steps=1000, total_steps=100000, learning rate ở bước 50000 xấp xỉ bao nhiêu?
progress bằng , và . Vậy learning rate xấp xỉ , gần trung bình của đỉnh và đáy. Warmup làm điểm giữa của cosine lùi về bước 50500, nên ở bước 50000, learning rate cao hơn trung bình một chút. và là tưởng rằng ở giữa lịch cosine mới giảm 25%, hoặc đã giảm 75%. là quên rằng warmup chỉ kéo dài 1000 bước.
Câu 8
Train một mạng sâu phân loại ảnh (ResNet-34 trên CIFAR-10) bằng SGD, learning rate cố định 0.1 trong 200 epoch. Loss giảm nhanh trong 50 epoch đầu rồi đi ngang, dao động quanh 0.45, với train 88% và validation 85%. Đổi lịch learning rate thế nào thì nhiều khả năng cải thiện kết quả cuối nhất?
Loss dao động quanh một mức là dấu hiệu bước quá dài để đi sâu thêm vào đáy, giống SGD với bước cố định ở Câu 3. Giảm learning rate sau khi đã tiến nhanh giữ được giai đoạn đầu và cho phép tinh chỉnh. Bài báo ResNet gốc dùng đúng kiểu lịch này trên CIFAR-10. Dùng 0.01 từ đầu là bỏ mất giai đoạn tiến nhanh. Warmup chữa sự bất ổn ở đầu quá trình train, còn vấn đề ở đây xuất hiện sau epoch 50. Tăng batch size 4 lần làm nhiễu gradient nhỏ đi, tác dụng gần giống giảm learning rate khoảng 4 lần, nhưng chỉ một lần, trong khi giảm theo bậc thang giảm tổng cộng 100 lần qua hai mốc. Với 200 epoch cố định, batch lớn hơn còn làm số bước cập nhật giảm đi 4 lần.
Câu 9
Train một mô hình ngôn ngữ 100K bước bằng AdamW, với ba lịch learning rate. Điểm đánh giá là perplexity trên validation, càng thấp càng tốt. Lịch A giữ : train loss 2.1, perplexity 22.3. Lịch B dùng cosine từ về : train loss 1.8, perplexity 19.1. Lịch C giảm bậc thang xuống ở bước 60K và ở bước 80K: train loss 1.7, perplexity 19.8. Nên chọn lịch nào cho mô hình nộp?
Mô hình được chọn theo dữ liệu chưa dùng để huấn luyện, và B có perplexity validation thấp nhất: 19.1, so với 19.8 và 22.3. Train loss thấp hơn của C không bảo đảm tổng quát tốt hơn. Ngân sách 100K bước đã cố định, và A kém xa. Lấy trung bình hai lịch là một thí nghiệm mới, chưa có số để mà chọn.
Câu 10
Một lượt train bằng Adam có scheduler bị ngắt giữa chừng, và cần chạy tiếp với đúng quy trình cập nhật như trước. Ngoài trọng số model, ta cần khôi phục những gì?
, và bộ đếm quyết định bước tiếp theo, kể cả bước sửa độ lệch. Trọng số không chứa lịch sử gradient. Scheduler cũng có bộ đếm riêng, thiếu nó thì warmup hay cosine sẽ chạy lại từ đầu. Adam mới đúng là sẽ tích lũy lại thống kê, nhưng những bước đầu là bước của một lần chạy mới. Trong PyTorch, hãy lưu optimizer.state_dict() và scheduler.state_dict() cùng với model.state_dict().
Đọc thêm
- D2L — Momentum và Adam: đọc phép tích lũy gradient và hiệu chỉnh khởi tạo.
- Kingma, Ba — Adam: bài gốc để đối chiếu thuật toán và các trạng thái , .
- Wilson và cộng sự — The Marginal Value of Adaptive Gradient Methods in Machine Learning: so optimizer thích nghi với SGD momentum khi dò rate cho từng cái, đọc kết quả validation.
- Loshchilov, Hutter — Decoupled Weight Decay Regularization: nguồn gốc phân biệt AdamW với L2 ghép gradient.
- Loshchilov, Hutter — SGDR: lịch cosine và khởi động lại rate.
- Liu và cộng sự — On the Variance of the Adaptive Learning Rate and Beyond: phân tích vì sao Adam cần warmup ở những bước đầu.
- PyTorch 2.9 — optim: tra optimizer và lịch learning rate, đọc rõ thời điểm scheduler.step.