Khi hai lớp dữ liệu tách được bằng một đường thẳng, thường có nhiều đường thẳng làm được việc đó. SVM (Support Vector Machine) chọn đường nằm xa các điểm gần nhất của cả hai lớp nhất, để một điểm mới lệch một chút vẫn được xếp đúng. Khoảng cách đó gọi là lề (margin). Bài này tính lề bằng tay trên ví dụ nhỏ, rồi dùng kernel để SVM tách được dữ liệu cần đường cong.
Lề lớn nhất
Gán nhãn . Một siêu phẳng phân loại đúng mọi điểm khi . Khoảng cách từ đến siêu phẳng là
Vì nhân và với cùng một số dương không đổi siêu phẳng, ta chuẩn hóa sao cho các điểm gần nhất thỏa . Khi đó độ rộng lề (margin) giữa hai phía là ; chẳng hạn có , nên lề rộng . Cực đại lề tương đương
Đây là bài toán tối ưu lồi bậc hai: khi dữ liệu tách được thì có nghiệm, và không có cực tiểu địa phương nào để mắc kẹt. Các điểm nằm đúng trên biên lề là vector hỗ trợ (support vectors): chỉ chúng quyết định vị trí vạch, bỏ các điểm khác đi thì vạch không đổi. (Với lề mềm ở mục sau, vector hỗ trợ còn gồm cả các điểm nằm trong lề hoặc bị phân loại sai.)
Hỏi nhanh
Sau khi chuẩn hóa, hai biên lề cách nhau đúng 1 đơn vị. bằng bao nhiêu?
Độ rộng lề là , nên . Lề rộng thì nhỏ, và đó là lý do bài toán đi tìm cực tiểu của .
Lề mềm và hinge loss
Dữ liệu thật hiếm khi tách được hoàn toàn. Lề mềm (soft margin) cho phép vi phạm, có trả giá:
Số hạng thứ hai là hinge loss: bằng 0 nếu điểm nằm đúng phía và ngoài lề, tăng tuyến tính nếu lấn vào lề hoặc sang phía sai. Lại là “phạt + lỗi”, chỉ khác là hệ số đặt ở phía lỗi: lớn thì ít chịu vi phạm, lề hẹp, dễ overfit; nhỏ thì lề rộng, mô hình đơn giản hơn.
Lấy siêu phẳng , và ba điểm:
- Điểm : , nằm đúng trên siêu phẳng.
- Điểm nhãn : , khoảng cách , , hinge loss bằng 0.
- Điểm nhãn : , nằm đúng phía nhưng trong lề, hinge loss .
So với logistic regression ở bài 2.3, hai mô hình chỉ khác hàm mất mát. Log loss không bao giờ bằng 0, nên mọi điểm đều góp tiếng nói. Hinge loss bằng 0 với điểm “an toàn”, nên chỉ các điểm gần ranh giới mới quan trọng.
Hỏi nhanh
Cho tiến dần về 0 trong bài toán lề mềm. Nghiệm có xu hướng thế nào?
Khi , vi phạm gần như không bị tính phí, nên mục tiêu chỉ còn là làm nhỏ. Lề rất rộng và gần như bỏ mặc dữ liệu, tức là underfit. Ngược lại, mới tiến tới lề cứng.
Mẹo kernel
Muốn ranh giới cong, cách thô là ánh xạ sang không gian đặc trưng lớn hơn rồi chạy SVM tuyến tính ở đó. Điều đặc biệt là dạng đối ngẫu (dual) của bài toán SVM chỉ dùng dữ liệu qua tích vô hướng . Nếu có hàm tính thẳng tích đó, gọi là kernel, thì không bao giờ phải tạo :
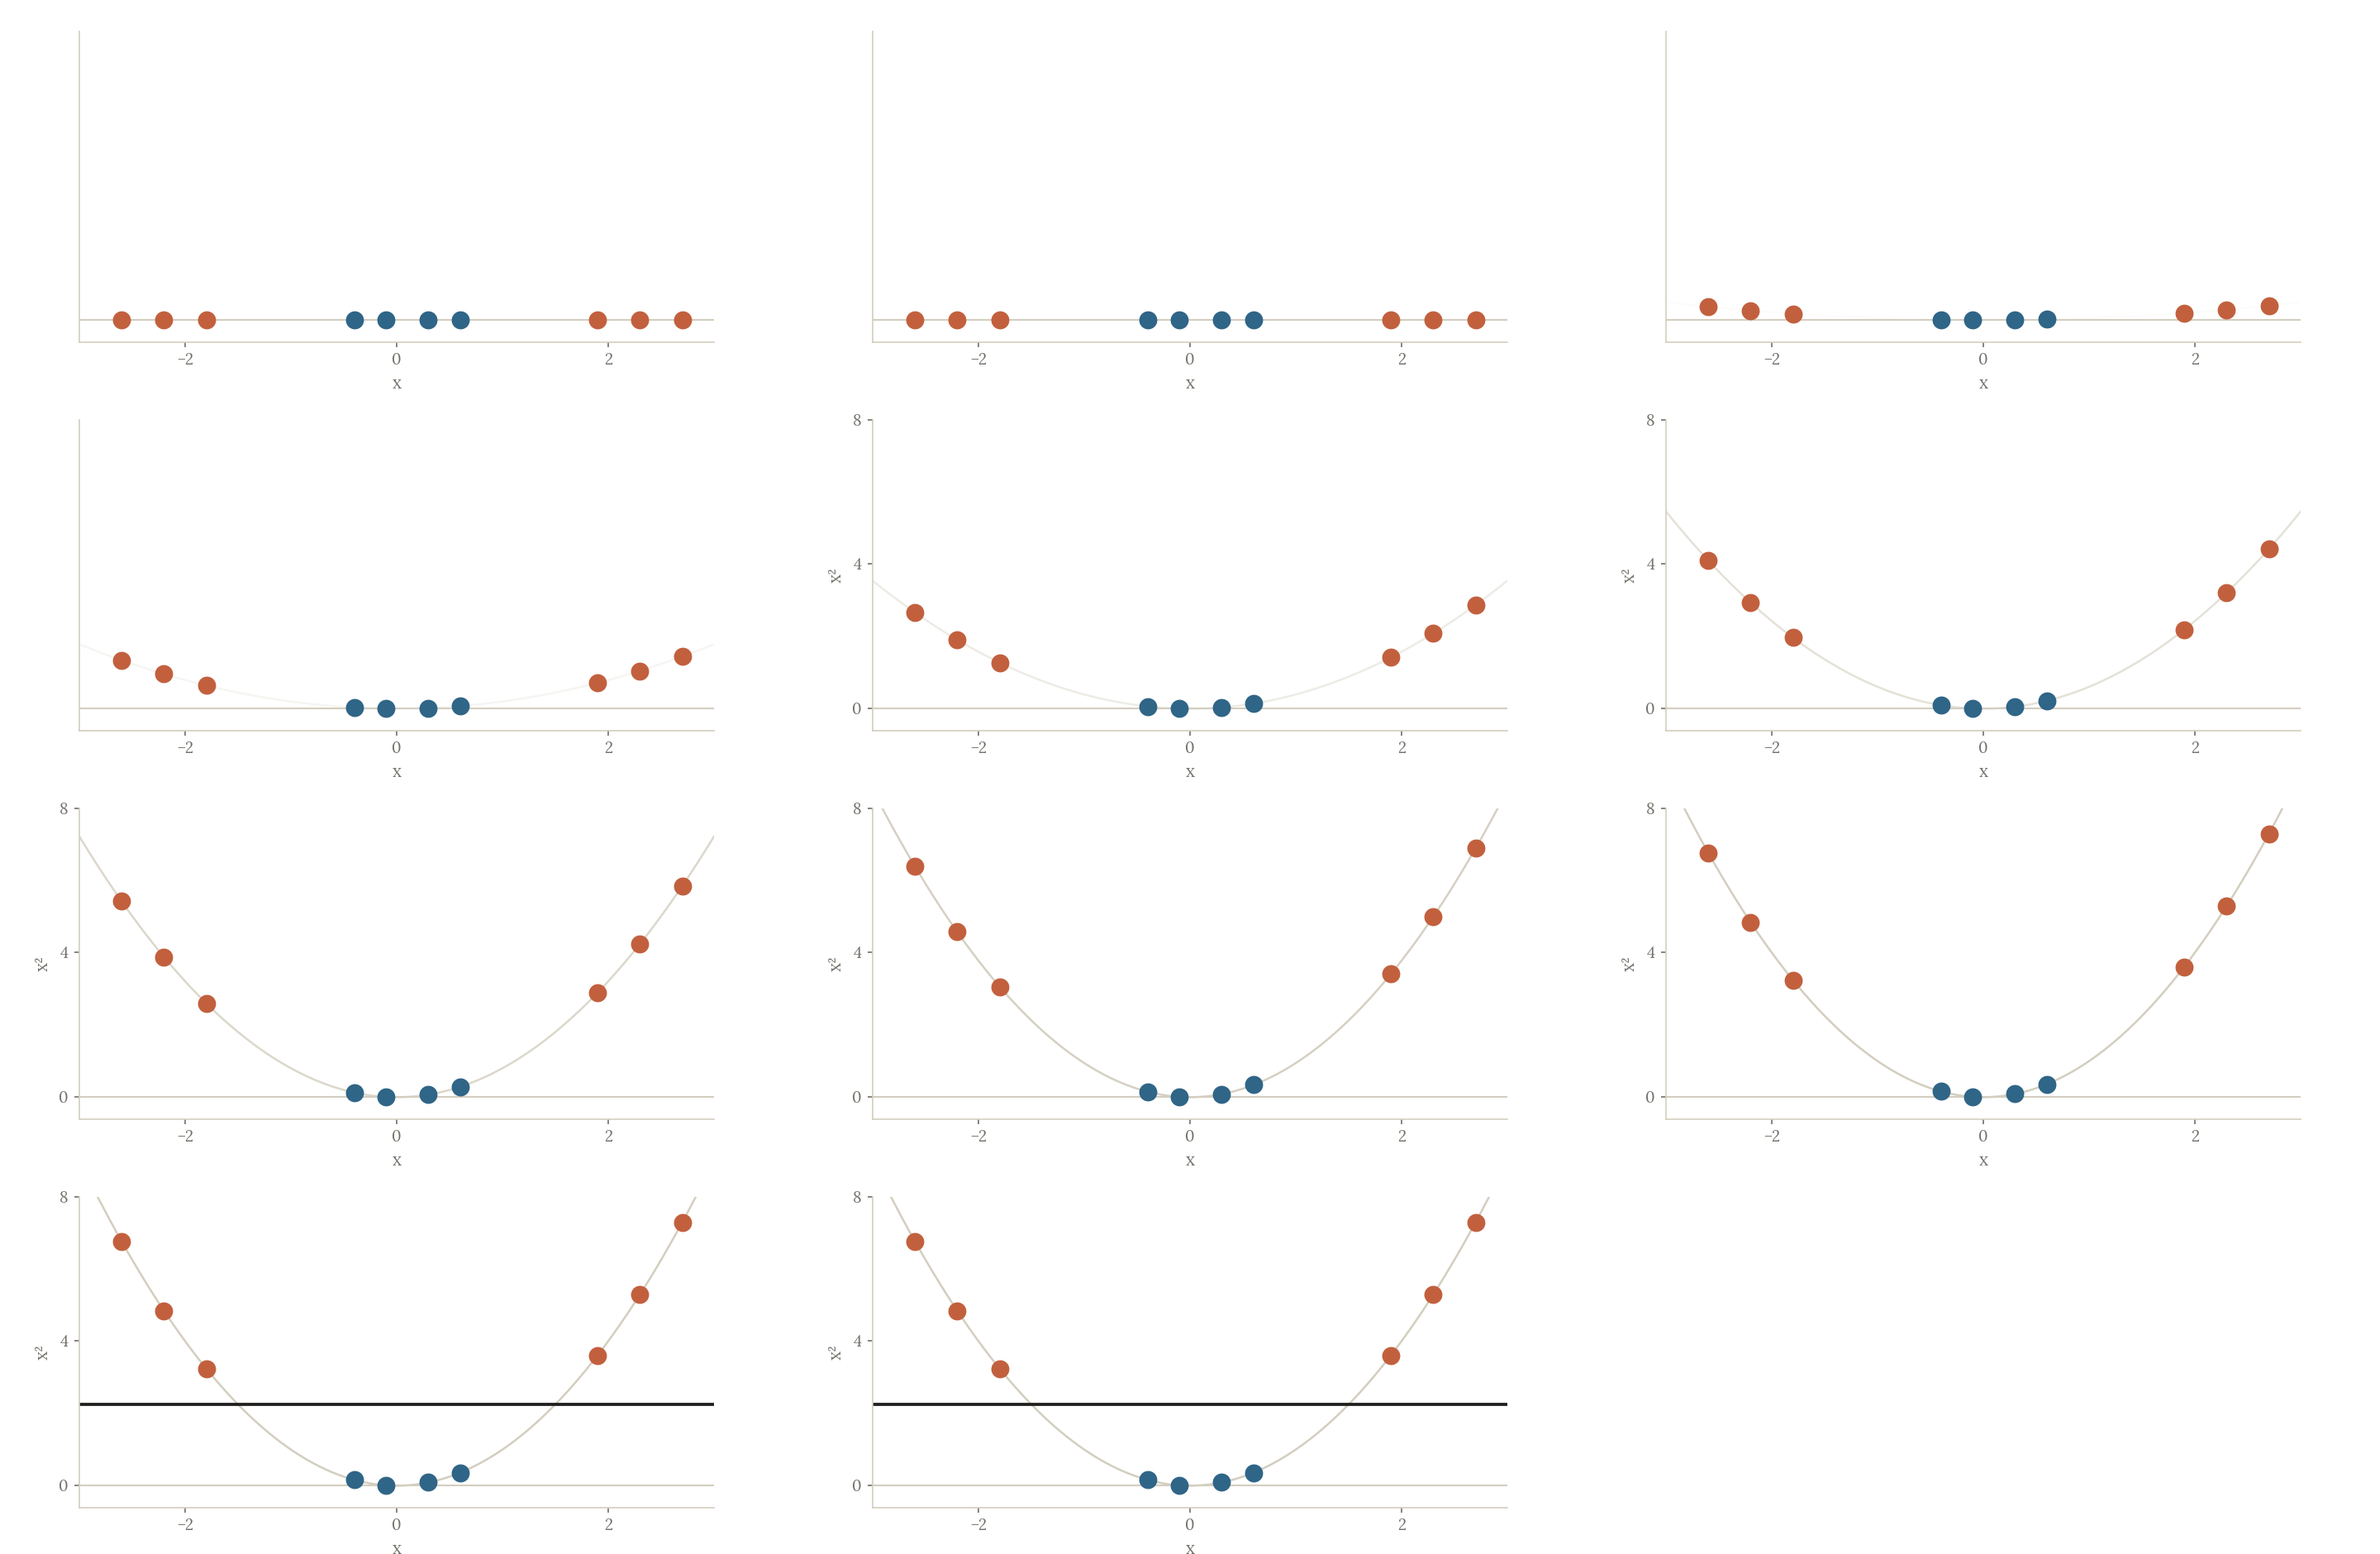
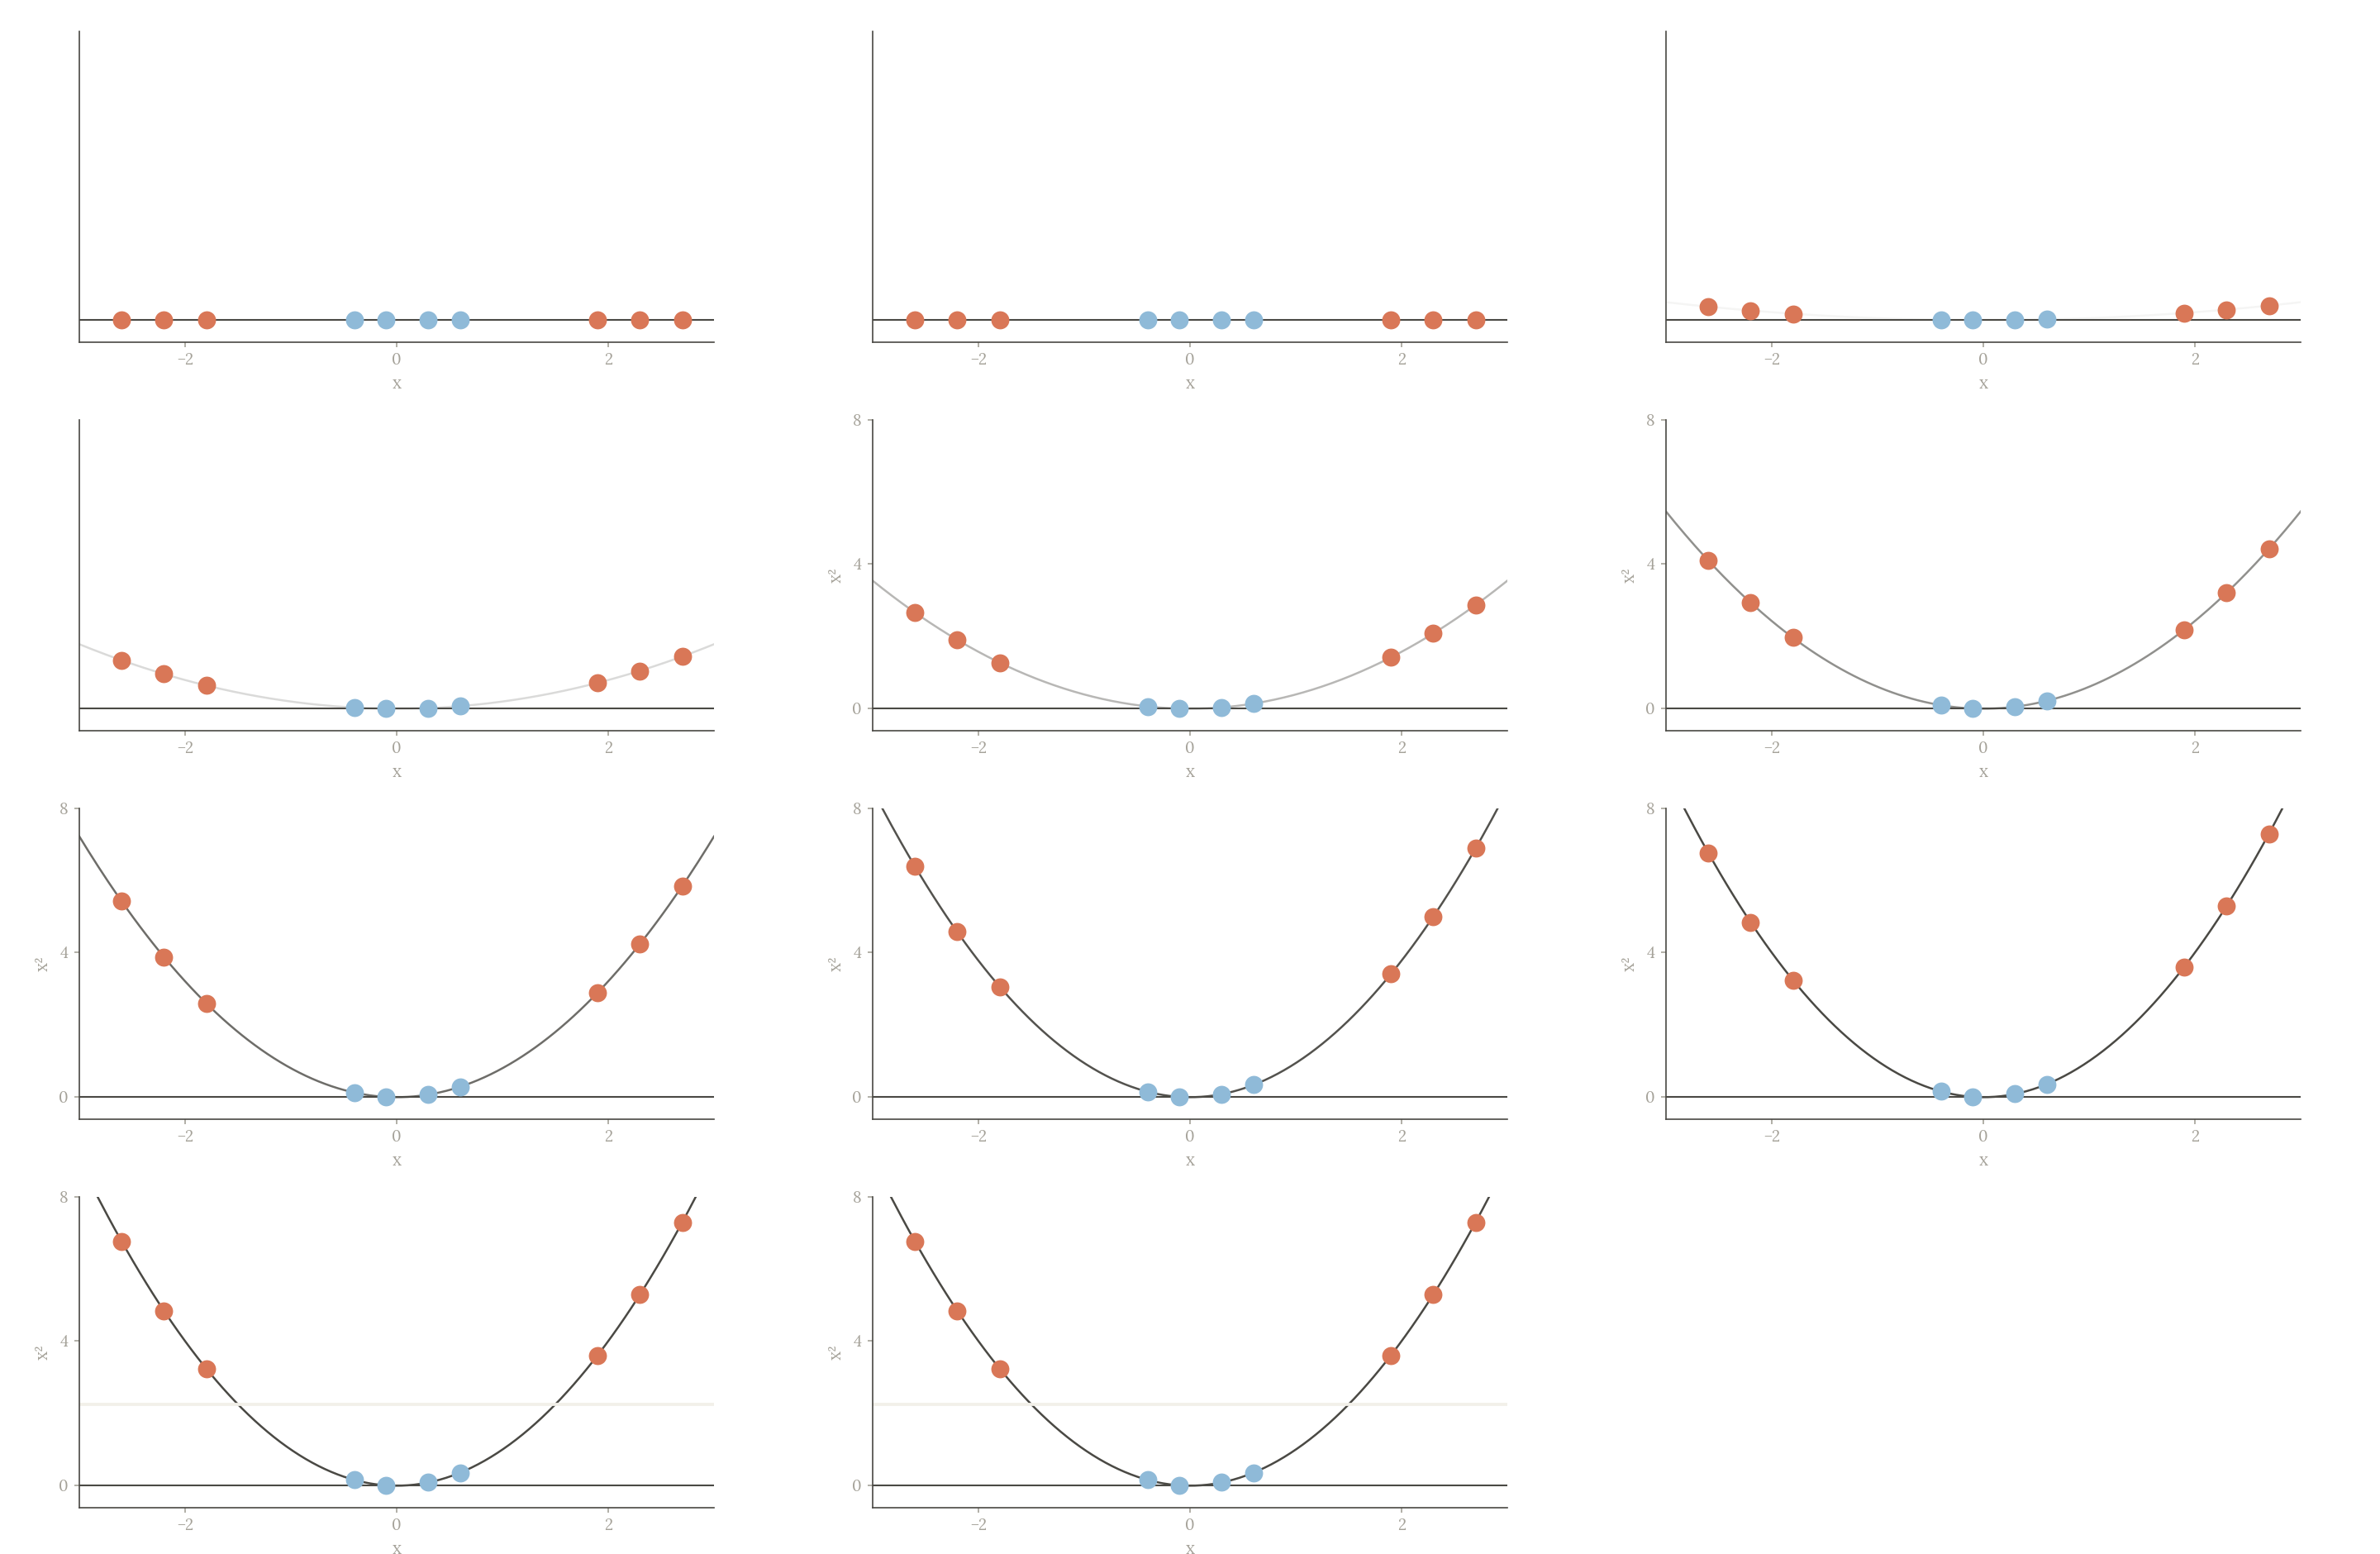
Ví dụ với và :
Một phép nhân vô hướng rồi bình phương thay cho việc lập và nhân hai vector ba chiều. Với kernel RBF (Gaussian)
không gian đặc trưng tương ứng có vô hạn chiều, vậy mà tính kernel chỉ tốn .
Hỏi nhanh
Với , kernel ứng với một có khoảng bao nhiêu chiều? Tính thẳng kernel thì tốn khoảng bao nhiêu phép nhân?
gồm mọi tích với , tức chiều. Còn kernel chỉ cần một tích vô hướng 1000 chiều rồi bình phương. Toàn bộ “mẹo kernel” nằm ở đây: làm việc trong một không gian khổng lồ mà không phải bước vào đó.
Hàm dự đoán khi đó có dạng : một tổng có trọng số theo độ giống giữa điểm mới và các vector hỗ trợ. Nhìn kỹ thì giống kNN có trọng số, nhưng trọng số được học bằng tối ưu. Với RBF và , hai điểm và có nên . Một điểm test ở rất xa mọi vector hỗ trợ có mọi gần 0, nên gần bằng và dấu của quyết định nhãn.
Hai tham số C và γ
Với kernel RBF, quy định “tầm ảnh hưởng” của mỗi vector hỗ trợ. lớn thì mỗi điểm chỉ ảnh hưởng vùng rất nhỏ quanh nó, ranh giới uốn lượn theo từng điểm. nhỏ thì ranh giới mượt gần như tuyến tính. Cùng với , đây là hai núm cần dò, luôn trên lưới logarit, ví dụ và .
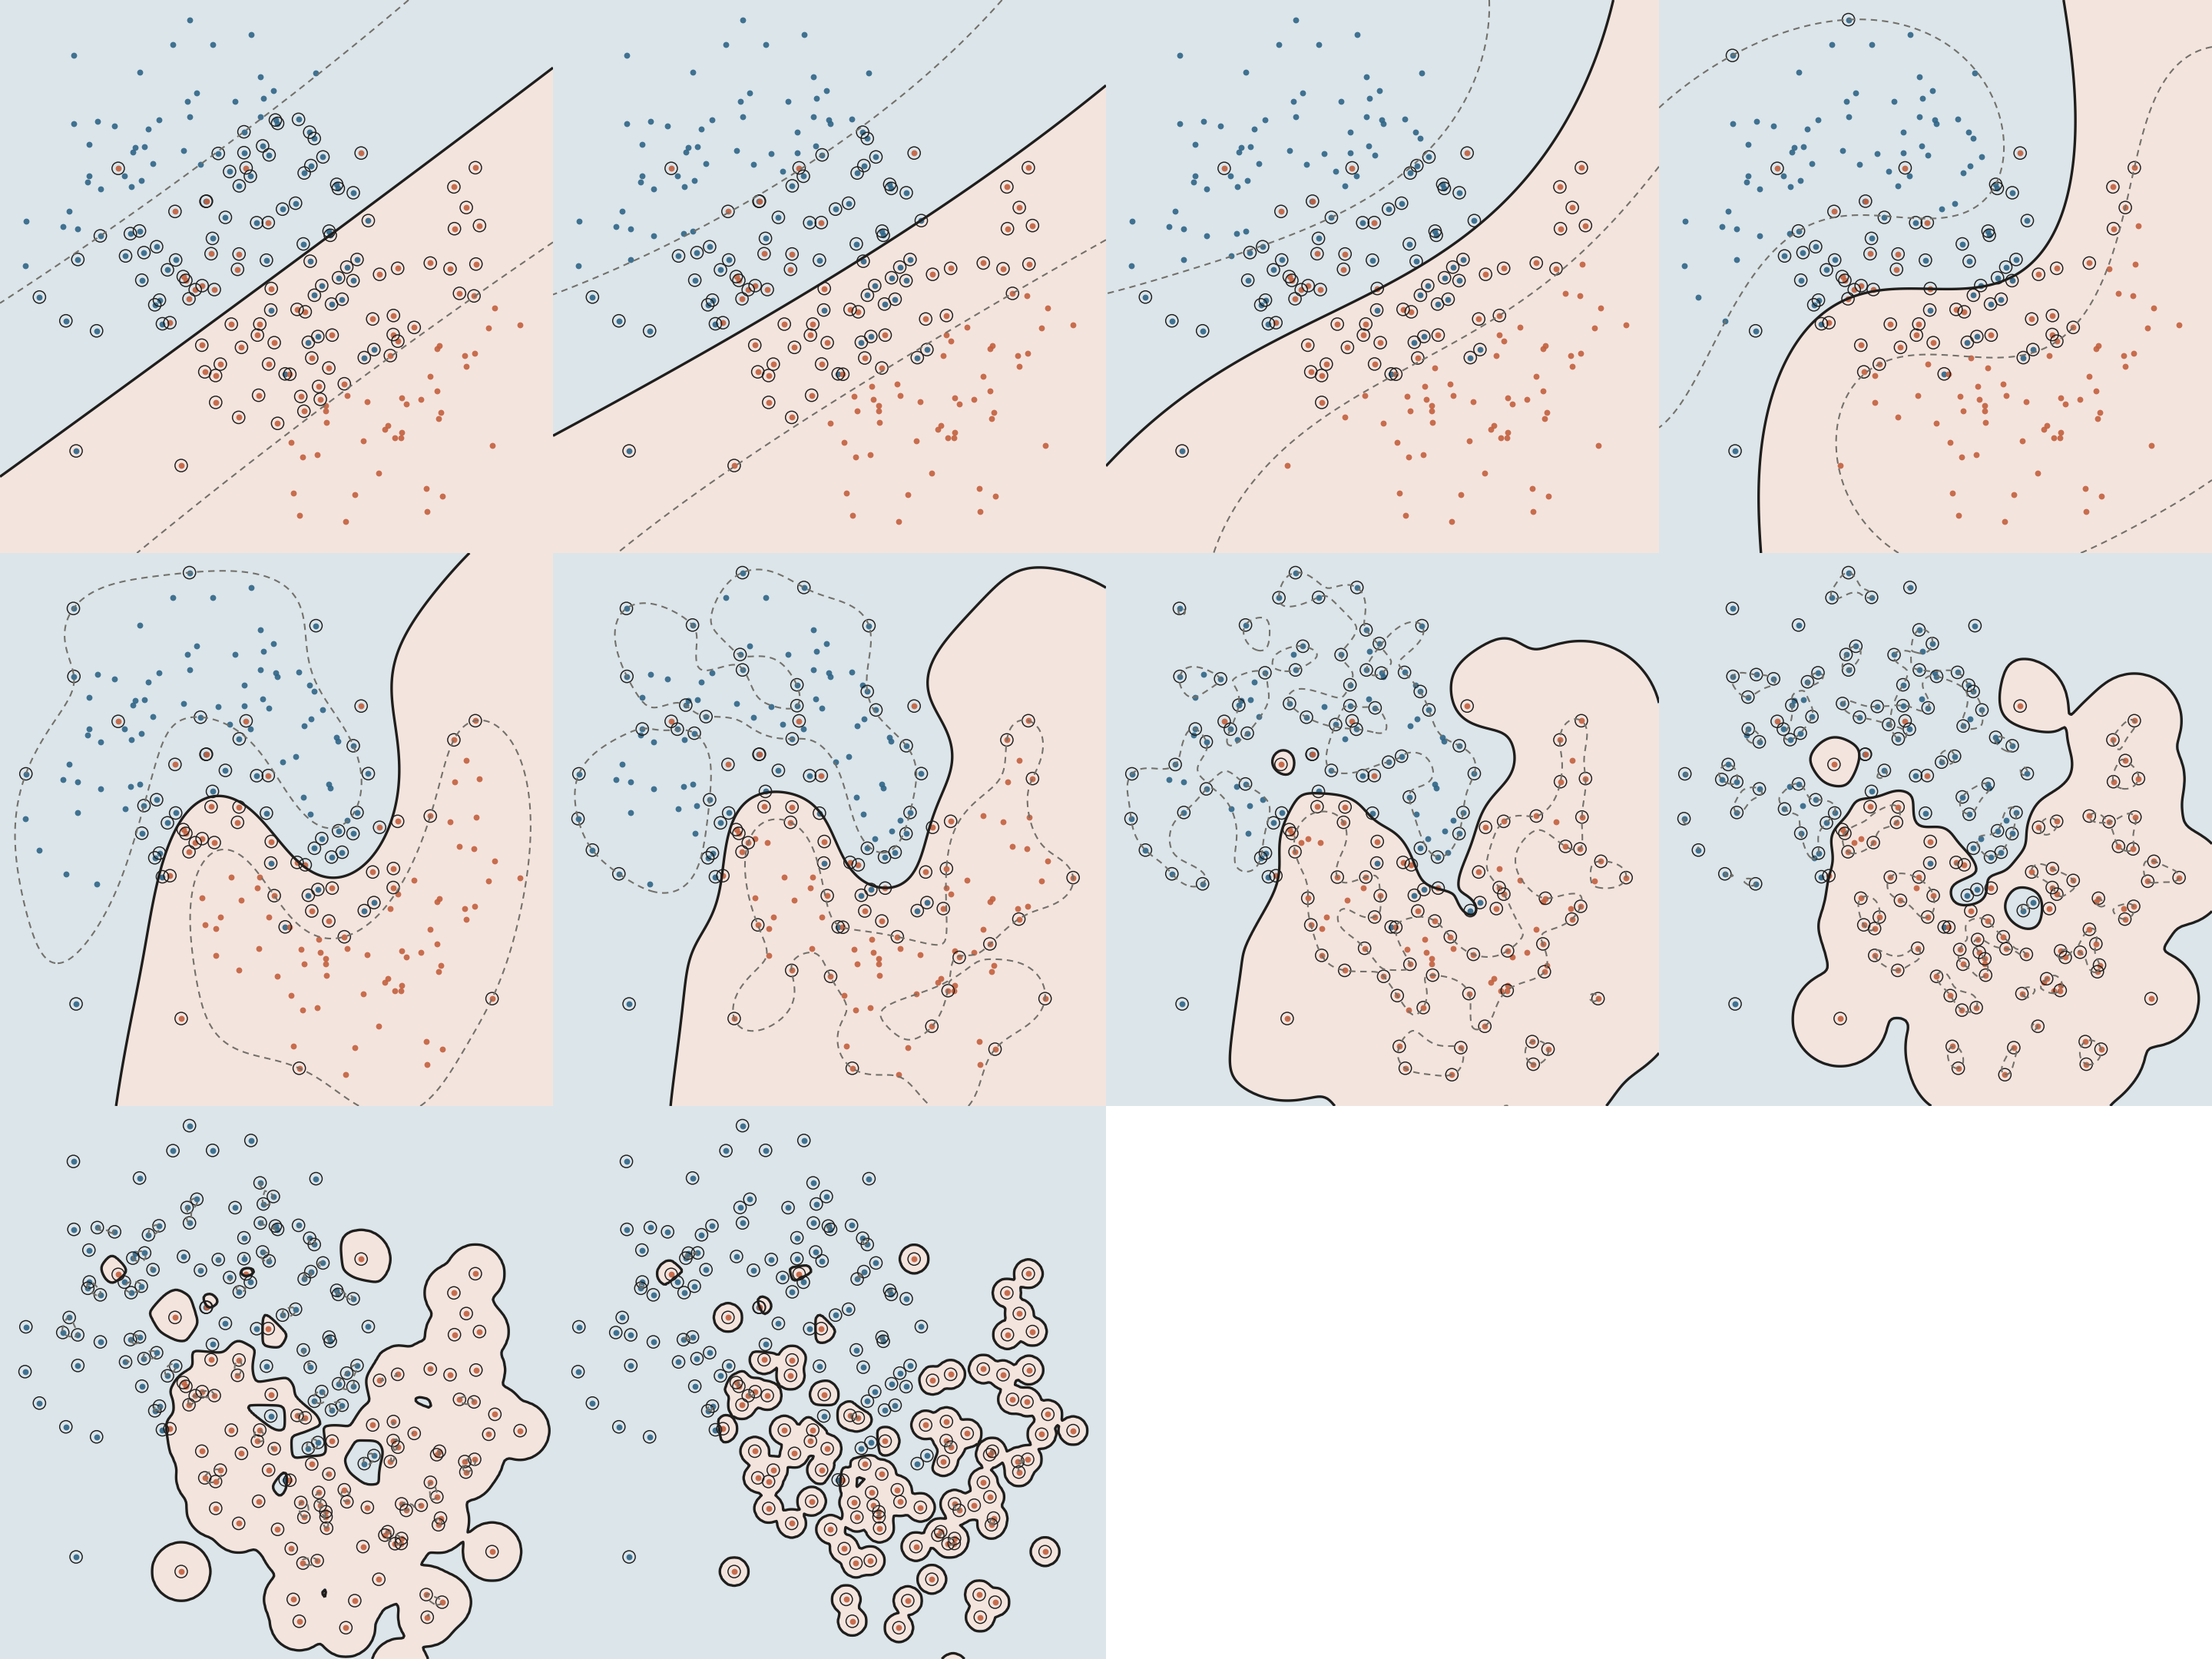
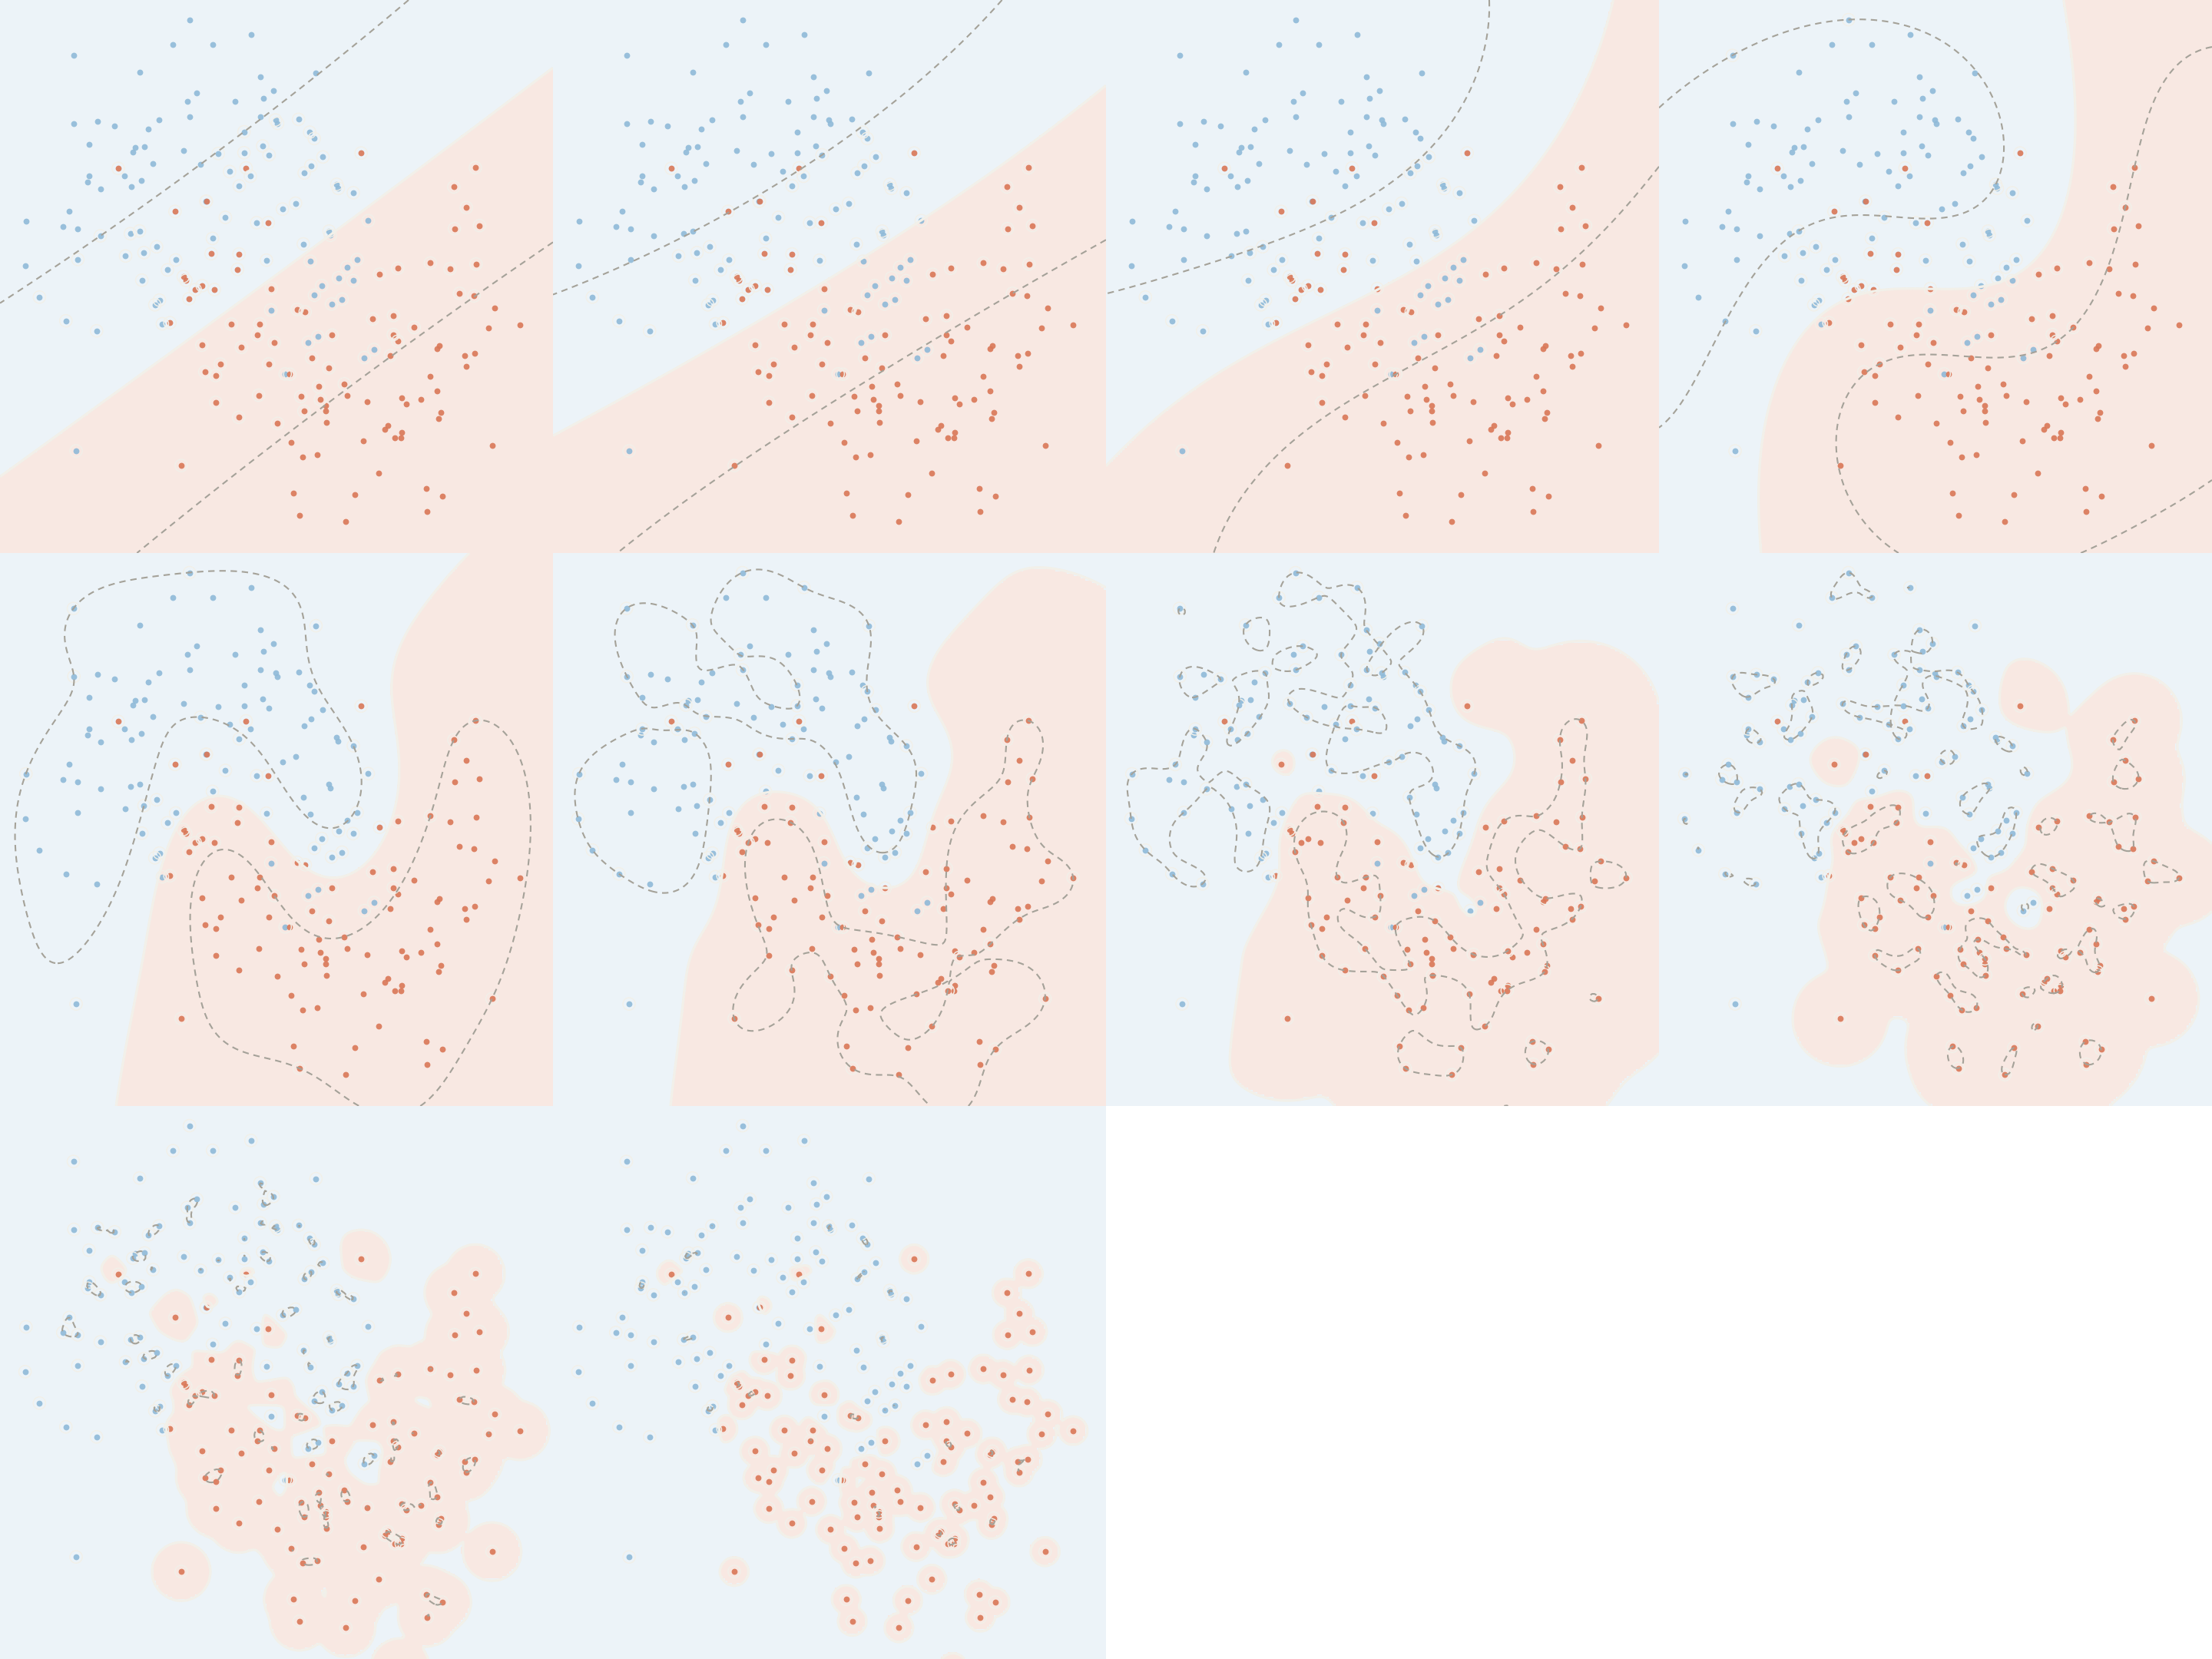
SVM RBF nhạy với khoảng cách; khi các cột khác đơn vị, hãy chuẩn hóa trong Pipeline và kiểm bằng validation.
Hỏi nhanh
SVM với kernel RBF, , đúng 100% trên train nhưng cross-validation chỉ được 70%. Ta nên thử gì trước?
lớn khiến mỗi vector hỗ trợ chỉ ảnh hưởng tới một vùng rất nhỏ, nên ranh giới uốn theo từng điểm train. Đó là dấu hiệu overfit. Giảm làm ranh giới mượt hơn, còn nhỏ hơn thì nới rộng lề. Tăng hay tăng là đi ngược hướng.
Chi phí và giới hạn
- Huấn luyện SVM có kernel tốn khoảng đến theo số mẫu. Quá vài chục nghìn mẫu là bắt đầu đuối.
- Với dữ liệu lớn, thưa, nhiều chiều như văn bản, dùng SVM tuyến tính (
LinearSVC): rất nhanh và rất tốt. - SVM không cho xác suất.
SVC(probability=True)hiệu chỉnh thêm bằng Platt scaling, chậm hơn và không hoàn hảo.
Hỏi nhanh
Cần phân loại 2 triệu bình luận, mỗi bình luận là một vector TF-IDF 100 000 chiều, rất thưa. Nên thử mô hình nào trước?
Kernel SVM tốn cỡ trở lên theo số mẫu, không chạy nổi với 2 triệu mẫu. Văn bản nhiều chiều thường đã gần tách được bằng một siêu phẳng, và LinearSVC xử lý vector thưa rất nhanh. Còn 1-NN trên 2 triệu vector thì mỗi lần dự đoán phải quét cả kho.
Đọc score trước khi đọc xác suất
Với , , . Mỗi điểm có score ; dấu quyết định phía của vạch, còn mới là khoảng cách hình học. Score 7 không có nghĩa xác suất 70%, vì score có đơn vị phụ thuộc cách đặt . Hinge loss lại dùng nhãn có dấu ; nếu lấy nhãn 0/1 nhân vào công thức, mọi mẫu lớp 0 đều có loss 1, là một lỗi âm thầm.
import numpy as np

w_margin = np.array([3., 4.])
b_margin = -10.
points_margin = np.array([[2., 1.], [3., 2.], [2., 1.1]])
labels_signed = np.array([1., 1., 1.])
scores = points_margin @ w_margin + b_margin
distances = np.abs(scores) / np.linalg.norm(w_margin)
hinge = np.maximum(0., 1. - labels_signed * scores)
print("score:", scores.round(3).tolist())
print("khoảng cách:", distances.round(3).tolist())
print("hinge:", hinge.round(3).tolist())
score: [0.0, 7.0, 0.4]
khoảng cách: [0.0, 1.4, 0.08]
hinge: [1.0, 0.0, 0.6]
Dòng thứ ba tách hai khái niệm: điểm score 0.4 được phân loại đúng phía nhưng vẫn chịu loss 0.6 vì nằm trong lề; điểm score 7 thì loss 0. Điểm nằm ngay trên vạch có score 0, cần quy ước phá hòa khi biến thành nhãn. Thư viện lo phần ấy, nhưng code tay cần ghi rõ.
Hỏi nhanh
Một mẫu có và . Hinge loss bằng bao nhiêu?
Signed margin là , nên loss là . Mẫu nằm đúng phía nhưng chưa ra khỏi lề.
Kiểm mẹo kernel bằng số
Ta kiểm ví dụ polynomial trong bài bằng cả hai cách: dựng đặc trưng ba chiều rồi tính tích vô hướng, và bình phương tích vô hướng hai chiều.
x_kernel = np.array([1., 2.])
z_kernel = np.array([3., 4.])
def phi2(v):
    a, b = v
    return np.array([a * a, np.sqrt(2.) * a * b, b * b])

print(round(float(phi2(x_kernel) @ phi2(z_kernel)), 6))
print(float((x_kernel @ z_kernel) ** 2))
assert np.allclose(phi2(x_kernel) @ phi2(z_kernel), (x_kernel @ z_kernel) ** 2)
121.0
121.0
Hai dòng cùng bằng 121. Ta tính được kernel mà không dựng từng tọa độ của không gian lớn hơn. Cái giá chuyển sang số mẫu: kernel SVM làm việc với quan hệ giữa các cặp mẫu, nên thời gian và bộ nhớ tăng nhanh theo . Hãy đo trên một phần nhỏ dữ liệu trước khi fit cả bộ.
Dùng thư viện
from sklearn.datasets import make_moons
from sklearn.model_selection import GridSearchCV
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = make_moons(n_samples=500, noise=0.25, random_state=0)
model = make_pipeline(StandardScaler(), SVC(kernel="rbf"))
grid = GridSearchCV(model, {"svc__C": [0.1, 1, 10, 100], "svc__gamma": [0.01, 0.1, 1, 10]}, cv=5)
grid.fit(X, y)
print(grid.best_params_, round(grid.best_score_, 3))
print("số vector hỗ trợ:", grid.best_estimator_[-1].n_support_.sum(), "trên", len(X))
{'svc__C': 1, 'svc__gamma': 10} 0.936
số vector hỗ trợ: 221 trên 500
Hỏi nhanh
Mô hình tốt nhất dùng 221 trên 500 điểm làm vector hỗ trợ. Con số này nói lên điều gì?
Với nhiễu 0.25, hai mặt trăng chồng lên nhau ở rìa, nên nhiều điểm nằm trong lề hoặc ở sai phía. Với lề mềm, tất cả những điểm ấy đều là vector hỗ trợ. Hệ quả thực tế là mỗi lần dự đoán phải tính kernel với 221 điểm. 279 điểm còn lại không bị bỏ đi, chúng chỉ nằm an toàn bên ngoài lề.
Khi đi thi
- Chuẩn hóa các cột trong từng fold trước SVM; dò
Cvàgammatrên thang log. - Văn bản thì thử TF-IDF cộng
LinearSVClàm baseline. - Đề cần xác suất thì dùng logistic regression, hoặc hiệu chỉnh SVM trên validation.
Tóm tắt
- SVM chọn siêu phẳng có lề lớn nhất; chỉ các vector hỗ trợ quyết định ranh giới.
- Lề mềm cân bằng giữa lề rộng và vi phạm bằng ; hàm mất mát là hinge loss.
- Kernel cho phép ranh giới cong mà không cần tạo đặc trưng; RBF điều khiển bằng .
- Chuẩn hóa đặc trưng; dò , trên thang log; hạn chế với dữ liệu rất lớn.
Kiểm tra cuối bài
Mười câu kiểm cả cách hiểu, phép tính và quy trình. Câu sai chỉ ra phần cần đọc lại; hãy làm trước khi mở lời giải.
Câu 1
, . Khoảng cách từ điểm tới siêu phẳng bằng bao nhiêu?
. Bias có mặt trong score, còn mẫu số chỉ dùng độ dài của . Ra 4 là quên chia. Ra 1.4 là có chia cho 10 nhưng quên .
Câu 2
Dữ liệu có bốn điểm: và mang nhãn , còn và mang nhãn . SVM lề cứng chỉ có và là vector hỗ trợ. Lề rộng bao nhiêu?
Hai vector hỗ trợ nằm trên hai biên, và siêu phẳng vuông góc với đoạn nối chúng, nên cùng phương với . Độ rộng lề đúng bằng độ dài đoạn ấy, . Giải bằng thư viện cũng ra và . Còn là khoảng cách từ mỗi vector hỗ trợ tới siêu phẳng, tức một nửa lề.
Câu 3
Một bài phân loại có vài điểm bị gán nhãn nhầm, nằm sâu trong vùng của lớp kia. SVM lề cứng và SVM lề mềm xử lý thế nào?
Chỉ cần một điểm nằm sâu bên kia là dữ liệu đã không tách được, nên lề cứng không có nghiệm. Lề mềm cho phép vi phạm, với chi phí là hinge loss nhân , và quyết định cân bằng giữa lề rộng và số vi phạm. Lề mềm vẫn dùng được với mọi kernel.
Câu 4
Một mẫu có và . Hinge loss bằng bao nhiêu?
Signed margin là , tức mẫu nằm sai phía, nên loss là . Ra 0 hay 1 là quên rằng mẫu đang ở sai phía.
Câu 5
Một mẫu có và . Nhân cả và với 2 thì siêu phẳng không đổi. Hinge loss của mẫu thay đổi thế nào?
Score thành 0.8, nên hinge loss là . Nằm đúng phía và nằm ngoài lề là hai chuyện khác nhau.
Câu 6
Trong mục tiêu , lớn có nghĩa là gì?
nhân với phần lỗi, không nhân với . Mô hình ưu tiên giảm vi phạm hơn là giữ lề rộng, nên lề thường hẹp lại và dễ overfit hơn.
Câu 7
Nhà máy có 10 000 bản ghi máy chạy bình thường, và gần như không có bản ghi máy hỏng. Vì sao one-class SVM hợp với việc phát hiện bất thường ở đây?
One-class SVM học một đường biên bao quanh vùng dữ liệu bình thường, dùng kernel như SVM thường, rồi coi điểm nằm ngoài biên là bất thường. Nó không cần mẫu hỏng để học, đúng tình huống hiếm khi có dữ liệu hỏng. Chi phí huấn luyện vẫn tăng nhanh theo số mẫu như kernel SVM.
Câu 8
SVM cho decision score bằng 2.0 ở một mẫu. Nếu đề yêu cầu xác suất để tính log loss, ta nên làm gì?
Score của SVM không phải là xác suất. Chia cho một số tùy ý hay cắt thành nhãn đều không cho ra xác suất đáng tin. Phép hiệu chỉnh, như Platt scaling hay isotonic, phải học trên dữ liệu chưa dùng để fit SVM, và không được dùng test.
Câu 9
Tự viết hinge loss bằng np.maximum(0, 1 - y*f), trong khi y nhận giá trị 0 hoặc 1. Ở các mẫu lớp 0, chuyện gì xảy ra?
Khi , tích bằng 0, nên loss luôn bằng 1 dù là bao nhiêu, và gradient theo cũng mất luôn. Công thức signed margin này cần nhãn được mã thành .
Câu 10
Kernel với ứng với một ánh xạ sang không gian bao nhiêu chiều?
Khai triển ra các số hạng ứng với , tức 6 chiều. Với và , cả hai cách tính đều ra 144. Mẹo kernel là ánh xạ ngầm sang không gian lớn hơn mà không phải dựng .
Đọc thêm
- Cortes, Vapnik (1995) — Support-Vector Networks, Machine Learning 20. Bài gốc của lề mềm.
- James, Witten, Hastie, Tibshirani — An Introduction to Statistical Learning, chương 9. Lề, kernel và so sánh với logistic regression.
-
Géron — Hands-On Machine Learning, chương 5. SVM tuyến tính, kernel và mẹo chọn , bằng scikit-learn.
-
scikit-learn — Support Vector Machines. Kernel, scaling, complexity, support vectors và probability calibration.
- ISLP — Support vector machines lab. Các thực nghiệm về C, gamma và validation.