Một học sinh gõ “quên thông tin đăng nhập” vào ô tìm kiếm, còn hướng dẫn cần tìm có tiêu đề “đặt lại mật khẩu”. Tìm theo từ khóa không ra, vì hai câu không chung từ nào. Sentence embedding biến mỗi câu thành một vector sao cho câu cùng ý có vector gần nhau, rồi tìm theo khoảng cách giữa các vector. Bài này học cách đo độ gần bằng cosine, cách gộp vector các token thành vector câu, cách model câu được huấn luyện, và cách chấm một hệ tìm kiếm.
Một vector câu có ý nghĩa gì?
Ở bài 6.1, số chiều của TF-IDF bằng số mục trong vocabulary, mỗi chiều ứng với một từ. Sentence embedding dùng số chiều cố định do model quy định; từng chiều không nhất thiết có tên dễ đọc. Ký hiệu hàm mã hóa là , với là câu. Hai câu được coi là gần nhau khi vector của chúng có hướng gần nhau trong không gian mà model đã học.
Có thể hình dung ba hướng “tài khoản”, “thư viện”, “lịch học”: đặt lại mật khẩu và khôi phục truy cập cùng nghiêng về hướng thứ nhất. Model thật có hàng trăm chiều và không chia nghĩa thành những nhãn tường minh như vậy.
Không gian ấy do mục tiêu huấn luyện quyết định: lấy trung bình hidden state của một model chỉ học điền từ bị che không bảo đảm có một không gian tốt để tìm câu cùng ý. Mục “Model câu học từ cặp câu” cho thấy model được dạy điều đó ra sao.
Bài 4.2 đã dùng cosine để tìm ảnh gần nhau; với câu, phép đo giữ nguyên:
Nó nằm trong với hai vector khác 0. Cosine 1 là cùng hướng, 0 là vuông góc, là ngược hướng. Không nên đọc 0.8 thành “80% xác suất đúng”: đây là một điểm tương tự, chưa được hiệu chuẩn thành xác suất. Với vector 0, góc không xác định; code phải phát hiện mẫu rỗng hoặc chọn quy ước xử lý rõ ràng.
import numpy as np

def unit_rows(matrix):
    length = np.linalg.norm(matrix, axis=1, keepdims=True)
    return matrix / np.maximum(length, 1e-12)

query_hand = np.array([[1.0, 1.0]])
docs_hand = np.array([[2.0, 2.0], [1.0, 0.0], [-1.0, -1.0]])
scores_hand = unit_rows(query_hand) @ unit_rows(docs_hand).T
print(scores_hand.round(3))
[[ 1. 0.707 -1. ]]
Điểm đầu là 1 dù vector tài liệu dài gấp đôi query: cosine chỉ nhìn hướng. Điểm thứ hai là (góc 45°), điểm thứ ba là (ngược hướng). Sau chuẩn hóa, cosine bằng tích vô hướng, nên với ma trận tài liệu shape (N, d) và query shape (d,), một phép nhân D @ q cho cả điểm.
Nếu bỏ bước chuẩn hóa, tích vô hướng còn thưởng thêm cho vector dài. Một số model được huấn luyện đúng với score ấy; model card ghi model dùng hàm score nào, và lúc tìm kiếm phải dùng đúng hàm đó.
Hỏi nhanh
Hai vector và có cosine bằng bao nhiêu?
, nên hai vector cùng hướng, và cosine bằng 1. 15 là tích vô hướng, chưa chia cho tích độ dài . 3 và 1/3 là tỉ số độ dài theo hai chiều, thứ mà cosine không đo.
Hỏi nhanh
Query là . Tài liệu A là , tài liệu B là . Xếp theo tích vô hướng thô thì tài liệu nào đứng đầu? Xếp theo cosine thì sao?
Tích vô hướng cho A là 3, cho B là 2. A thắng nhờ độ dài 3, dù lệch hướng 45°. Cosine cho A là , cho B là 1. B cùng hướng với query nên thắng. Hai cách xếp chắc chắn trùng nhau khi mọi tài liệu có cùng độ dài, chẳng hạn sau khi chuẩn hóa. Hai phương án còn lại đảo một trong hai kết quả vừa tính.
Pooling phải biết token nào là thật
Encoder thường trả một vector cho mỗi token: hidden states có shape (B, L, d), với là số câu trong batch, là độ dài sau padding. Ta cần một vector cho mỗi câu, shape (B, d). Mean pooling lấy trung bình nhưng phải dùng mask : bằng 1 nếu vị trí có token được giữ, bằng 0 nếu là padding.
Padding dùng để xếp câu dài ngắn vào cùng một tensor. Hidden state ở padding không được giả định luôn bằng 0; qua encoder, nó có thể khác 0. Nếu trung bình cả padding, vector câu sẽ phụ thuộc độ dài của những câu khác trong batch. Việc giữ hay bỏ token đặc biệt như [CLS] trong pooling phải theo đúng cách đã dùng khi huấn luyện model.
Bài 4.2 đã viết phép tính này cho last_hidden_state; ở đây hàm masked_mean còn được dùng lại để huấn luyện ở mục sau. Hidden states được đặt tay để thấy riêng phép toán: hai token thật là và , hai vị trí padding là . Mean đúng bằng , còn mean tính cả padding bị kéo về .
import torch

torch.set_num_threads(1)
hidden = torch.tensor([[[2., 0.], [0., 2.], [9., 9.], [9., 9.]]])
attention_mask = torch.tensor([[1, 1, 0, 0]])

def masked_mean(hidden_states, mask):
    weight = mask.unsqueeze(-1)
    weight = weight.to(hidden_states.dtype)
    token_count = weight.sum(dim=1).clamp_min(1)
    weighted_sum = (
        hidden_states * weight
    ).sum(dim=1)
    return weighted_sum / token_count

print("mean sai:", hidden.mean(dim=1).tolist())
print("mean đúng:", masked_mean(hidden, attention_mask).tolist())
print("shape:", tuple(masked_mean(hidden, attention_mask).shape))
mean sai: [[5.0, 5.0]]
mean đúng: [[1.0, 1.0]]
shape: (1, 2)
unsqueeze(-1) biến (B, L) thành (B, L, 1) để nhân cùng trọng số cho cả chiều. clamp_min(1) tránh chia 0, nhưng không khiến câu toàn padding có ý nghĩa; pipeline phải chặn đầu vào rỗng trước khi tìm kiếm.
Hỏi nhanh
Encoder đã ở eval() và nhận đủ input_ids lẫn attention_mask. Encode câu “mượn sách” một mình thì được vector . Encode nó chung batch với một câu dài hơn thì được , và . Nguyên nhân khả dĩ nhất là gì?
Khi encoder nhận attention_mask, token thật không nhìn vào padding. Vì vậy hidden state của chúng gần như giống hệt, dù câu đi một mình hay đi chung batch. Chỉ khi pooling cộng cả các vị trí padding, vector câu mới bị kéo theo độ dài của câu kia. eval() đã tắt dropout. Sai số làm tròn float32 chỉ cỡ , không thể kéo cosine xuống 0.93. Tokenizer tách một câu cố định theo cùng một cách. Padding chỉ thêm vị trí đệm, không đổi token của câu.
Hỏi nhanh
Sau masked mean, pipeline luôn chuẩn hóa L2 rồi mới tính cosine. Trong masked_mean, một đội lỡ viết token_count = weight.sum(), tức tổng số token thật của cả batch, thay vì của từng câu. Thứ hạng retrieval thay đổi thế nào?
Tử số vẫn chỉ cộng token thật, nên hướng của mỗi vector câu không đổi. Chia cho số dương nào rồi chuẩn hóa L2 cũng cho cùng một vector đơn vị. Padding đã bị loại ở tử số, nên không kéo được câu ngắn. Chia tensor (B, d) cho một số là broadcasting hợp lệ, không báo lỗi. Cosine không phụ thuộc độ dài, nên không giảm theo cỡ batch. Mẫu số chỉ quan trọng khi vector chưa chuẩn hóa được dùng tiếp, như với tích vô hướng thô, hay với MSE và mục tiêu one-hot ở mục sau.
Mốc từ vựng trước khi tìm theo nghĩa
Kho có ba tài liệu ngắn; ba query hỏi về đúng ba chủ đề ấy. Dấu gạch dưới nối các âm tiết của một từ để split() tách đúng từ, thay cho bước tách từ tiếng Việt ở bài 6.1. Query “quên truy_cập” dùng cách nói khác hẳn tài liệu “đặt_lại mật_khẩu”. Tài liệu đúng (gold) của từng query nằm trong relevant.
from sklearn.feature_extraction.text import TfidfVectorizer

documents = ["đặt_lại mật_khẩu", "mượn sách", "xem thời_khóa_biểu"]
queries = ["quên truy_cập", "mượn sách", "lịch học"]
relevant = np.array([0, 1, 2])

lexical = TfidfVectorizer(tokenizer=str.split, token_pattern=None)
document_tfidf = lexical.fit_transform(documents)
query_tfidf = lexical.transform(queries)
lexical_scores = (query_tfidf @ document_tfidf.T).toarray()
print(lexical_scores.round(3))
[[0. 0. 0.]
[0. 1. 0.]
[0. 0. 0.]]
Hàng có toàn 0 không đưa ra bằng chứng tài liệu nào gần hơn: các từ của query đều ngoài vocabulary. Nếu argmax chọn tài liệu đầu tiên, đó chỉ là quy tắc phá hòa; không thể báo là hệ thống hiểu “quên truy cập”. Query trùng chữ “mượn sách” cho điểm 1. Baseline từ vựng này là mốc mà model embedding phải vượt trên những cách diễn đạt mới.
Chiều ngược lại cũng xảy ra: khi query là một mã chính xác như lỗi “E1234”, tìm theo từ khóa thắng, còn embedding gom nó vào các bài nói chung về lỗi máy. Hệ thống thật thường ghép hai cách (hybrid search).
Hỏi nhanh
Thêm tài liệu thứ tư “đăng_ký học thêm” vào documents, rồi fit lại TF-IDF. Bây giờ query “lịch học” cho kết quả gì?
“học” giờ đã có trong vocabulary, nên query chỉ còn cột “học”, với độ dài 1. Tài liệu mới có ba từ, mỗi từ xuất hiện trong đúng một tài liệu, nên cùng IDF. Sau chuẩn hóa, mỗi cột là , và đó cũng là tích vô hướng với query. “xem thời_khóa_biểu” không chứa “học” nên vẫn được 0. TF-IDF không biết hai từ gần nghĩa nhau. “lịch” vẫn bị bỏ, nhưng chỉ cần một từ khớp là hàng đã khác 0. Kết quả là một tài liệu chung chữ nhưng khác ý đứng trên gold.
Học một không gian nhỏ từ nhãn chủ đề
Muốn “quên truy_cập” gần “đặt_lại mật_khẩu”, biểu diễn phải học được rằng các từ khác chữ có thể cùng ý. Thí nghiệm nhỏ nhất làm được việc đó có chín câu train thuộc ba chủ đề; mỗi câu có vector mục tiêu one-hot ba chiều, chẳng hạn chủ đề tài khoản là . Một bảng embedding token ba chiều, khởi tạo ngẫu nhiên, cho mỗi câu vector bằng masked mean của các token; MSE kéo vector câu về mục tiêu của chủ đề.
Đây là encoder nhỏ nhất có thể: không attention, không ngữ cảnh, học trong vài giây, nhưng đi đúng đường của model thật: token thành vector, pooling có mask, chuẩn hóa rồi so cosine.
torch.manual_seed(6)
train_sentences = [
    "đặt_lại mật_khẩu", "quên mật_khẩu", "khôi_phục truy_cập",
    "mượn sách", "thẻ thư_viện", "gia_hạn sách",
    "xem thời_khóa_biểu", "lịch học", "buổi học",
]
topic = torch.tensor([0, 0, 0, 1, 1, 1, 2, 2, 2])
vocabulary = {word: i + 1 for i, word in enumerate(
    sorted({word for sentence in train_sentences for word in sentence.split()})
)}

def encode_batch(sentences):
    token_lists = [[vocabulary.get(word, 0) for word in sentence.split()] for sentence in sentences]
    max_length = max(len(tokens) for tokens in token_lists)
    ids = torch.zeros(len(sentences), max_length, dtype=torch.long)
    for row, tokens in enumerate(token_lists):
        ids[row, :len(tokens)] = torch.tensor(tokens)
    return ids, ids.ne(0)

embedding = torch.nn.Embedding(len(vocabulary) + 1, 3, padding_idx=0)
optimizer = torch.optim.Adam(embedding.parameters(), lr=0.05)
train_ids, train_mask = encode_batch(train_sentences)
target_vectors = torch.nn.functional.one_hot(topic, 3).float()
history = []
for step in range(160):
    optimizer.zero_grad()
    sentence_vectors = masked_mean(embedding(train_ids), train_mask)
    loss = torch.nn.functional.mse_loss(sentence_vectors, target_vectors)
    loss.backward()
    optimizer.step()
    history.append(loss.item())
print("MSE đầu/cuối:", round(history[0], 4), round(history[-1], 4))
MSE đầu/cuối: 0.7867 0.0
MSE về 0.0 (làm tròn bốn chữ số) nghĩa là mean vector của mọi câu train gần như trùng mục tiêu; đó là phép đo trên train, chưa phải metric retrieval. ID 0 dùng chung cho padding và từ chưa gặp, nên từ lạ bị loại khỏi mean. Query chỉ gồm từ lạ thành rỗng, và encode_small dưới đây dừng với lỗi thay vì trả một tài liệu tùy ý. Tokenizer subword ở bài 6.1 tránh tình huống này bằng cách ghép từ lạ từ những mảnh quen.
Ta encode documents và queries bằng cùng bảng, chuẩn hóa rồi tìm điểm lớn nhất.
def encode_small(sentences):
    ids, mask = encode_batch(sentences)
    if not torch.all(mask.any(dim=1)):
        raise ValueError("Có câu không chứa token đã biết")
    with torch.no_grad():
        vectors = masked_mean(embedding(ids), mask).numpy()
    return unit_rows(vectors)

document_vectors = encode_small(documents)
query_vectors = encode_small(queries)
learned_scores = query_vectors @ document_vectors.T
print(learned_scores.round(3))
print("top-1:", learned_scores.argmax(axis=1).tolist())
[[ 0.845 0.211 -0.491]
[-0. 1. -0. ]
[-0. 0. 1. ]]
top-1: [0, 1, 2]
Hàng đầu là query đáng xem nhất: “quên truy_cập” không có nguyên câu trong train, nhưng cả hai token đều thuộc nhóm tài khoản, và tài liệu mật khẩu đứng đầu với 0.845. Hai hàng còn lại cho điểm 1 tròn vì cả query lẫn tài liệu đúng của chúng đều là câu train, và MSE đã đặt mean của mọi câu train cùng chủ đề vào cùng một điểm; hai query này chỉ kiểm việc nhớ lại.
Một query mới chưa đủ để biết bảng đã học gì. Ta xem vector của hai từ trong câu train “quên mật_khẩu”, rồi thử hai cách ghép chưa có trong train.
def word_vector(word):
    return embedding.weight[vocabulary[word]].detach().numpy()

forget, password = word_vector("quên"), word_vector("mật_khẩu")
print("quên:", forget.round(2))
print("mật_khẩu:", password.round(2))
print("trung bình:", ((forget + password) / 2).round(2) + 0.0)
held_out = ["khôi_phục mật_khẩu", "quên thẻ thư_viện"]
print((encode_small(held_out) @ document_vectors.T).round(3))
quên: [ 0.95 0.41 -0.66]
mật_khẩu: [ 1.05 -0.41 0.66]
trung bình: [1. 0. 0.]
[[ 0.725 -0.272 0.633]
[ 0.357 0.901 -0.248]]
Thành phần đầu của “quên” và “mật_khẩu” cộng lại bằng 2, còn thành phần thứ hai và thứ ba đối dấu nhau, nên trung bình rơi đúng . MSE chỉ ràng buộc trung bình của từng câu train, không ràng buộc từng từ; phần dư của mỗi từ được phép lớn, miễn là triệt tiêu trong câu train.
Hai cách ghép mới cho thấy hệ quả:
- “khôi_phục mật_khẩu”: hai từ chưa từng đứng cùng câu, nên phần dư không còn triệt tiêu. Query vẫn chọn tài liệu mật khẩu (0.725) nhưng tài liệu lịch học bám sát ở 0.633.
- “quên thẻ thư_viện”: có hai từ của câu train “thẻ thư_viện”, cùng với “quên” của nhóm tài khoản. Ở seed này mean nghiêng về thư viện (0.901), đúng với ý của câu.
Phần dư phụ thuộc khởi tạo: đổi torch.manual_seed(6) thành torch.manual_seed(0) rồi chạy lại, cả hai query ghép đều chọn sai tài liệu. Hai câu “An giúp Bình” và “Bình giúp An” vẫn có cùng mean vì bảng token không nhìn thứ tự. Một model câu thật cần ngữ cảnh, nhiều dữ liệu hơn và một mục tiêu so sánh trực tiếp các câu với nhau.
Hỏi nhanh
Trong train, đặt_lại cũng chỉ xuất hiện trong một câu, cùng với mật_khẩu, với mục tiêu . Khi MSE về gần 0, vector của đặt_lại gần với vector nào nhất?
MSE gần 0 buộc trung bình của “đặt_lại mật_khẩu” và của “quên mật_khẩu” cùng bằng . Vì vậy cả đặt_lại lẫn quên đều phải bằng , với là vector của mật_khẩu. Dữ liệu không bao giờ phân biệt hai từ, nên bảng coi chúng như nhau, dù “quên” và “đặt lại” không cùng nghĩa. Ràng buộc đặt lên trung bình câu chứ không lên từng từ, nên từ không tự bằng . Nó cũng không bằng mật_khẩu, vì khi đó trung bình là chính mật_khẩu. Khởi tạo riêng của hai hàng không còn quyết định gì: khi trung bình câu đã khớp mục tiêu, quên và đặt_lại bị xác định hoàn toàn bởi mật_khẩu.
Đo thứ hạng
Nếu mỗi query có đúng một tài liệu liên quan, Recall@k là tỉ lệ query có tài liệu ấy trong top . Reciprocal rank là nghịch đảo thứ hạng của tài liệu đúng, và MRR (mean reciprocal rank) là trung bình các nghịch đảo đó: đúng ở hạng 1 đóng góp 1, ở hạng 3 đóng góp . Khi nhiều tài liệu cùng liên quan, phải định nghĩa tập đáp án (gold set) và metric phù hợp; không ép chúng vào một ID tùy tiện.
Với một hệ thống RAG (bài 6.6) trả lời sai, đo Recall@k của bước tìm tài liệu trước tiên: đoạn đúng không có trong top thì model ngôn ngữ dù tốt cũng không có gì để dựa vào.
def retrieval_metrics(scores, gold):
    # stable giúp quy tắc phá hòa được xác định, không tạo thêm bằng chứng.
    order = np.argsort(-scores, axis=1, kind="stable")
    rank = np.array([np.flatnonzero(row == correct)[0] + 1
                     for row, correct in zip(order, gold)])
    return (rank == 1).mean(), (1 / rank).mean(), rank

for name, scores in [("TF-IDF", lexical_scores), ("embedding nhỏ", learned_scores)]:
    recall, mrr, ranks = retrieval_metrics(scores, relevant)
    print(name, "rank:", ranks.tolist(), "R@1:", round(recall, 3), "MRR:", round(mrr, 3))
TF-IDF rank: [1, 1, 3] R@1: 0.667 MRR: 0.778
embedding nhỏ rank: [1, 1, 1] R@1: 1.0 MRR: 1.0
TF-IDF có thứ hạng [1, 1, 3]. Query đầu toàn điểm 0 nhưng vẫn được tính hạng 1, chỉ vì tài liệu đúng nằm ở chỉ số 0 và sắp xếp stable giữ thứ tự gốc khi hòa. R@1 0.667 vì thế chứa một lần trúng nhờ phá hòa; báo metric phải kèm điểm, và đếm riêng những hàng toàn 0. Embedding nhỏ đạt R@1 và MRR cùng bằng 1.0, nhưng hai trong ba query là chính câu train.
Hỏi nhanh
Giữ nguyên query và điểm TF-IDF, chỉ xếp lại kho thành [“mượn sách”, “xem thời_khóa_biểu”, “đặt_lại mật_khẩu”]. R@1 và MRR của TF-IDF thành bao nhiêu?
“mượn sách” vẫn có điểm 1, nên giữ hạng 1. Hai query toàn 0 giữ thứ tự của kho. Gold của “quên truy_cập” giờ ở chỉ số 2, tức hạng 3, còn gold của “lịch học” ở chỉ số 1, tức hạng 2. Thứ hạng [3, 1, 2] cho R@1 bằng và MRR bằng . Không có thông tin gì mới, vậy mà metric vẫn đổi: phần thay đổi đến từ thứ tự lưu tài liệu. 0.667 và 0.778 là số cũ, chỉ đúng với thứ tự cũ. Hai phương án còn lại chỉ đổi một trong hai số.
Một bộ đánh giá retrieval có ích cần ba thứ mà ba query này chưa có:
- Query do người khác viết, không chép từ train.
- Kho có hard negative: tài liệu chung nhiều chữ với query nhưng trả lời việc khác, như “gia_hạn thẻ thư_viện” và “làm_lại thẻ thư_viện”.
- Cách chia giống lúc dùng: nếu đề chấm trên những câu hỏi thường gặp (FAQ) chưa xuất hiện lúc train, mọi cách hỏi của cùng một FAQ phải nằm cùng một phía.
Chia ngẫu nhiên theo từng câu hỏi thì các cách hỏi gần trùng của một FAQ có mặt ở cả hai phía, và validation chỉ đo việc nhận lại.
Model câu học từ cặp câu
Bảng nhỏ ở trên học từ nhãn chủ đề, nên chỉ biết ba hướng. Model câu được fine-tune trên cặp câu: Sentence-BERT gốc dùng cặp có nhãn suy luận (NLI), các model về sau thêm câu với bản diễn đạt lại, câu hỏi với câu trả lời. Với model dùng để tìm kiếm, mục tiêu phổ biến không còn là một vector cố định cho mỗi lớp mà là so sánh: cặp đúng phải có score cao hơn các cặp sai, và chính các cặp khác trong batch làm negative.
Với cặp đã chuẩn hóa,
Mỗi hàng là một bài phân loại lớp mà lớp đúng là tài liệu của chính cặp đó; tài liệu còn lại là in-batch negatives. Nhiệt độ nhỏ làm softmax nhọn hơn. Đây là cùng dạng loss của CLIP ở bài 4.5 và SimCLR ở bài 5.7, chỉ khác hai phía đều là câu; thư viện Sentence Transformers gọi nó là MultipleNegativesRankingLoss.
Loss đòi tài liệu đúng đứng trên các tài liệu khác, đúng điều Recall@k và MRR đo, nhưng nó khả vi theo tham số, còn hai metric thứ hạng thì không.
Model kiểu này là bi-encoder: câu hỏi và tài liệu được mã hóa riêng, nên vector tài liệu tính sẵn một lần và tìm trong một triệu đoạn chỉ còn là phép nhân ma trận. Cross-encoder đưa cả cặp vào một model để chấm trực tiếp, chính xác hơn nhưng phải chạy lại cho từng cặp; thường dùng nó để xếp lại vài chục ứng viên đầu do bi-encoder tìm ra.
Negative lấy ngẫu nhiên thường quá dễ: phân biệt “mượn sách” với “xem thời_khóa_biểu” không dạy model điều gì mới. Hard negative là tài liệu chung chữ hoặc chủ đề với query nhưng không trả lời nó, được thêm làm một cột cho mỗi hàng. Nó phải thật sự sai. Nếu “hard negative” là một bản diễn đạt khác của tài liệu đúng, loss sẽ đẩy query ra xa chính câu trả lời của nó (false negative). Lỗi cùng loại xảy ra khi hai cặp trong một batch có chung tài liệu đúng.
Hỏi nhanh
Khi train bằng contrastive loss, mỗi query được thêm một hard negative. Query “đổi mật khẩu” có tài liệu đúng là “Hướng dẫn đặt lại mật khẩu”. Nên chọn hard negative nào?
Hard negative có ích phải vừa dễ nhầm, vừa thật sự sai. “Đổi lịch học” chung chữ “đổi” nhưng trả lời một việc khác, buộc model nhìn vào ý chứ không chỉ nhìn chữ. “Các bước đổi mật khẩu tài khoản” chung nhiều chữ nhất, nhưng cũng trả lời đúng query. Đẩy nó ra xa là dạy model điều sai, gọi là false negative. Tài liệu mượn sách hay một tài liệu ngẫu nhiên đã khác xa query, nên xác suất softmax của chúng gần 0, và gần như không cho gradient.
Dùng model pretrained
Script sentence embedding chạy lại đúng thí nghiệm tìm kiếm của bài với model sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2. Ba tài liệu và ba query được viết thành câu tiếng Việt đầy đủ, không cần gạch dưới: “Hướng dẫn đặt lại mật khẩu” đi với “Tôi quên thông tin đăng nhập”, và tương tự cho mượn sách, lịch học.
Script dùng tokenizer của model, masked mean pooling và chuẩn hóa L2, rồi in ma trận điểm và top-1 dưới dạng JSON. Trước khi encode, nó đọc cấu hình pooling của model để chắc model dùng mean pooling, và dừng nếu có câu dài hơn max_seq_length thay vì để tokenizer cắt âm thầm. Script không tải gì từ Internet; hướng dẫn của chương nêu cách chuẩn bị model trên máy.
Ma trận điểm được đọc như hai baseline: hàng là query, cột là tài liệu. Hàng “Tôi quên thông tin đăng nhập” cho biết model có đưa tài liệu mật khẩu lên đầu khi hai bên không chung chữ hay không, và khoảng cách giữa điểm cao nhất với điểm thứ hai cho biết lựa chọn ấy chắc đến đâu.
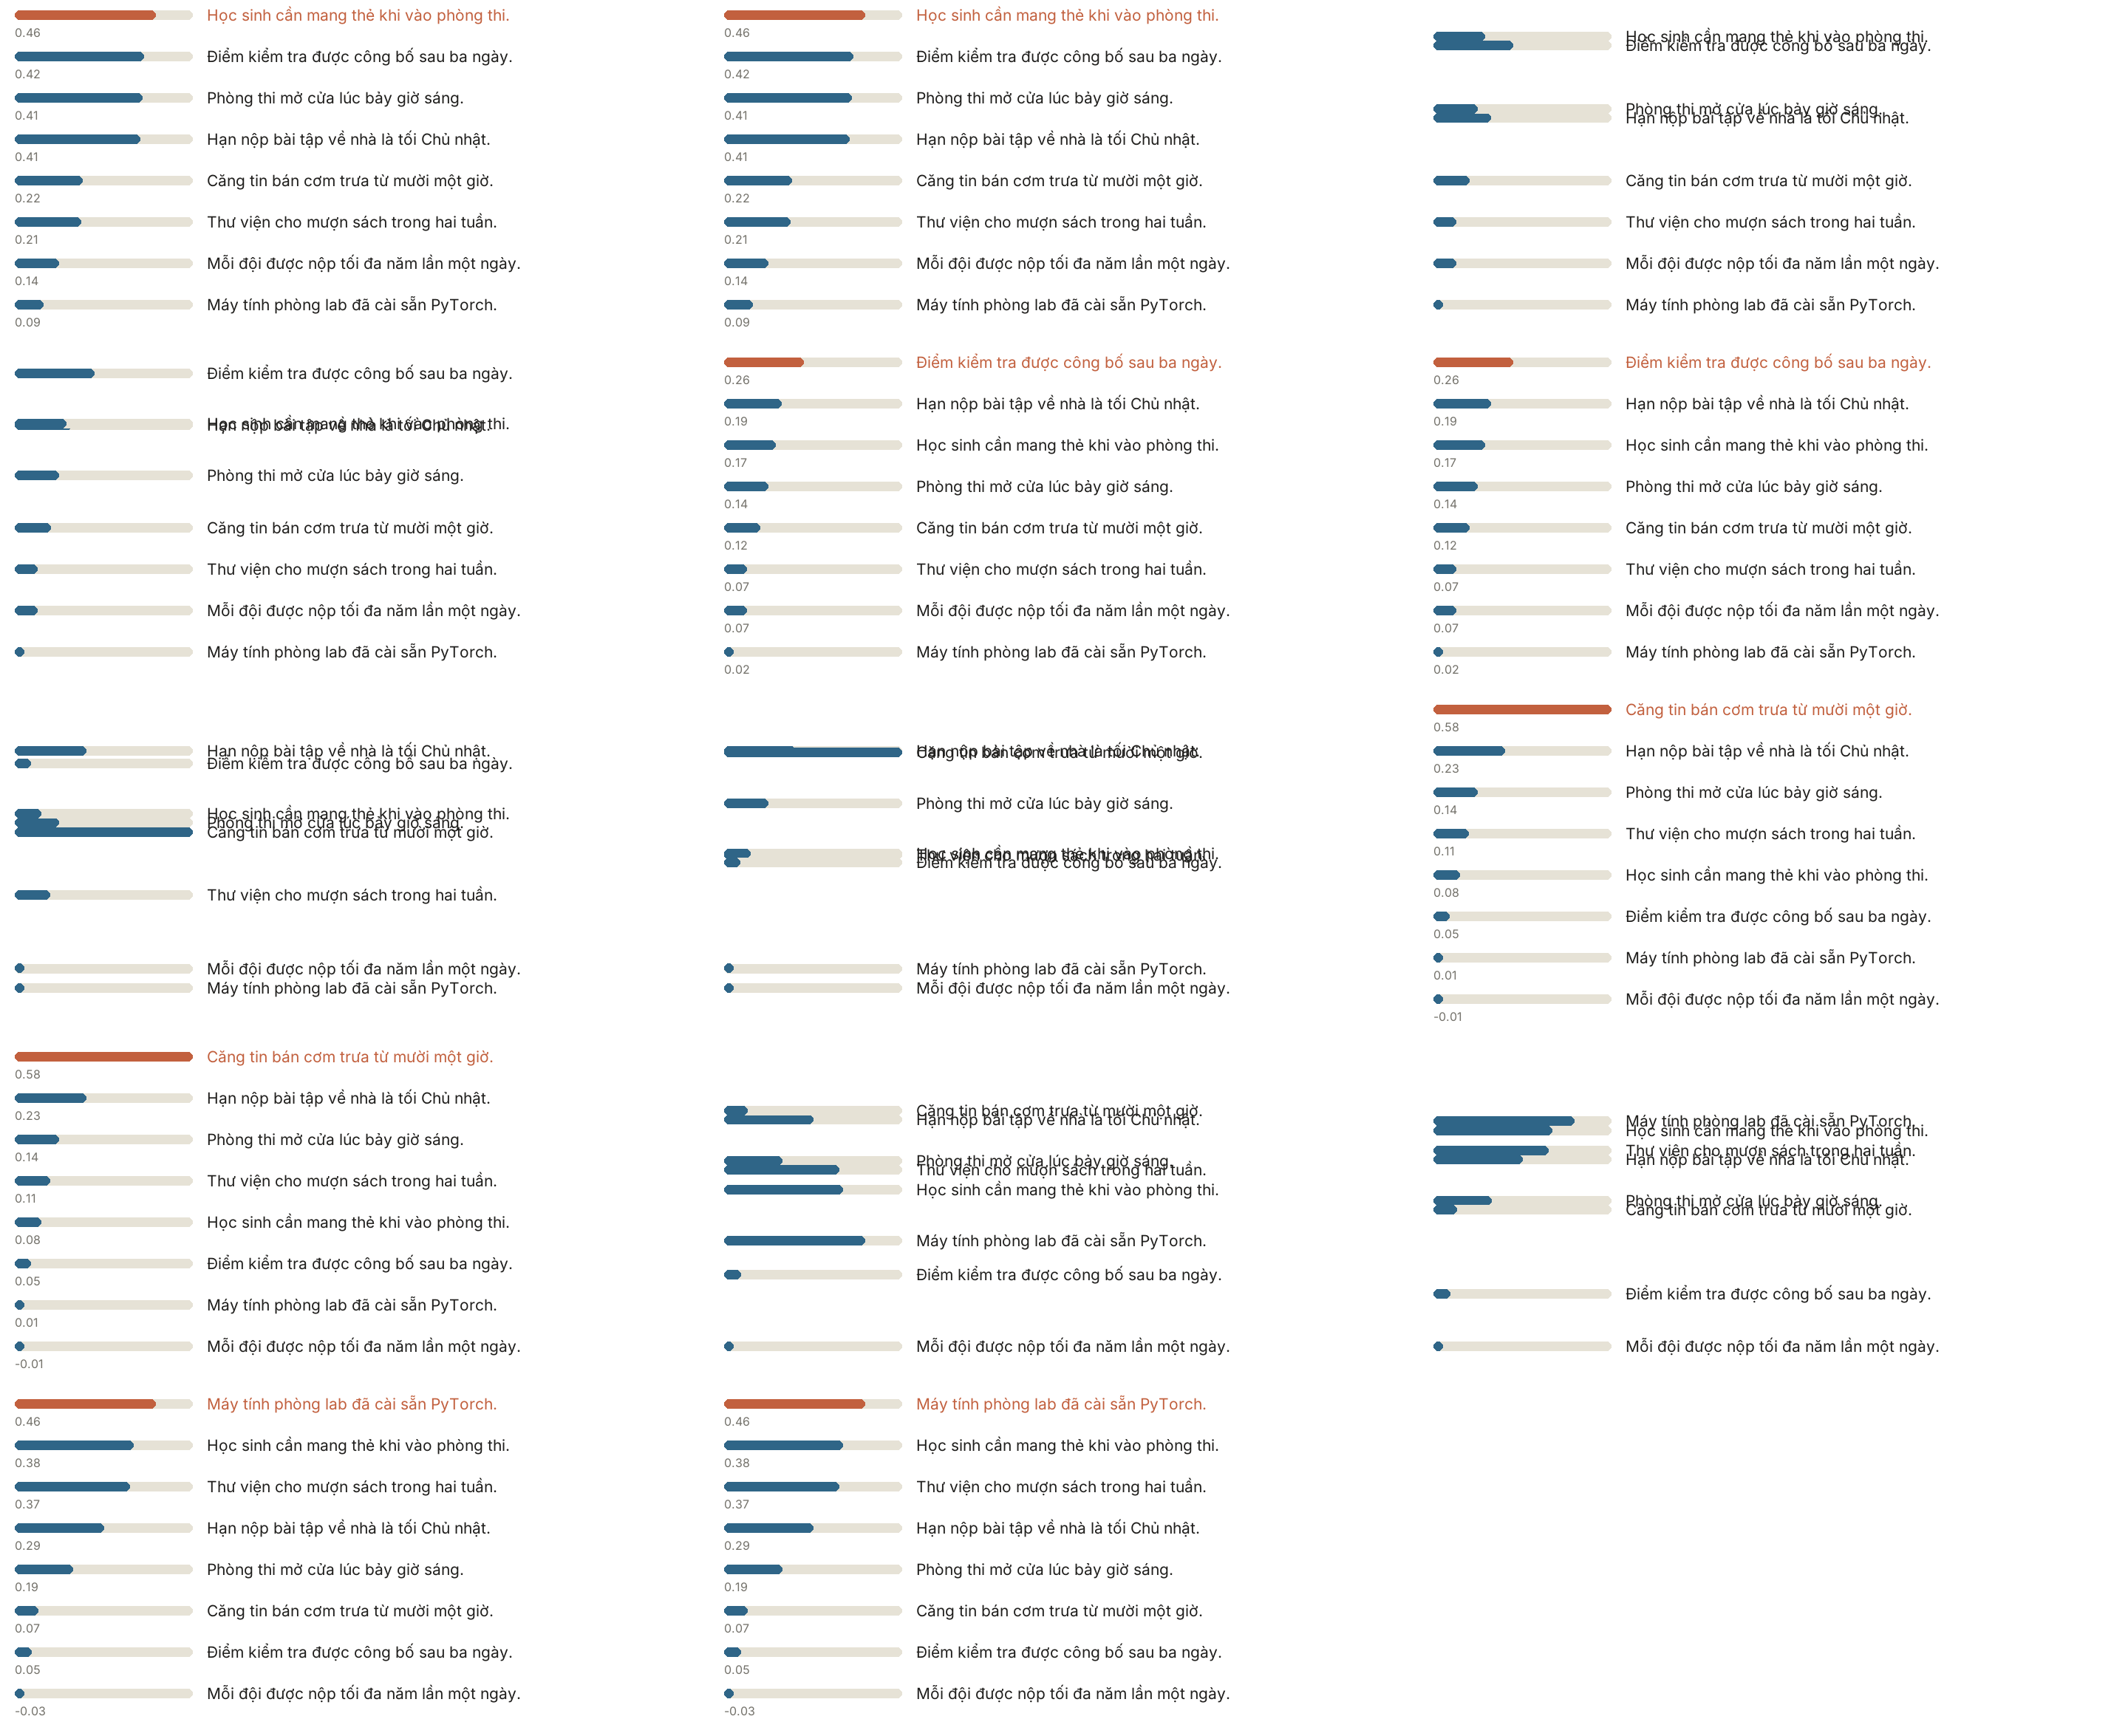
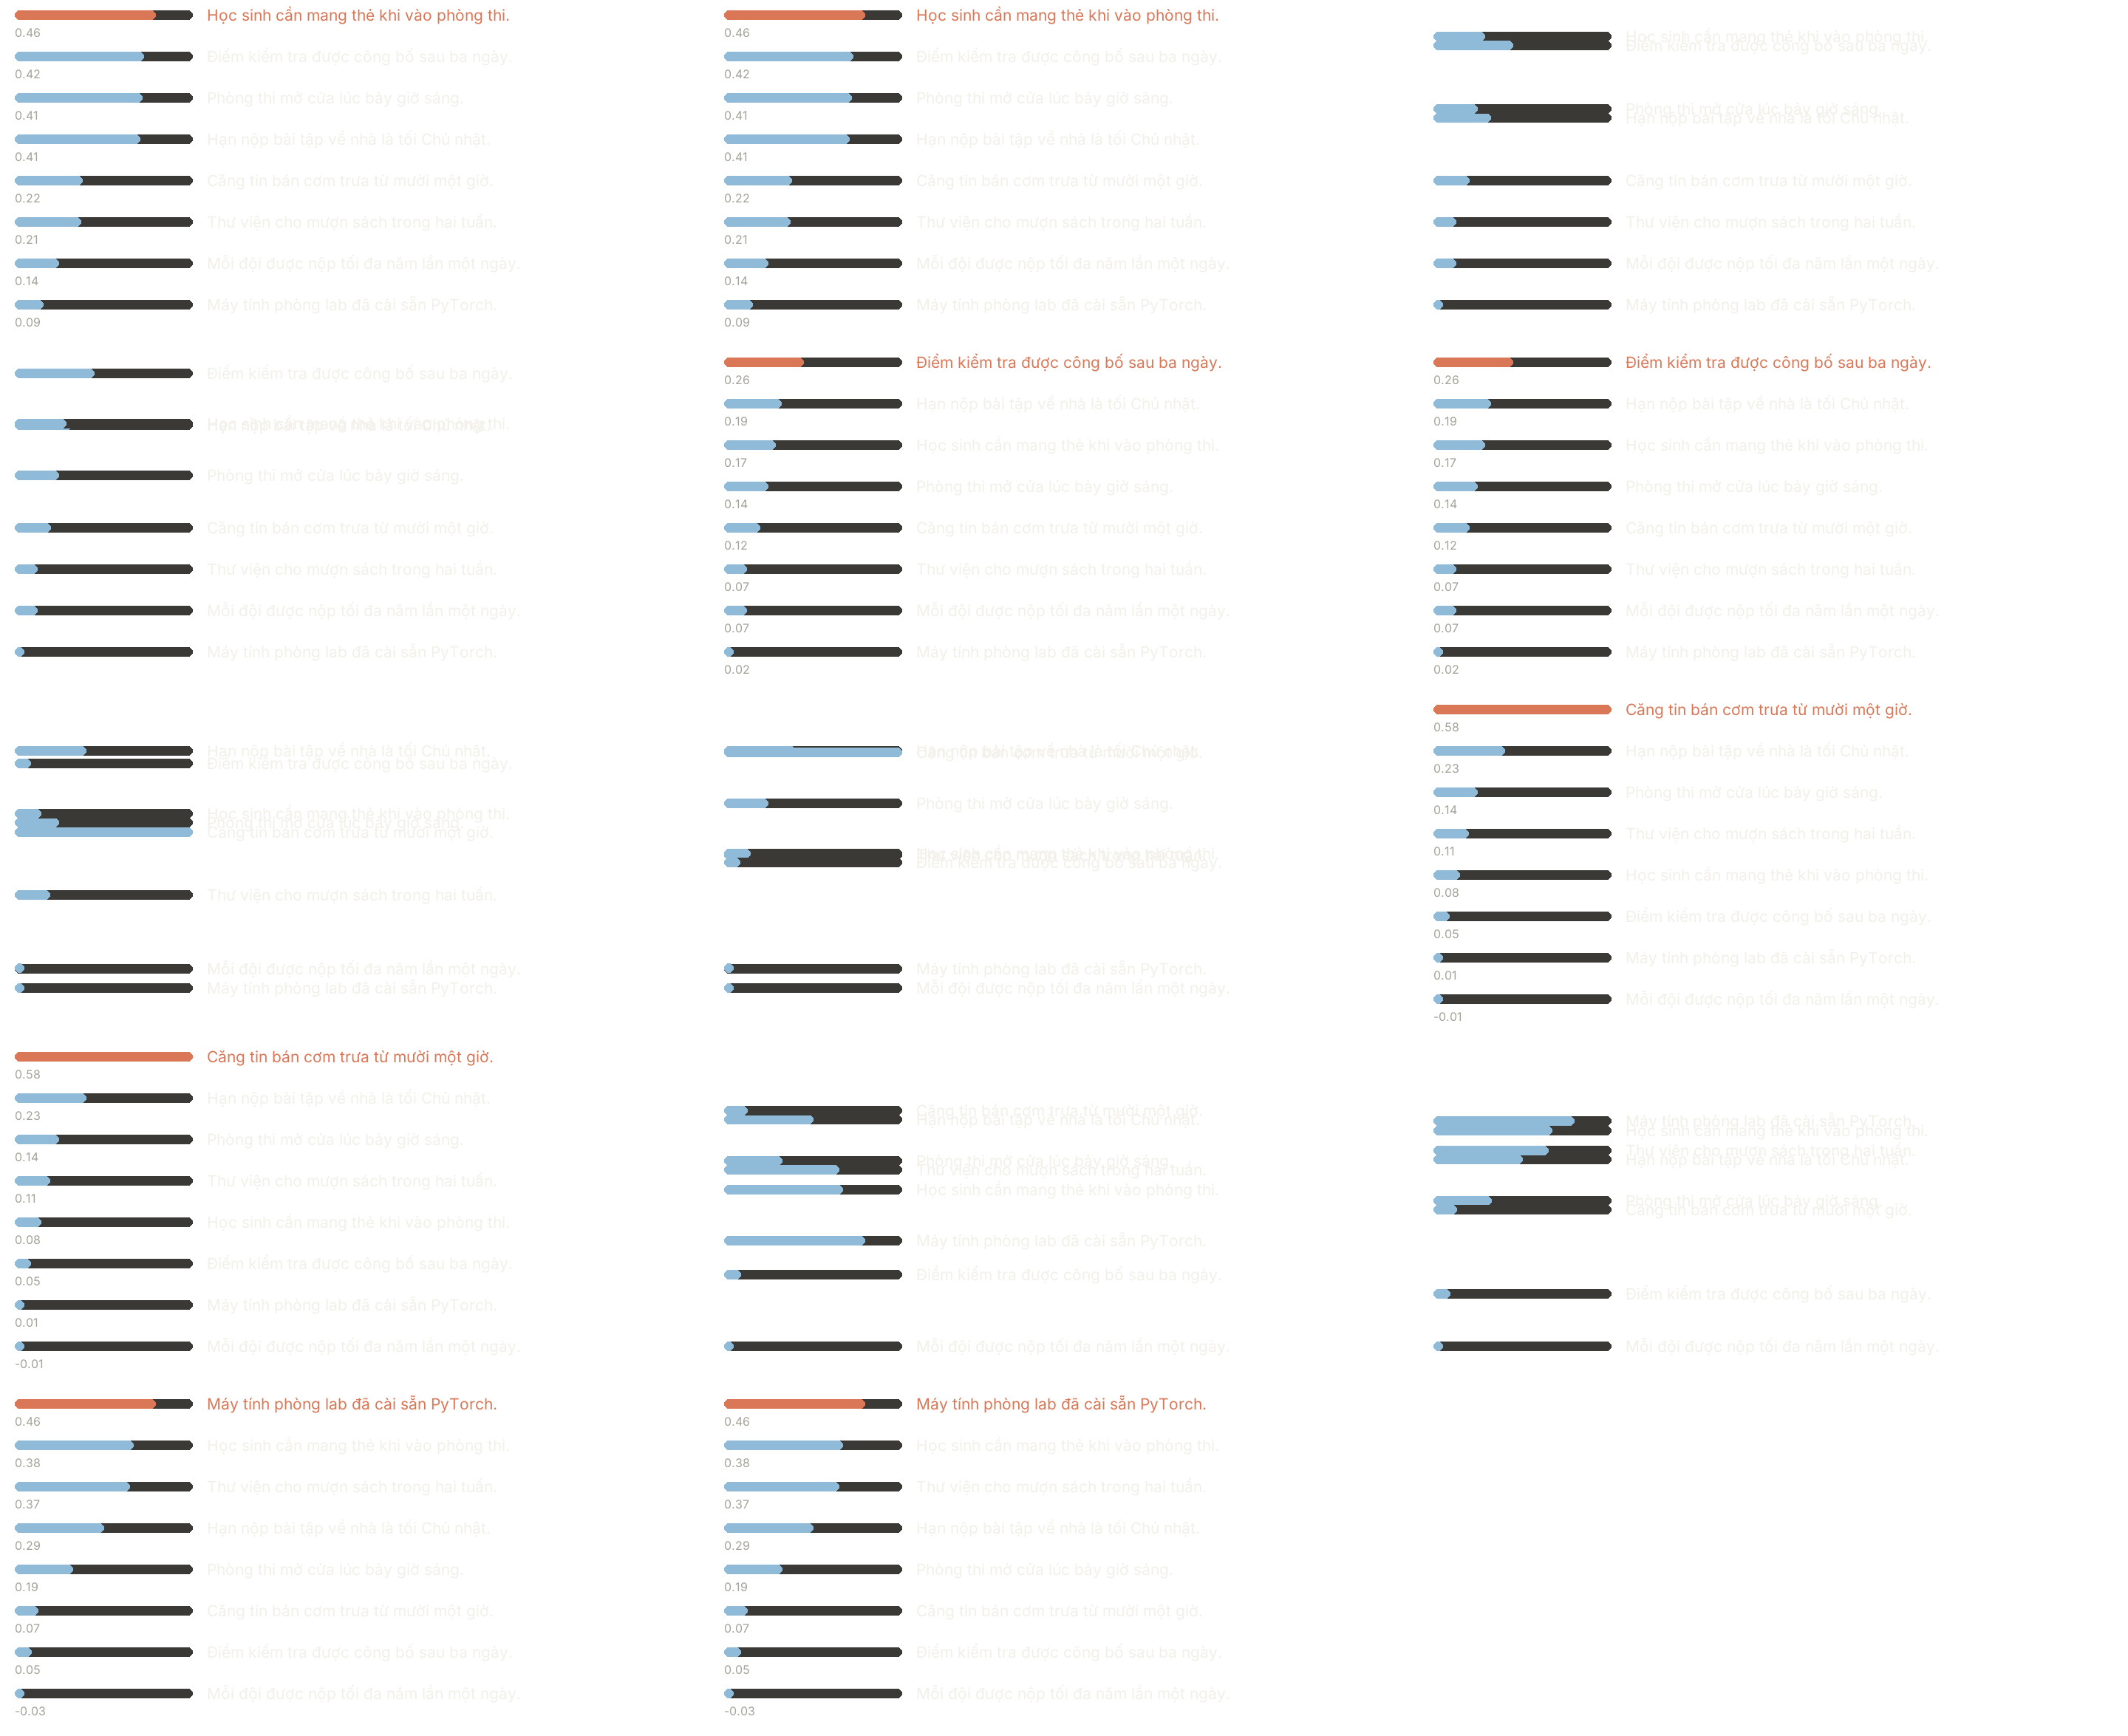
Với kho lớn, tài liệu được encode một lần theo batch rồi lưu lại kèm tên model, tokenizer, cách pooling và chuẩn hóa; đổi một thành phần là phải encode lại. Tài liệu dài hơn độ dài tối đa được chia thành đoạn, có thể chồng lên nhau một phần để câu trả lời không bị cắt đôi. Mỗi đoạn có điểm riêng, và điểm của tài liệu được gộp từ điểm các đoạn theo một quy tắc ghi rõ.
Tìm kiếm vét cạn là một phép nhân ma trận: kho đoạn, mỗi đoạn 384 số float32, chiếm byte MB, và mỗi query tốn khoảng phép nhân–cộng. Đó là mốc đúng để đối chiếu; chỉ chuyển sang tìm kiếm gần đúng khi đã đo được brute force quá chậm, và khi ấy phải đo phần recall bị mất. Ngưỡng score và chọn bằng validation: cosine không có ngưỡng chung cho mọi model.
Hỏi nhanh
Tài liệu nội quy thư viện dài 40 đoạn, mỗi đoạn được encode riêng. Chỉ đoạn 17 trả lời query “mất thẻ thì làm gì”. Nên gộp điểm của cả tài liệu thế nào?
Chỉ cần một đoạn trả lời là tài liệu đã liên quan, nên điểm lớn nhất giữ được tín hiệu của đoạn 17. Đoạn ấy cũng là thứ nên hiển thị cho người hỏi. Lấy trung bình thì một đoạn tốt bị pha loãng giữa 39 đoạn không liên quan, và một tài liệu dài mà đúng có thể thua một tài liệu ngắn mà sai. Chỉ encode đoạn đầu, hay nối lại để tokenizer cắt, đều làm mất đúng đoạn 17 mà không báo lỗi.
Phản hồi gần nghĩa: đoán từ theo score
Một dạng bài tương tác: chương trình đoán một từ, judge trả về độ gần nghĩa giữa từ đoán và từ bí mật, lặp đến khi trúng hoặc hết lượt. Bài 8.3 phân tích một đề thi thật dạng này.
Embedding cho một cách dự đoán phản hồi: nếu từ bí mật là , đoán sẽ nhận score xấp xỉ . Chiến lược là giữ một tập ứng viên. Sau mỗi lượt, giữ lại những ứng viên có gần score nhận được, trong một sai số cho phép, vì embedding của judge có thể khác embedding công khai. Lượt tiếp theo chọn từ mà các ứng viên còn lại cho score khác nhau nhiều nhất, để một phản hồi loại được nhiều ứng viên nhất. Lịch sử từ đã đoán và score được giữ lại để không thử lại cùng một hướng.
Score không phải khoảng cách đường đi cộng được, và embedding là một phép đo đã học: nó có thể ưu tiên chủ đề hơn quan hệ logic. “Có học” và “không học” có thể gần nhau vì xuất hiện trong những ngữ cảnh giống nhau, dù trái nghĩa. Quan hệ logic giữa hai câu (kéo theo, mâu thuẫn, trung lập) là một nhiệm vụ riêng, natural language inference (NLI), học bằng nhãn trên từng cặp câu.
Hỏi nhanh
Còn ba ứng viên A, B, C cho từ bí mật. Score của judge lệch tối đa so với cosine tính theo embedding công khai. Mỗi phương án dưới đây là một từ có thể đoán, kèm cosine dự đoán với A, B và C. Đoán từ nào thì chỉ một lần phản hồi là chắc chắn còn lại đúng một ứng viên?
Với G3, ba khoảng , và tách rời nhau. Score nhận được rơi vào đúng một khoảng, và chỉ ra một ứng viên. G1 cho cùng score với cả ba, không loại được ai. G2 tách được C, nhưng A và B chỉ chênh 0.02, nằm trong sai số. G4 có vẻ hấp dẫn vì gần cả ba ứng viên, nhưng chính vì gần đều nên phản hồi của nó không phân biệt được ai.
Khi đi thi
- Dựng mốc TF-IDF trước: query trùng mã môn, tên riêng hay số hiệu thường được nó xếp đúng hơn embedding.
- Viết hàm chấm giống hệt đề: Recall@k hay MRR@k, bằng bao nhiêu.
- Mỗi query trong file nộp đủ ID gốc, không trùng, xếp theo score giảm dần.
Tóm tắt
- Embedding cho mỗi câu một vector cố định; không gian có ích hay không do mục tiêu huấn luyện quyết định.
- Cosine so hướng: chuẩn hóa L2 rồi lấy tích vô hướng. Vector 0 cần xử lý riêng.
- Mean pooling chỉ cộng token thật; hidden state ở padding không được coi là bằng 0.
- Model câu học từ cặp câu bằng contrastive loss với in-batch negatives; hard negative có ích khi chung chữ mà thật sự sai.
- Retrieval cần gold, metric thứ hạng, query độc lập và cách chia giống lúc chấm. Gần nghĩa không đồng nhất với quan hệ logic.
Kiểm tra cuối bài
Câu 1
vectors_arr có shape (N, 100), mỗi hàng là embedding của một từ. Cần một ma trận W có mọi hàng dài 1, không dùng np.linalg và không dùng vòng lặp. Dòng nào đúng?
sum(axis=1, keepdims=True) cho tổng bình phương của từng hàng, với shape (N, 1), nên phép chia broadcast theo hàng. Thiếu keepdims thì mảng (N,) được ghép với trục cuối có 100 phần tử. Code báo lỗi khi . Tệ hơn, khi nó chạy lặng lẽ và chia cột cho độ dài của hàng . axis=0 chuẩn hóa từng cột, không phải từng từ. Chia cho tổng bình phương mà không lấy căn thì hàng có độ dài .
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 5.4
Câu 2
Sau khi tính S = W @ W.T cho kho câu đã chuẩn hóa từng hàng, đội in vài phần tử ra để kiểm nhanh. Giá trị nào chứng tỏ pipeline có lỗi?
Khi các hàng dài 1, mỗi phần tử của S là cosine của hai câu, nên nằm trong theo bất đẳng thức Cauchy–Schwarz. 1.37 chỉ xuất hiện khi có hàng chưa được chuẩn hóa, chẳng hạn do chuẩn hóa nhầm trục. Cosine âm nghĩa là hai vector lệch nhau quá 90°, hoàn toàn hợp lệ. 1.0000001 trên đường chéo là sai số làm tròn của float32. 0 nghĩa là hai vector vuông góc.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 5.5
Câu 3
W có shape (N, 384), mỗi hàng là embedding đã chuẩn hóa của một câu. Không dùng toán tử @, dòng nào cho ma trận S chứa cosine giữa mọi cặp câu?
np.dot(W, W.T) nhân (N, 384) với (384, N) thành (N, N), với là cosine của câu và câu . np.dot(W.T, W) có shape (384, 384), tức so các chiều với nhau chứ không so các câu. W * W nhân từng phần tử, giữ shape (N, 384). (W * W).sum(axis=1) chỉ cho độ dài bình phương của từng hàng, tức đường chéo của S, toàn bằng 1.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 5.6–5.7
Câu 4
Snapshot của một model câu có file 1_Pooling/config.json ghi mean pooling. Một đội quen dùng BERT để phân loại nên lấy last_hidden_state[:, 0] làm vector câu. Recall@10 trên validation thấp bất thường. Nên sửa theo hướng nào?
Model được train để masked mean của các token, sau khi chuẩn hóa, nằm trong một không gian tốt cho tìm kiếm. Vector ở vị trí 0 không phải thứ loss đã tối ưu. Sửa pooling cho khớp cấu hình là bước rẻ và đúng nguyên nhân. Đề chấm Recall@10 thì tự trả về 50 kết quả cũng không đổi điểm. Fine-tune lại tốn thời gian mà vẫn bỏ qua lỗi gốc. Bỏ chuẩn hóa thì cosine thành tích vô hướng thô, lệch khỏi hàm score của model.
Câu 5
Đề chấm MRR@5. Mỗi query nộp 5 tài liệu, và query nào không có tài liệu đúng trong 5 tài liệu ấy thì được 0. Năm query có tài liệu đúng lần lượt ở hạng 2, hạng 1, không có trong danh sách, hạng 4 và hạng 1. Điểm là bao nhiêu?
. 0.688 là , tức bỏ query trượt khỏi mẫu số, làm hệ thống trông tốt hơn thực tế. 0.583 là coi query trượt nằm ở hạng 6 và cộng thêm , trong khi ngưỡng cắt @5 cho nó 0. 0.4 là Recall@1, vì hai trong năm query đúng ở hạng 1, không phải MRR.
Câu 6
Kho validation có 100 FAQ, và model A đạt MRR 0.93. Đội thêm 400 FAQ chung nhiều chữ với các FAQ cũ nhưng trả lời việc khác, giữ nguyên query và gold. MRR của A còn 0.71. Ta kết luận được gì?
Model không đổi. Kho có thêm hard negative, nên tài liệu đúng phải vượt qua nhiều đối thủ dễ nhầm hơn, và MRR giảm. Nếu lúc chấm kho lớn và có nhiều FAQ na ná nhau, 0.71 gần thực tế hơn 0.93. Điểm trên hai kho khác nhau không so được với nhau, nên các model phải được so trên cùng một kho. MRR vẫn đúng định nghĩa với kho bất kỳ kích thước nào.
Câu 7
Dữ liệu có 500 FAQ, mỗi FAQ có 8 cách hỏi do những người khác nhau viết. Đề chấm trên các FAQ mới, chưa có lúc train. Chia train và validation thế nào?
Lúc chấm, model gặp những FAQ chưa từng thấy. Validation phải có đúng tình huống ấy, nên mọi cách hỏi của một FAQ phải nằm cùng một phía, tức group split, chẳng hạn GroupKFold. Chia ngẫu nhiên hay phân tầng theo FAQ đều để FAQ của validation xuất hiện trong train qua các cách hỏi khác, nên điểm chỉ đo việc nhận lại. Chia theo độ dài làm đổi phân phối câu hỏi, mà không giải quyết chuyện FAQ lặp lại.
Câu 8
Đội train embedding bằng contrastive loss với nhiệt độ , còn đề chấm bằng MRR@10. Cần chọn trong bằng 5-fold cross-validation. Với mỗi , làm theo quy trình nào?
Loss khả vi dùng để train, còn metric thật của đề dùng để chọn, trên phần dữ liệu không dùng để train, lấy trung bình qua 5 fold. MRR chỉ đổi theo bậc khi thứ hạng đổi, nên gradient bằng 0 gần như ở khắp nơi, và không tối ưu thẳng được. chia mọi logit, nên giá trị loss ở các khác nhau không cùng thang đo. So loss, kể cả trên fold giữ lại, không trả lời được nào cho MRR cao hơn. Loss train còn thiên vị thêm, vì đo trên chính dữ liệu đã học.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q5(f)
Câu 9
Sáng nay trang hỏi đáp thêm 20 bài hướng dẫn mới, chưa ai mở. Hệ (1) gợi ý theo lịch sử bấm của người dùng, tức collaborative filtering. Hệ (2) gợi ý theo embedding nội dung bài, tức content filtering. Hệ nào đưa được bài mới vào gợi ý ngay?
Content filtering dùng thông tin đi kèm item, ở đây là nội dung bài, nên encode xong là so được với query hay với sở thích người dùng. Collaborative filtering chỉ học từ tương tác. Bài chưa ai mở thì chưa có dữ liệu nào để đặt nó vào không gian, gọi là cold start. Hai hệ có thể cùng xếp hạng bằng tích vô hướng, nhưng vector của bài mới bên hệ (1) chưa được học. Lượt bấm sẽ đến sau, nhưng hệ (2) không cần chờ.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q7.6
Câu 10
Hai câu “Hôm nay lớp học trực tiếp” và “Hôm nay lớp học trực tuyến” có cosine cao. Ta cần biết chúng có mâu thuẫn nhau hay không. Nên làm thế nào?
Hai câu chung gần hết chữ và cùng chủ đề, nên embedding đặt chúng gần nhau, dù nội dung loại trừ nhau. Quan hệ logic là nhãn của cặp câu, nên cần một model học đúng nhiệm vụ đó, tức NLI. Cosine là một điểm hình học, không phải xác suất. Tăng top- chỉ đổi số kết quả trả về. Một ngưỡng cosine vẫn chỉ đo độ gần, nên cặp mâu thuẫn mà gần nhau vẫn vượt ngưỡng.
Đọc thêm
- Jurafsky, Martin — Embeddings. Đọc để hiểu phân phối ngữ cảnh và các phép đo vector.
- Reimers, Gurevych — Sentence-BERT. Vì sao phải học embedding cho cặp câu thay vì mặc định raw BERT pooling là đủ.
- Model card — paraphrase-multilingual-MiniLM-L12-v2. Kiểm pooling, dimension, độ dài tối đa và license khi chuẩn bị asset.
- Sentence Transformers — Semantic search. Đọc cách encode query và corpus, cùng cách chọn score.
- D2L — Natural Language Inference. Nhiệm vụ gán quan hệ logic cho cặp câu, khác với độ gần của embedding.
Tải gói recipe của chương — gồm các module phụ và hướng dẫn chuẩn bị asset.