Phép XOR của hai bit không tách được bằng một đường thẳng: hai điểm (0, 0), (1, 1) cho 0 và hai điểm (0, 1), (1, 0) cho 1 nằm chéo nhau. Vì vậy model tuyến tính như logistic regression không học được XOR. MLP (multilayer perceptron) xếp nhiều lớp tuyến tính, xen giữa là một hàm phi tuyến gọi là activation, để các lớp đầu tạo ra đặc trưng mới cho lớp sau. Để huấn luyện MLP cần tính đạo hàm của loss theo trọng số ở mọi lớp; thuật toán làm việc đó là backpropagation, nội dung chính của bài.
Vì sao thêm một lớp?
Với đầu vào thuộc , XOR có nhãn 1 tại và nhãn 0 ở hai góc còn lại. Một đường thẳng không tách được hai cặp góc đối diện. Đây là giới hạn của kiến trúc: train lâu hơn cũng không chữa được.
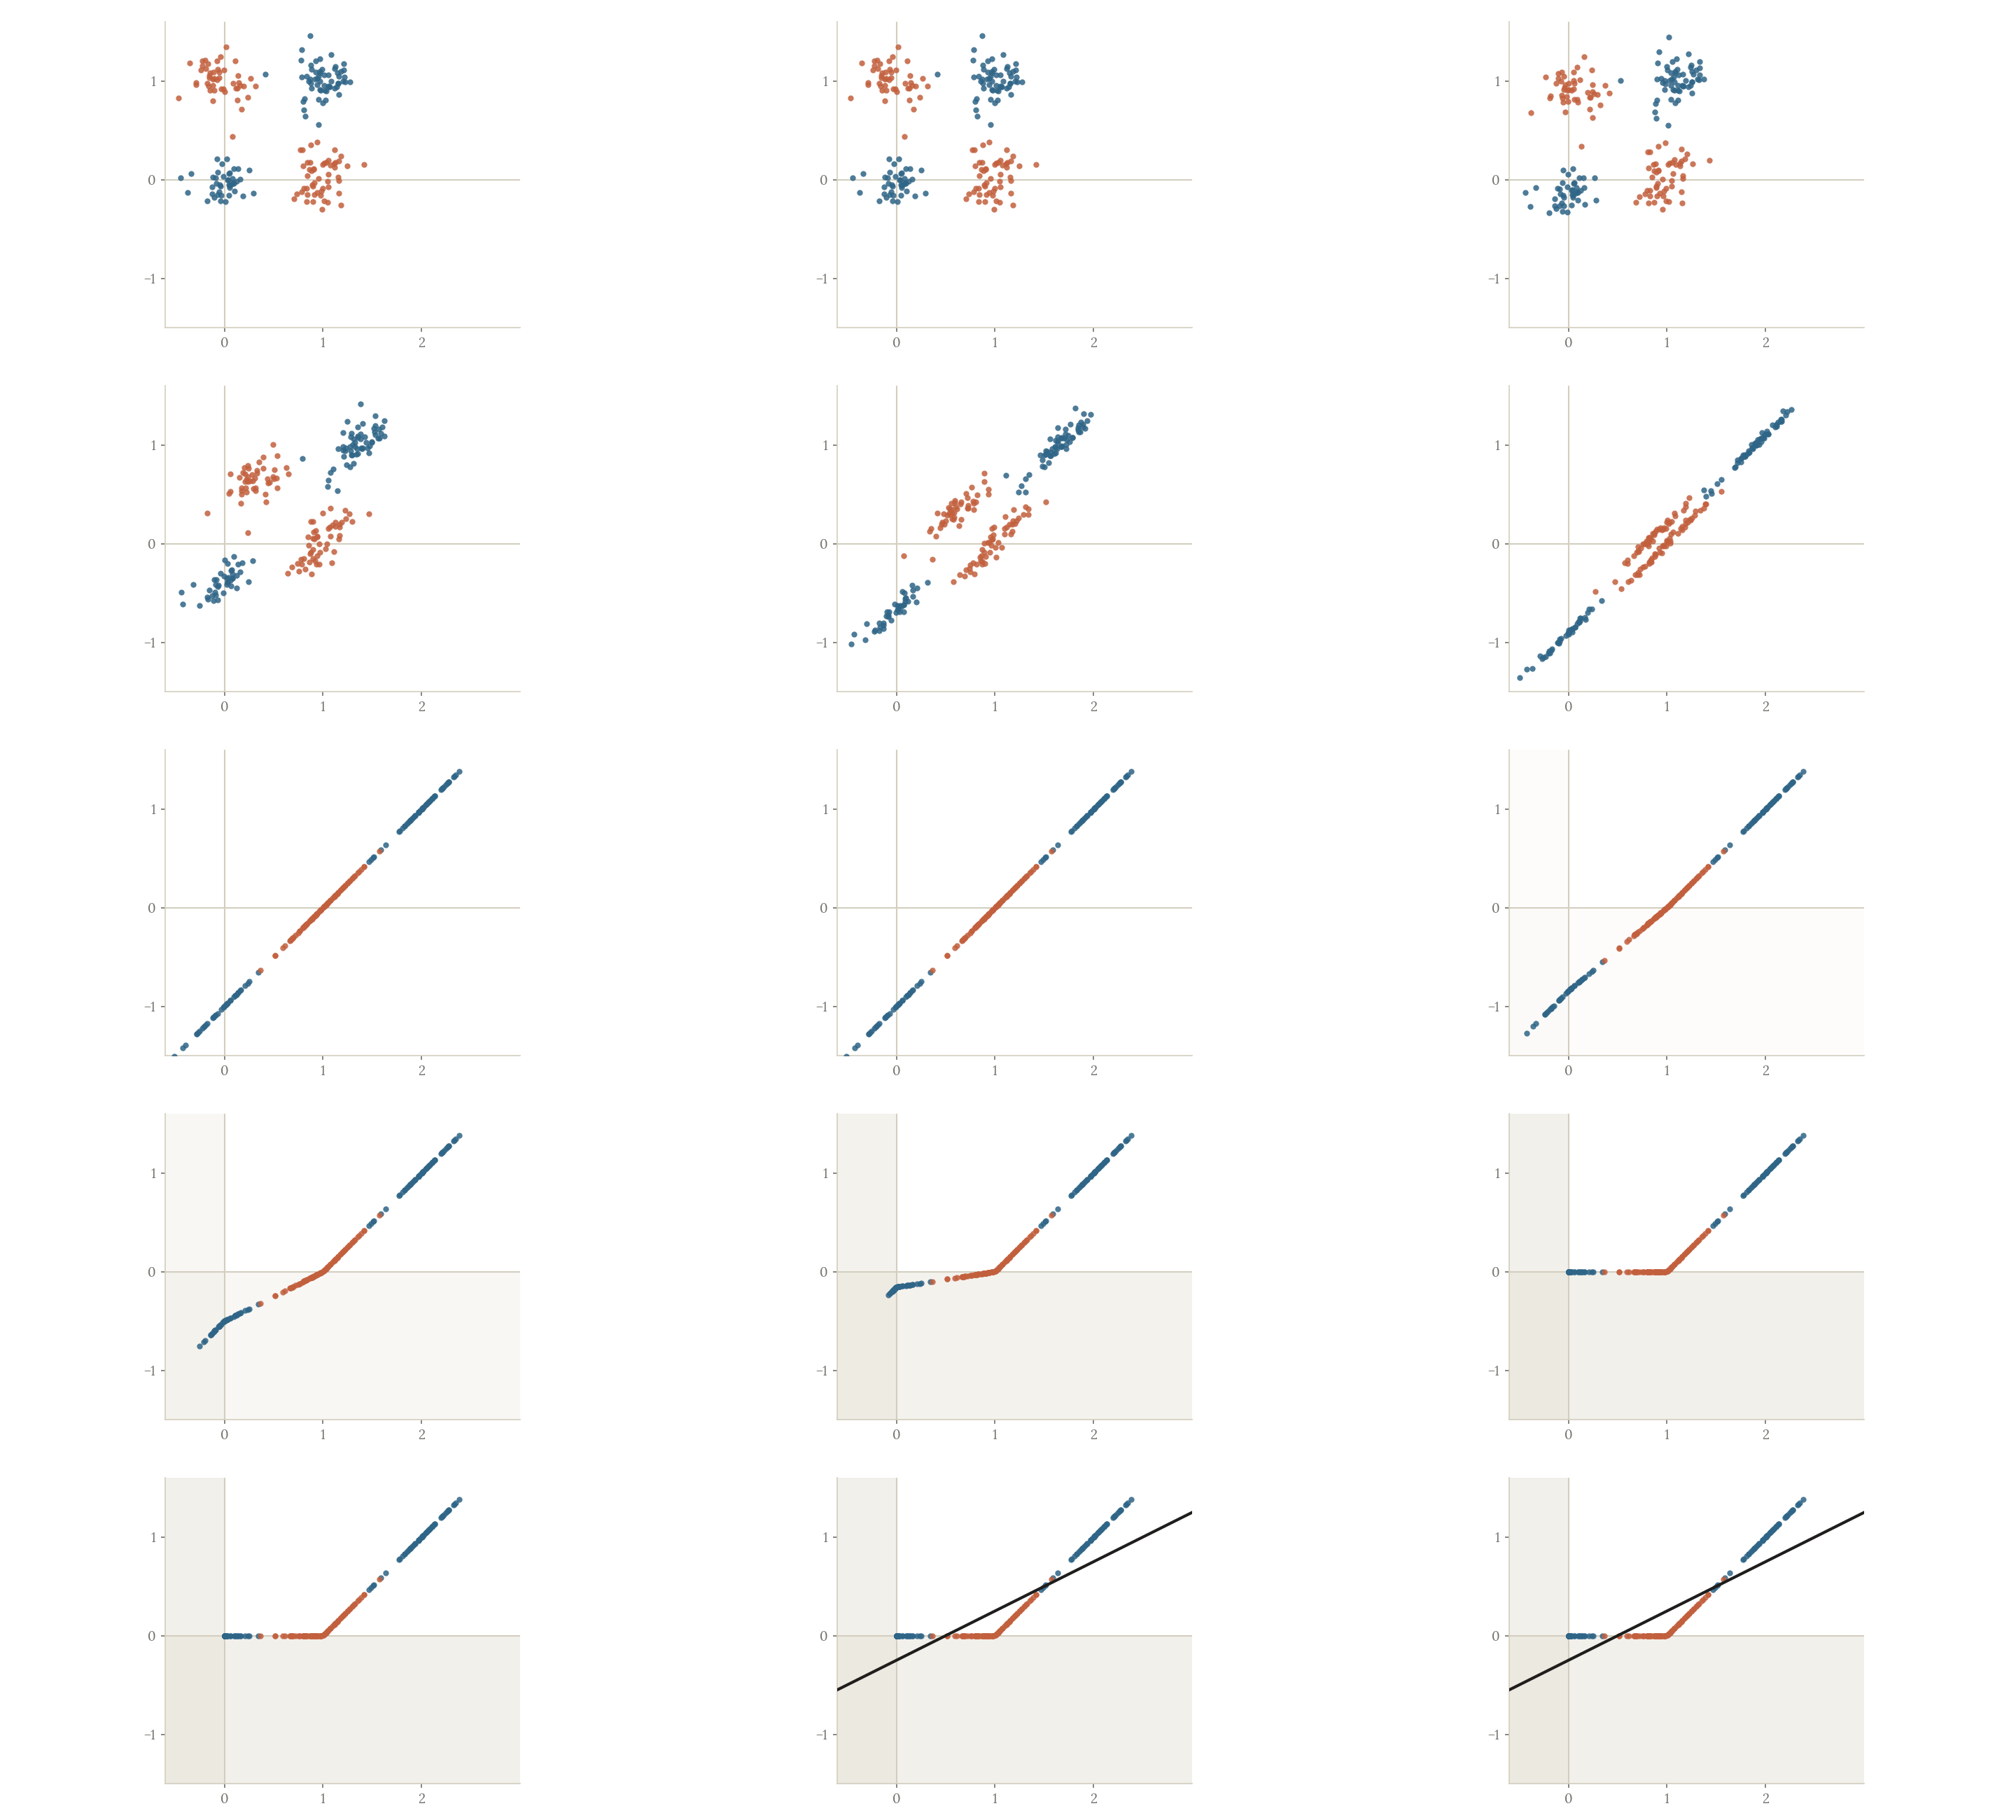
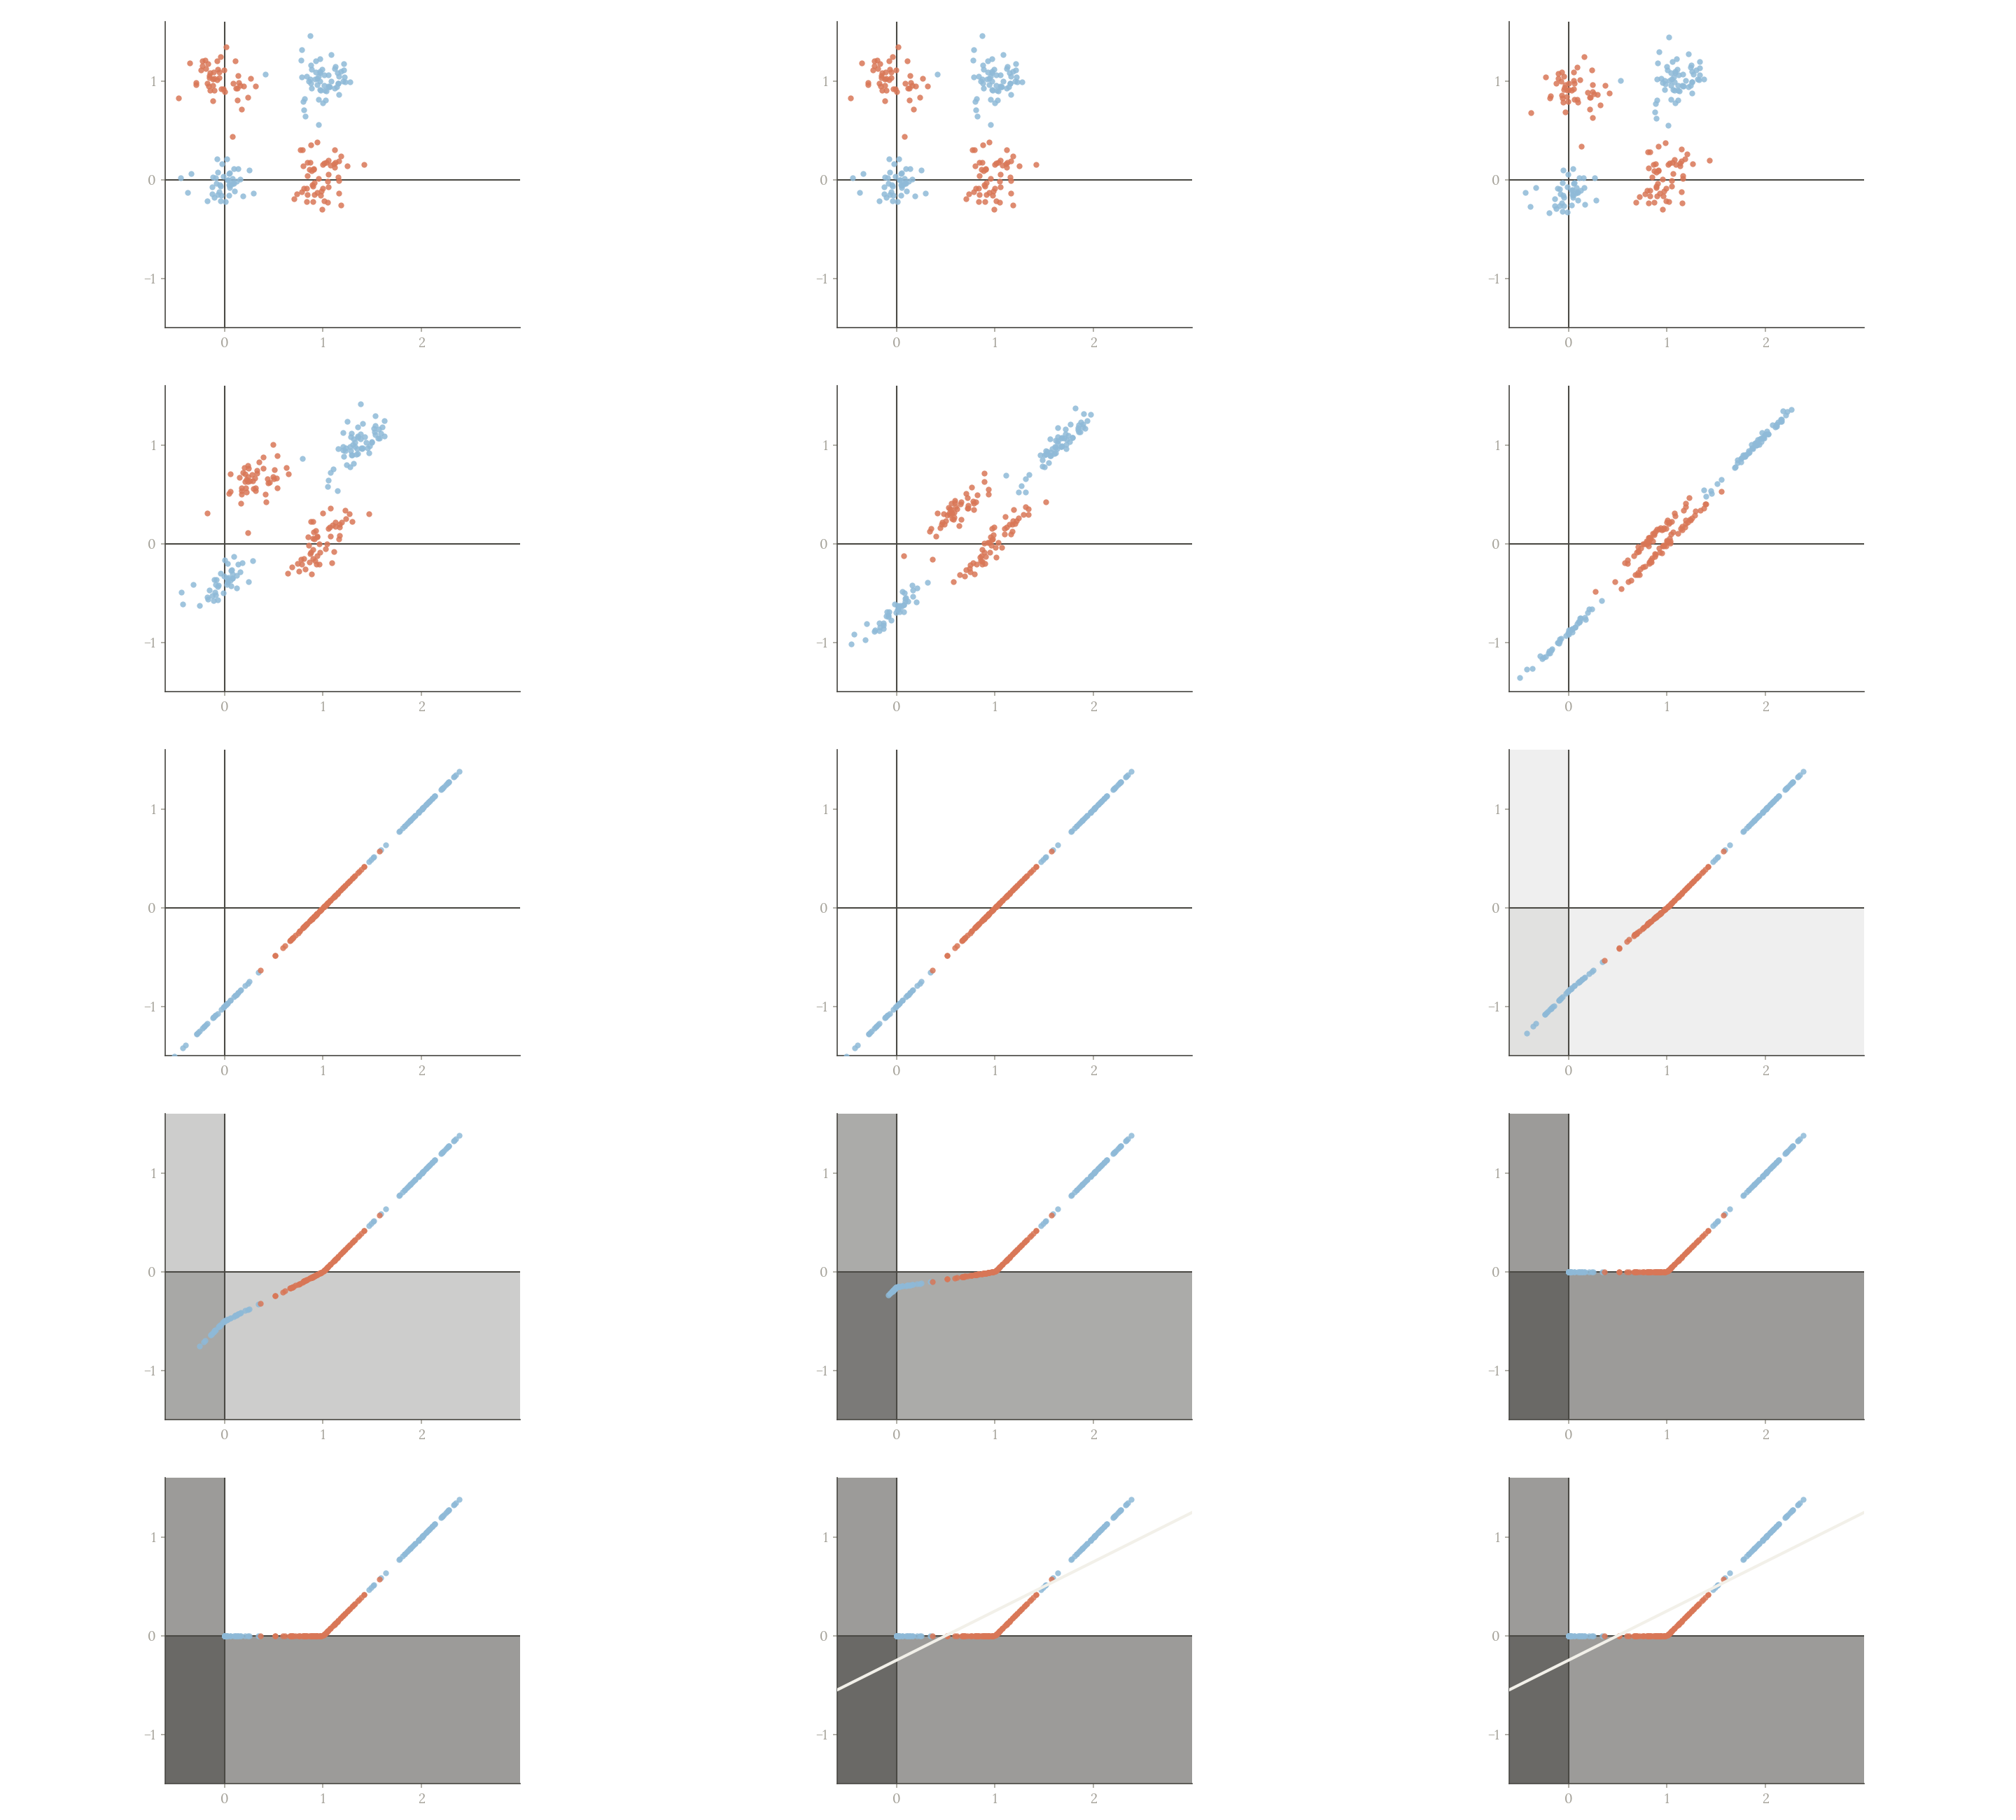
Tạo hai đặc trưng và , với . Khi tổng là 0, 1, 2, hai đặc trưng lần lượt là . Công thức cho 0, 1, 0, đúng XOR. Đây là một mạng được đặt trọng số bằng tay, chưa phải mạng đã học.
import numpy as np
import torch

torch.set_num_threads(1)
torch.manual_seed(11)
np.set_printoptions(precision=4, suppress=True)
X_xor = np.array([[0., 0.], [0., 1.], [1., 0.], [1., 1.]])
hidden = np.maximum(X_xor @ np.ones((2, 2)) + [0., -1.], 0.)
print(hidden)
print(hidden @ np.array([1., -2.]))
[[0. 0.]
[1. 0.]
[1. 0.]
[2. 1.]]
[0. 1. 1. 0.]
Dòng cuối cần cho 0, 1, 1, 0. Hidden layer đã biến bốn góc thành những vị trí mà lớp sau kết hợp được: hai góc cùng rơi vào điểm , còn góc bị đẩy ra .
Hỏi nhanh
Giữ nguyên hai đặc trưng , của mạng XOR đặt tay, chỉ đổi đầu ra thành . Với bốn đầu vào , , , , mạng cho ra hàm nào?
Khi tổng bằng 2 thì , nên . Hai tổng còn lại vẫn cho 0 và 1 như cũ. Lớp ẩn không đổi, chỉ cách lớp cuối trộn các đặc trưng thay đổi, mà mạng đã thành một hàm khác. AND cần cho ra 0. NAND cần cho ra 1. XOR cần hệ số để góc về 0.
Nếu bỏ activation, hai lớp gộp lại: , vẫn là một lớp linear. Thêm tham số mà không thêm phi tuyến không giải quyết được XOR.
Xếp nhiều lớp như vậy là được một mạng nơ-ron nhiều lớp (multilayer perceptron, MLP). Các lớp nằm giữa đầu vào và đầu ra gọi là lớp ẩn; nhiều lớp ẩn thì gọi là mạng sâu.
Một nơ-ron ngưỡng, ra 1 khi , tính được AND, OR hay NAND; ví dụ , cho NAND. Nhưng nó chỉ vẽ được một đường, nên XOR cần ít nhất hai nơ-ron ẩn. Cũng vậy, muốn biết một điểm có nằm trong tam giác không, dùng ba nơ-ron ẩn, mỗi cái kiểm một cạnh, rồi nơ-ron ra làm phép AND.
Đường thẳng trong mặt phẳng tách được mọi cách gán nhãn của 3 điểm không thẳng hàng, nhưng không với 4 điểm: bốn góc XOR là ví dụ, và bỏ đi một góc thì ba góc còn lại lại tách được.
Hỏi nhanh
Mạng gồm hai lớp linear nối thẳng, không có activation ở giữa. Mạng này biểu diễn được những hàm nào?
Tích là một ma trận , còn bias gộp lại thành một số, nên 100 neuron ẩn chỉ là tham số thừa. Khả năng biểu diễn hàm phức tạp đến từ phần phi tuyến ở giữa, không đến từ số neuron. Không có phi tuyến thì cũng chẳng có mức nào ở giữa một lớp linear và XOR.
Forward có bảng shape
Ta thống nhất mẫu nằm ở hàng. Một batch có shape (B, d), hidden width , đầu ra :
| Tên | Shape | Ý nghĩa |
|---|---|---|
(d, h), (h,) |
Tạo hidden feature | |
(B, h) |
Trước và sau activation | |
(h, c), (c,) |
Tạo đầu ra | |
(B, c) |
Dự đoán và target |
Trong NumPy ta dùng cách viết hàng như bảng này. torch.nn.Linear(d,h) lưu weight shape (h,d) và thực hiện . Hai quy ước cùng đúng; khi chuyển trọng số tự viết sang Linear, cần chuyển vị. Nếu copy thẳng ma trận vuông thì shape vẫn hợp lệ nhưng nội dung có thể sai.
Mỗi nơ-ron của lớp nối với mọi đầu vào của lớp trước, nên gọi là lớp kết nối đầy đủ (fully connected); nn.Linear(10, 3) là lớp 10 vào, 3 ra. Số trọng số giữa hai lớp bằng số vào nhân số ra, cộng thêm số ra nếu có bias: mạng không bias có trọng số.
Forward phải lưu cho backward, vì đạo hàm phụ thuộc chúng. Đó là nguồn chi phí activation memory: nhớ giá trị trung gian để khỏi tính lại. Backprop là thuật toán đi ngược các phép, còn autograd là cơ chế thư viện xây graph và gọi đạo hàm phù hợp.
Hỏi nhanh
Lớp đầu đã được cài bằng NumPy theo quy ước hàng, , với W1 có shape (3, 3). Chép thẳng W1 vào weight của torch.nn.Linear(3, 3) rồi chạy. Chuyện gì xảy ra?
Linear tính , nên gán weight = W1 sẽ cho ra . Ma trận vuông nên mọi phép nhân đều khớp shape và không có lỗi nào được báo. Phải gán W1.T. Chỉ khi ma trận không vuông thì phép nhân mới lệch shape và báo lỗi. PyTorch không đoán quy ước của người viết, và bias không liên quan đến chuyển vị.
Từ loss về lớp đầu
Để dễ kiểm, ta dùng hồi quy một đầu ra và . Bài 3.3 sẽ đổi sang loss phân loại. Đặt , shape (B,1). Với lớp linear cuối:
Đạo hàm theo hidden là . Khi có nhiều đầu ra, mỗi hidden neuron nối tới tất cả nên ảnh hưởng tới loss qua nhiều đường; chain rule cộng đóng góp của các đường ấy, và phép nhân ma trận làm sẵn phép cộng này.
Gradient theo cần . Đại lượng này phụ thuộc mọi lớp phía sau nên chỉ có khi backward đổ về; còn đạo hàm cục bộ của activation thì tính được ngay lúc forward.
Qua ReLU, phần có không đổi đầu ra khi xê dịch nhỏ nên gradient bằng 0; phần đi qua nguyên vẹn:
là nhân từng phần tử, không phải nhân ma trận. Vài hệ quả và quy ước:
- Tại đúng 0, ReLU không có đạo hàm; ta và PyTorch chọn gradient 0. Khi kiểm bằng sai phân, tránh đặt điểm đúng chỗ gãy ấy.
- Nếu loss lấy trung bình trên nhiều đầu ra , hệ số sẽ là ; công thức ở đây dùng .
- Gradient của trọng số nối đầu vào với nơ-ron bằng 0 khi hoặc khi nơ-ron đó đóng (), bất kể gradient đổ về là bao nhiêu.
- Với
nn.Linear, weight có shape (out, in) và , nên với .
Vì gradient của một nơ-ron đi qua chính trọng số của nó, nếu mọi trọng số của một lớp bằng nhau thì các nơ-ron trong lớp nhận cùng gradient và mãi giống nhau; khởi tạo ngẫu nhiên là để phá đối xứng ấy.
Hình dưới vẽ đường đi ấy cho mạng sẽ dựng bằng PyTorch ở mục dùng thư viện: gradient từ về , nhân để về , qua cổng ReLU′ rồi mới tới lớp đầu.
Hỏi nhanh
H có shape (5, 4), G2 có shape (5, 1). Gradient theo W2 có shape gì?
H.T @ G2 nhân (4, 5) với (5, 1), cộng đóng góp của năm mẫu lại thành (4, 1), đúng shape của . Gradient luôn có cùng shape với tham số. (1, 4) là G2.T @ H, tức chuyển vị của đáp án. (5, 4) là shape của chính . (5, 5) xuất hiện khi nhân theo chiều mẫu thay vì cộng qua các mẫu.
Tính thử trên một mẫu , , mạng một hidden neuron: . Forward có . Bắt đầu từ đầu ra: , nên và . Truyền về hidden cho ; ReLU đang mở vì , nên , .
Các gradient dùng trọng số trước cập nhật. Nếu sửa rồi mới tính gradient lớp đầu, đang trộn hai mạng khác nhau trong cùng lượt backward. Tính đủ gradient trước, cập nhật tất cả sau. Khi một neuron âm ở mọi mẫu, gradient qua ReLU của nó bằng 0; vấn đề này sẽ nối sang activation ở bài tiếp.
Hỏi nhanh
Mạng một mẫu có , , . Tại , , , , gradient bằng bao nhiêu?
Forward cho , . Đi ngược lại: , nhân , nhân đạo hàm ReLU bằng 1 vì , rồi nhân , được 12. Ra 6 là quên hệ số 2 của đạo hàm bình phương. Ra 4 là quên nhân . Ra 3 là chỉ giữ lại thừa số .
Cài nhỏ bằng NumPy
Ta kiểm trên hai mẫu, hai hidden neuron và điểm không nằm ở chỗ gãy. Tách forward/backward thành hàm để cùng một code phục vụ tính gradient và thử loss sau cập nhật:
X = np.array([[1., 2.], [2., -1.]])
Y = np.array([[1.], [0.]])
params = [np.array([[.2, -.3], [.4, .1]]), np.array([.1, .2]),
          np.array([[.5], [-.4]]), np.array([.05])]

def forward(params):
    W1, b1, W2, b2 = params
    Z1 = X @ W1 + b1
    H = np.maximum(Z1, 0)
    P = H @ W2 + b2
    return P, (Z1, H)

def objective(params):
    P, _ = forward(params)
    assert P.shape == Y.shape
    return np.mean((P - Y) ** 2)

def backward(params):
    P, (Z1, H) = forward(params)
    G2 = 2 * (P - Y) / len(X)
    G1 = (G2 @ params[2].T) * (Z1 > 0)
    return [X.T @ G1, G1.sum(axis=0), H.T @ G2, G2.sum(axis=0)]

print(forward(params)[0].ravel())
print(round(objective(params), 6))
for g in backward(params):
    print(g)
[0.56 0.1 ]
0.1018
[[-0.12 0.176]
[-0.49 0.352]]
[-0.17 0.176]
[[-0.474]
[-0.044]]
[-0.34]
Hai dự đoán là và , nên loss tính tay . Kiểm từng ma trận gradient cùng shape với trọng số tương ứng. Chẳng hạn hàng đầu bằng ; đây là tổng hai đường đóng góp qua hai mẫu. Ở batch này : neuron ẩn thứ hai đóng ở mẫu thứ hai, và mask (Z1 > 0) chặn gradient qua đúng ô đó.
Hỏi nhanh
Hàm backward ở trên bị quên * (Z1 > 0). Với của batch này, những gradient nào bị sai?
Mask chỉ có một số 0, ở mẫu 2, neuron 2. Bỏ mask thì đóng góp của ô ấy lọt vào cột hai của . Vì vậy cột hai của gradient và phần tử thứ hai của gradient bị sai. Chạy thử thì thấy , và , còn cột một không đổi. Gradient của , chỉ dùng và , không đi qua mask. Forward có cắt về 0, nhưng backward vẫn phải tự nhân đạo hàm của ReLU. Phép kiểm bằng sai phân ở mục sau sẽ bắt được lỗi này.
Đối chiếu độc lập rồi mới học
Sai phân trung tâm ước lượng đạo hàm theo một phần tử tham số bằng , giữ nguyên các phần tử khác. Mỗi phần tử tốn hai lần tính loss. Cách này chậm nhưng không dùng chung công thức nào với backward, giống lời giải brute force dùng để kiểm thuật toán tối ưu trong CP.
Ta dùng float64 và : sai số của sai phân trung tâm cỡ , sai số làm tròn của float64 còn nhỏ hơn, nên so với ngưỡng atol=1e-8 là đủ chặt. Với float32, sai số làm tròn bị khuếch đại khi chia cho , nên khi kiểm hãy chuyển mạng tí hon sang float64. Mọi phần tử của cách 0 ít nhất , xa hơn nhiều so với bước xê dịch, nên phép thử không vượt qua chỗ gãy của ReLU.
def numerical_gradient(params, eps=1e-5):
    answer = []
    for p in params:
        g = np.zeros_like(p)
        for index in np.ndindex(p.shape):
            old = p[index]
            p[index] = old + eps
            plus = objective(params)
            p[index] = old - eps
            minus = objective(params)
            p[index] = old
            g[index] = (plus - minus) / (2 * eps)
        answer.append(g)
    return answer

manual = backward(params)
numeric = numerical_gradient(params)
print('numeric match:', all(np.allclose(a, b, atol=1e-8)
                            for a, b in zip(manual, numeric)))

tp = [torch.tensor(p, dtype=torch.float64, requires_grad=True) for p in params]
tx, ty = torch.tensor(X), torch.tensor(Y)
pred = torch.relu(tx @ tp[0] + tp[1]) @ tp[2] + tp[3]
((pred - ty) ** 2).mean().backward()
print('autograd match:', all(np.allclose(g, p.grad.numpy(), atol=1e-10)
                            for g, p in zip(manual, tp)))
updated = [p - .05 * g for p, g in zip(params, manual)]
print(round(objective(params), 6), round(objective(updated), 6))
numeric match: True
autograd match: True
0.1018 0.065513
Hai dòng True nói backward khớp với hai cách tính độc lập tại bộ tham số đã chọn. Dòng cuối cho thấy một bước gradient descent với learning rate đưa loss từ xuống . Hai loại bằng chứng này không thay được nhau. Loss giảm sau một bước chỉ cần hướng cập nhật đi xuống, nên một backward sai ở vài phần tử vẫn có thể làm loss giảm. Ngược lại, gradient đúng không hứa hội tụ tới nghiệm toàn cục, vì loss của mạng neural thường không lồi.
Hỏi nhanh
Mạng nhỏ ở trên có 9 phần tử tham số. Kiểm bằng sai phân trung tâm thì phải tính objective bao nhiêu lần? Với một MLP có tham số thì sao?
có 4 phần tử, có 2, có 2, có 1, tổng là 9. Mỗi phần tử cần tính hai lần, với và , nên tổng là 18 lần. Ra 9 là quên rằng sai phân trung tâm cần cả hai phía. Backward cho cả vector gradient với chi phí cỡ một lần forward, nên sai phân chỉ dùng để kiểm trên mạng tí hon, không dùng để train. Hai lần tính chỉ cho đạo hàm theo một hướng. Xê dịch cả tensor một lúc cũng chỉ cho một hướng như thế, không tách được đạo hàm của từng phần tử.
Hỏi nhanh
Gradient tính bằng NumPy trùng với autograd và với sai phân trên một batch nhỏ. Điều đó bảo đảm được gì?
Phép kiểm so hai cách tính cùng một đạo hàm, tại một bộ tham số. Nó không nói gì về khả năng tổng quát hóa, vì việc ấy cần validation. Nó cũng không biến một loss không lồi thành lồi, và một bước giảm loss trên batch này không hứa gì cho batch khác. Muốn tin code hơn, hãy kiểm thêm vài bộ tham số ngẫu nhiên.
Dùng thư viện ở đúng tầng
Khi đã hiểu cơ chế, bài thực tế viết torch.nn.Sequential(torch.nn.Linear(d,h), torch.nn.ReLU(), torch.nn.Linear(h,c)) để thư viện quản lý tham số và autograd lo phần backward. Trước khi train, nên hỏi lại mô hình hai điều: output có shape như dự tính không, và mạng có bao nhiêu tham số:
model = torch.nn.Sequential(torch.nn.Linear(2, 3), torch.nn.ReLU(),
                            torch.nn.Linear(3, 1))
print(tuple(model(torch.zeros(4, 2)).shape))
print(sum(p.numel() for p in model.parameters()))
(4, 1)
13
Đầu ra (4,1) là bốn dự đoán. Số tham số là , tính cả hai bias; layer ReLU không có tham số học. Hai lỗi hay gặp khi tự viết model:
- Lớp con phải được gán làm thuộc tính của
nn.Modulehoặc đặt trongnn.ModuleList. Để trong list Python thường thìmodel.parameters()không thấy, optimizer không học và.to(device)cũng bỏ sót. - Dùng cùng một đối tượng lớp ở hai chỗ, như
nn.Sequential(l, nn.ReLU(), l), là chia sẻ trọng số:parameters()chỉ đếm một lần và gradient cộng từ cả hai chỗ.
Đầu ra và loss phải đi cùng nhau: phân loại nhị phân dùng một logit với BCEWithLogitsLoss, nhiều lớp loại trừ nhau dùng logits với CrossEntropyLoss (bài 3.3).
Hỏi nhanh
Mạng hồi quy trả về pred shape (4, 1), giá trị đúng bằng target y = torch.tensor([1., 2., 3., 4.]) có shape (4,). Thế nhưng torch.nn.MSELoss()(pred, y) lại cho thay vì . Vì sao?
Trừ (4, 1) cho (4,) ra ma trận (4, 4), với phần tử là . Loss là trung bình trên 16 cặp, trong đó 12 cặp là của hai mẫu khác nhau, nên ra . PyTorch chỉ cảnh báo chứ không báo lỗi. Sửa bằng y.view(-1, 1) hoặc pred.squeeze(1). Dòng assert P.shape == Y.shape trong objective ở trên có mặt chính để chặn lỗi này. Cộng thay vì trung bình thì vẫn ra 0 khi dự đoán đúng. Làm tròn không tạo ra sai lệch cỡ 2.5. Hai tensor vốn đã cùng kiểu float32.
Khi đi thi
- Cho mạng học thuộc vài chục mẫu trước. Loss không về gần 0 thì lỗi nằm ở code, chưa phải ở hyperparameter.
- Tự viết backward thì kiểm bằng sai phân trên mạng tí hon, dùng
float64. - Chép trọng số sang
nn.Linearthì nhớ chuyển vị, rồi so output hai bản trên vài mẫu.
Tóm tắt
- Lớp ẩn tạo đặc trưng mới; activation là phần phi tuyến, thiếu nó thì nhiều lớp vẫn chỉ là một lớp linear.
- Backprop đi ngược graph, nhân độ nhạy cục bộ và cộng các nhánh. Qua ReLU, gradient bị chặn ở các ô âm.
- Gradient có cùng shape với tham số; tính đủ mọi gradient rồi mới cập nhật.
- Kiểm backward bằng sai phân và autograd trên mạng tí hon trước khi train thật.
Kiểm tra cuối bài
Câu 1
Đề yêu cầu dựng một MLP chỉ gồm lớp linear và hàm ngưỡng nếu , ngược lại bằng 0. Trọng số đặt tay, không huấn luyện. Đầu ra phải bằng 1 khi điểm nằm trong tam giác có đỉnh , , , tính cả cạnh. Lớp ẩn có , , . Chọn neuron đầu ra.
Mỗi neuron ẩn bật trên một nửa mặt phẳng chứa tam giác, với biên là đường thẳng qua một cạnh. Chẳng hạn đường đi qua và , còn đỉnh cho . Tam giác là giao của ba nửa mặt phẳng, nên đầu ra cần phép AND, tức tổng phải bằng 3. Ngưỡng nhận cả điểm , nằm ngoài tam giác nhưng chỉ vi phạm một cạnh. Ngưỡng luôn cho 1, vì không điểm nào nằm ngoài cả ba nửa mặt phẳng. cũng luôn bằng 1, vì tổng không vượt quá 3. Hàm ngưỡng có đạo hàm bằng 0 gần như khắp nơi, nên backprop không học được mạng này, và trọng số phải đặt tay.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 7.4
Câu 2
Mạng không có bias. , . Từ tách ra hai nhánh: , và , . Cuối cùng , . Đặt . Biểu thức nào là ?
ảnh hưởng tới loss qua hai đường: và . Chain rule nhiều biến cộng đóng góp của các đường lại. Chỉ lấy một nhánh là quên đường thứ hai. Nhân hai nhánh với nhau là nhầm “đi song song” với “đi nối tiếp”. Bỏ là coi activation như hàm đồng nhất. Từ đây có .
Phỏng theoCMU 10-601 · Exam 2 Practice · Q4.4
Câu 3
Với lin = torch.nn.Linear(2, 3), lin.weight và lin.bias có shape gì?
PyTorch lưu weight theo thứ tự (số đầu ra, số đầu vào), và tính . Bias có một số cho mỗi đầu ra. (2, 3) là shape của theo quy ước hàng trong bài, nên khi chép sang phải chuyển vị. Bias (2,) là nhầm số đầu vào với số đầu ra.
Câu 4
Ảnh xám được duỗi thành vector, rồi đưa qua MLP , cả hai lớp đều có bias. Mạng có bao nhiêu tham số?
Lớp đầu có tham số, lớp sau có , tổng là 101770. Ra 100480 là chỉ đếm lớp đầu. Ra 101632 là bỏ cả hai bias. Ra 101760 là quên bias của lớp cuối. Gần như mọi tham số nằm ở lớp nối với đầu vào lớn, nên tăng độ phân giải ảnh thì lớp đầu phình ra nhanh nhất.
Câu 5
Mạng một đầu vào: , , , , . Loss là cross-entropy nhị phân, nên . Ở một mẫu có , , với , . Gradient theo hai bias của lớp ẩn thế nào?
Chuỗi đạo hàm cho là , trong đó vì . Neuron 2 đang đóng, nên mẫu này không đẩy . Với , ReLU mở vì , , và vì nằm hẳn trong . Phương án cả hai khác 0 là quên cổng ReLU. Phương án ngược lại là nhầm neuron nào đóng. Phương án cả hai bằng 0 là tưởng một neuron đóng thì chặn gradient của cả lớp.
Phỏng theoCMU 10-601 · Exam 2 Practice · Q4.2(d)
Câu 6
Mạng một lớp ẩn: , , với là sigmoid. Đầu ra trước activation là . Loss được cộng thêm số hạng phạt cho từng mẫu. Đạo hàm của số hạng phạt này theo là gì?
Đi ngược lại: , , , . Phương án có là đi thêm qua sigmoid ở đầu ra, trong khi số hạng phạt đặt thẳng lên trước activation, nên chuỗi dừng ở . Hai phương án ngắn bỏ qua lớp ẩn hoặc cổng sigmoid. Khác với phạt có đạo hàm , số hạng này phụ thuộc dữ liệu thông qua .
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q2(a)
Câu 7
Loss MSE lấy trung bình trên mẫu và đầu ra, như mặc định của nn.MSELoss. Đạo hàm theo mỗi phần tử của bằng phần dư nhân với hệ số nào?
Lấy trung bình là chia cho cả phần tử, còn đạo hàm của bình phương mang hệ số 2. Hệ số trong bài là trường hợp . Giữ nguyên nó khi chuyển sang nhiều đầu ra sẽ làm gradient lớn gấp lần, giống như ngầm tăng learning rate. là quên hệ số 2. là nhân thay vì chia.
Câu 8
Hai mẫu cùng dùng một trọng số . Đạo hàm của loss từng mẫu theo là và . Loss của batch là trung bình hai loss. Gradient theo bằng bao nhiêu?
Đạo hàm của trung bình bằng trung bình của các đạo hàm: . Ra 4 là cộng mà quên chia. Ra là nhân hai gradient với nhau. Ra là chỉ giữ lại mẫu cuối.
Câu 9
Forward đã dùng W2 cũ. Trong backward tự viết, code cập nhật W2 trước rồi mới tính G1 = G2 @ W2.T. Sửa lỗi này thế nào?
G1 phải dùng đúng W2 của lần forward đã sinh ra loss, thì mới là đạo hàm của loss ấy. Đổi thứ tự cập nhật vẫn là trộn hai mạng khác nhau. Chỉnh learning rate không lấy lại được hướng gradient đúng. Tính lại loss cũng không sửa được G1 đã sai.
Câu 10
Mạng một đầu vào, hai neuron ẩn sigmoid, đầu ra linear: . Khởi tạo hai neuron giống hệt nhau, tức , , , rồi chạy batch gradient descent với MSE. Chuyện gì xảy ra?
Hai neuron nhận cùng đầu vào, có cùng tham số và cùng trọng số ra, nên backprop cho chúng gradient giống hệt nhau, và sau mỗi bước chúng vẫn bằng nhau. Mạng chỉ biểu diễn được , đúng lớp hàm của một neuron. Gradient nói chung khác 0, nên trọng số vẫn thay đổi. Phép tính tất định không sinh ra nhiễu để tách hai neuron, và cũng chẳng có lý do để một neuron được ưu tiên. Khởi tạo ngẫu nhiên cho mỗi neuron một điểm xuất phát riêng, nên gradient khác nhau ngay từ bước đầu, và thế đối xứng bị phá.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q4(h)
Đọc thêm
- D2L — Backpropagation: theo dõi các biến trung gian và quy tắc chuỗi trong mạng nhiều lớp.
- Goodfellow, Bengio, Courville — Deep Learning, chương 6: đọc về feedforward network, khả năng biểu diễn và graph tính toán.
- PyTorch 2.9 — Linear: kiểm quy ước weight và shape trước khi chuyển mô hình tự cài sang thư viện.