Đưa ảnh vào MLP phải trải mọi điểm ảnh thành một vector dài. Cách đó có hai vấn đề: số trọng số tăng rất nhanh khi ảnh lớn, và một nét ở góc trái với cùng nét ấy ở giữa ảnh được học như hai thứ khác nhau. Convolution dùng một bộ lọc nhỏ, ví dụ 3×3, trượt qua mọi vị trí của ảnh với cùng một bộ trọng số. Bài này học convolution, padding, stride và pooling trên ví dụ dò nét dọc, nét ngang tính được bằng tay.
Một bộ dò đi qua nhiều vị trí
Ảnh xám là bảng số . Mỗi ô của bảng gọi là một điểm ảnh (pixel), mang một số từ 0 (đen) tới 255 (trắng). Ảnh xám có một kênh; ảnh màu có ba bảng như vậy, gọi là ba kênh RGB.
Các điểm cạnh nhau có quan hệ: cạnh của viên phấn thường kéo dài qua nhiều ô lân cận. Vì vậy ta đọc một cửa sổ nhỏ trước khi đọc cả ảnh.
Kernel (bộ lọc) là bảng trọng số . Tại mỗi vị trí, nhân từng ô trong cửa sổ với ô tương ứng của , rồi cộng. Với một kênh, stride 1, chưa có padding và bias:
chỉ vị trí trên bảng kết quả; chỉ vị trí bên trong kernel. Tổng ở đây là tích vô hướng của hai bảng khi trải thành vector. Nếu đã học linear regression, ta đang dùng một mô hình tuyến tính nhỏ trên từng cửa sổ, và mọi cửa sổ dùng chung trọng số.
Trong toán học, convolution lật kernel trước khi nhân; phép nhân thẳng không lật gọi là cross-correlation. Conv2d của PyTorch làm cross-correlation, nhưng ngành học sâu vẫn gọi nó là convolution.
Khi kernel được học, khác biệt này không quan trọng: mạng sẽ học luôn bản đã lật. Nó chỉ quan trọng khi đề cho sẵn kernel và hỏi kết quả; khi đó tính theo cách không lật như PyTorch.
Dùng chung trọng số còn quyết định số tham số. Nếu mỗi vị trí đầu ra có kernel riêng, một ảnh xám cho đầu ra cần 784 bộ trọng số; dùng chung thì chỉ một bộ, và bộ ấy học từ mọi vị trí cùng lúc. So với nối thẳng mọi pixel vào lớp kết nối đầy đủ, khác biệt rất lớn: ảnh vào 1000 neuron đã cần khoảng 150 triệu trọng số.
Hỏi nhanh
Hàng ảnh [0, 0, 5, 5] có một cạnh chuyển từ tối sang sáng. Kernel [-1, 1], stride 1, không padding. Conv2d của PyTorch cho ra kết quả nào?
Cửa sổ thứ hai là [0, 5], nhân thẳng với [-1, 1] được 5: kernel này cho số dương ở cạnh tối sang sáng. [0, -5, 0] là kết quả khi lật kernel thành [1, -1] như convolution trong toán. [0, 0, 5] là gán kết quả vào ô bên phải của cửa sổ, trong khi ô đầu ra thứ ứng với cửa sổ bắt đầu ở . Không có padding thì đầu ra ngắn hơn đầu vào một ô, nên không thể có bốn số.
Hỏi nhanh
Ảnh xám , kernel , không padding, stride 1, đầu ra . Nếu mỗi vị trí đầu ra có một kernel riêng thay vì dùng chung, lớp này cần bao nhiêu trọng số, bỏ qua bias?
Có vị trí đầu ra, mỗi vị trí một kernel 9 số, nên cần trọng số. Lớp convolution thường chỉ cần 9. 3844 là đếm vị trí mà quên mỗi kernel có 9 số. 36 864 là đếm theo vị trí đầu vào, trong khi mỗi kernel gắn với một vị trí đầu ra.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.4(a)
Lấy ảnh và kernel sau. Chưa cần ảnh thật: bảng số nhỏ giúp nhìn mọi phép nhân.
import numpy as np

image = np.array([[1, 2, 0],
                  [0, 1, 3],
                  [2, 1, 0]], dtype=float)
kernel = np.array([[1, 0],
                   [0, 2]], dtype=float)

def correlate_valid(image, kernel):
    height, width = image.shape
    kh, kw = kernel.shape
    result = np.zeros((height - kh + 1, width - kw + 1))
    for row in range(result.shape[0]):
        for col in range(result.shape[1]):
            window = image[row:row + kh, col:col + kw]
            result[row, col] = np.sum(window * kernel)
    return result

feature_map = correlate_valid(image, kernel)
print(feature_map)
[[3. 8.]
[2. 1.]]
Ô trên trái là . Ô trên phải là . Hai ô hàng dưới lần lượt là 2 và 1. Bảng đầu ra nhỏ hơn vì kernel phải nằm trọn trong ảnh.
Kernel này được đặt tay cho dễ tính, nhưng đã cho thấy cách một bộ dò hoạt động: nó chỉ có trọng số dương trên đường chéo chính, nên cửa sổ có số lớn trên đường chéo ấy, , cho giá trị lớn nhất là 8. Trong CNN, giá trị kernel không đặt tay mà được học từ dữ liệu. Vài kernel cổ điển vẫn đáng nhớ:
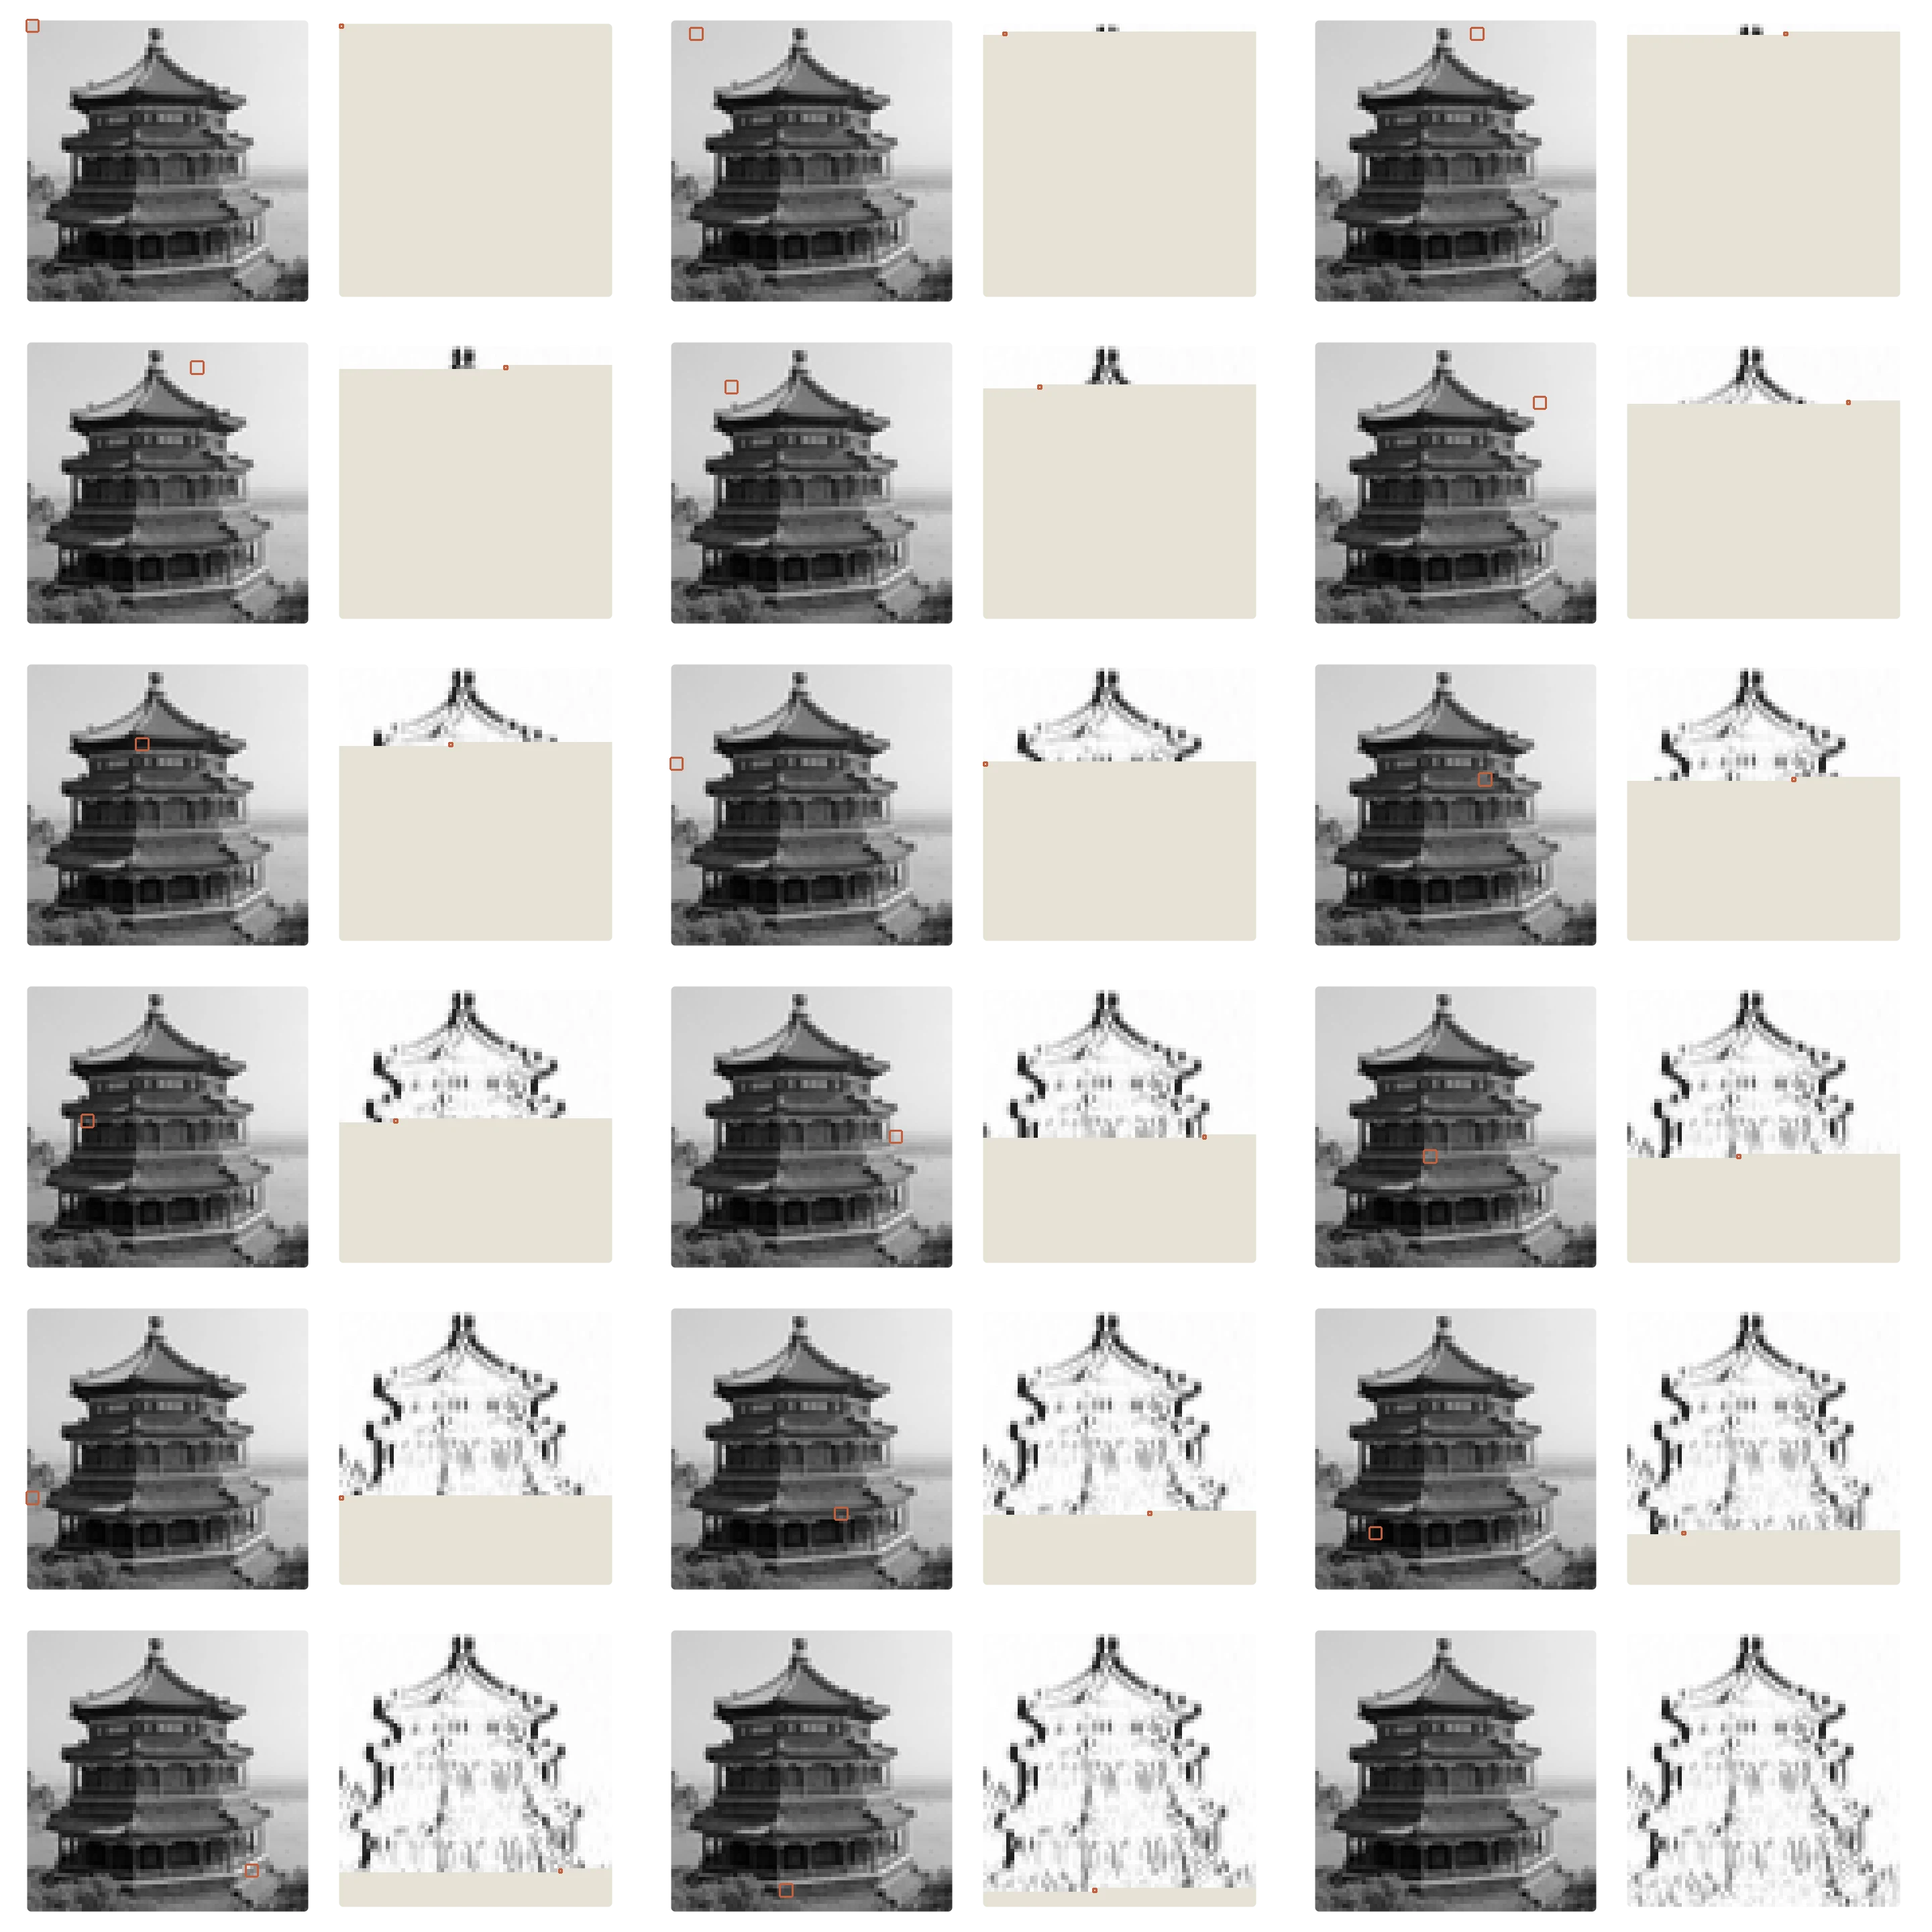
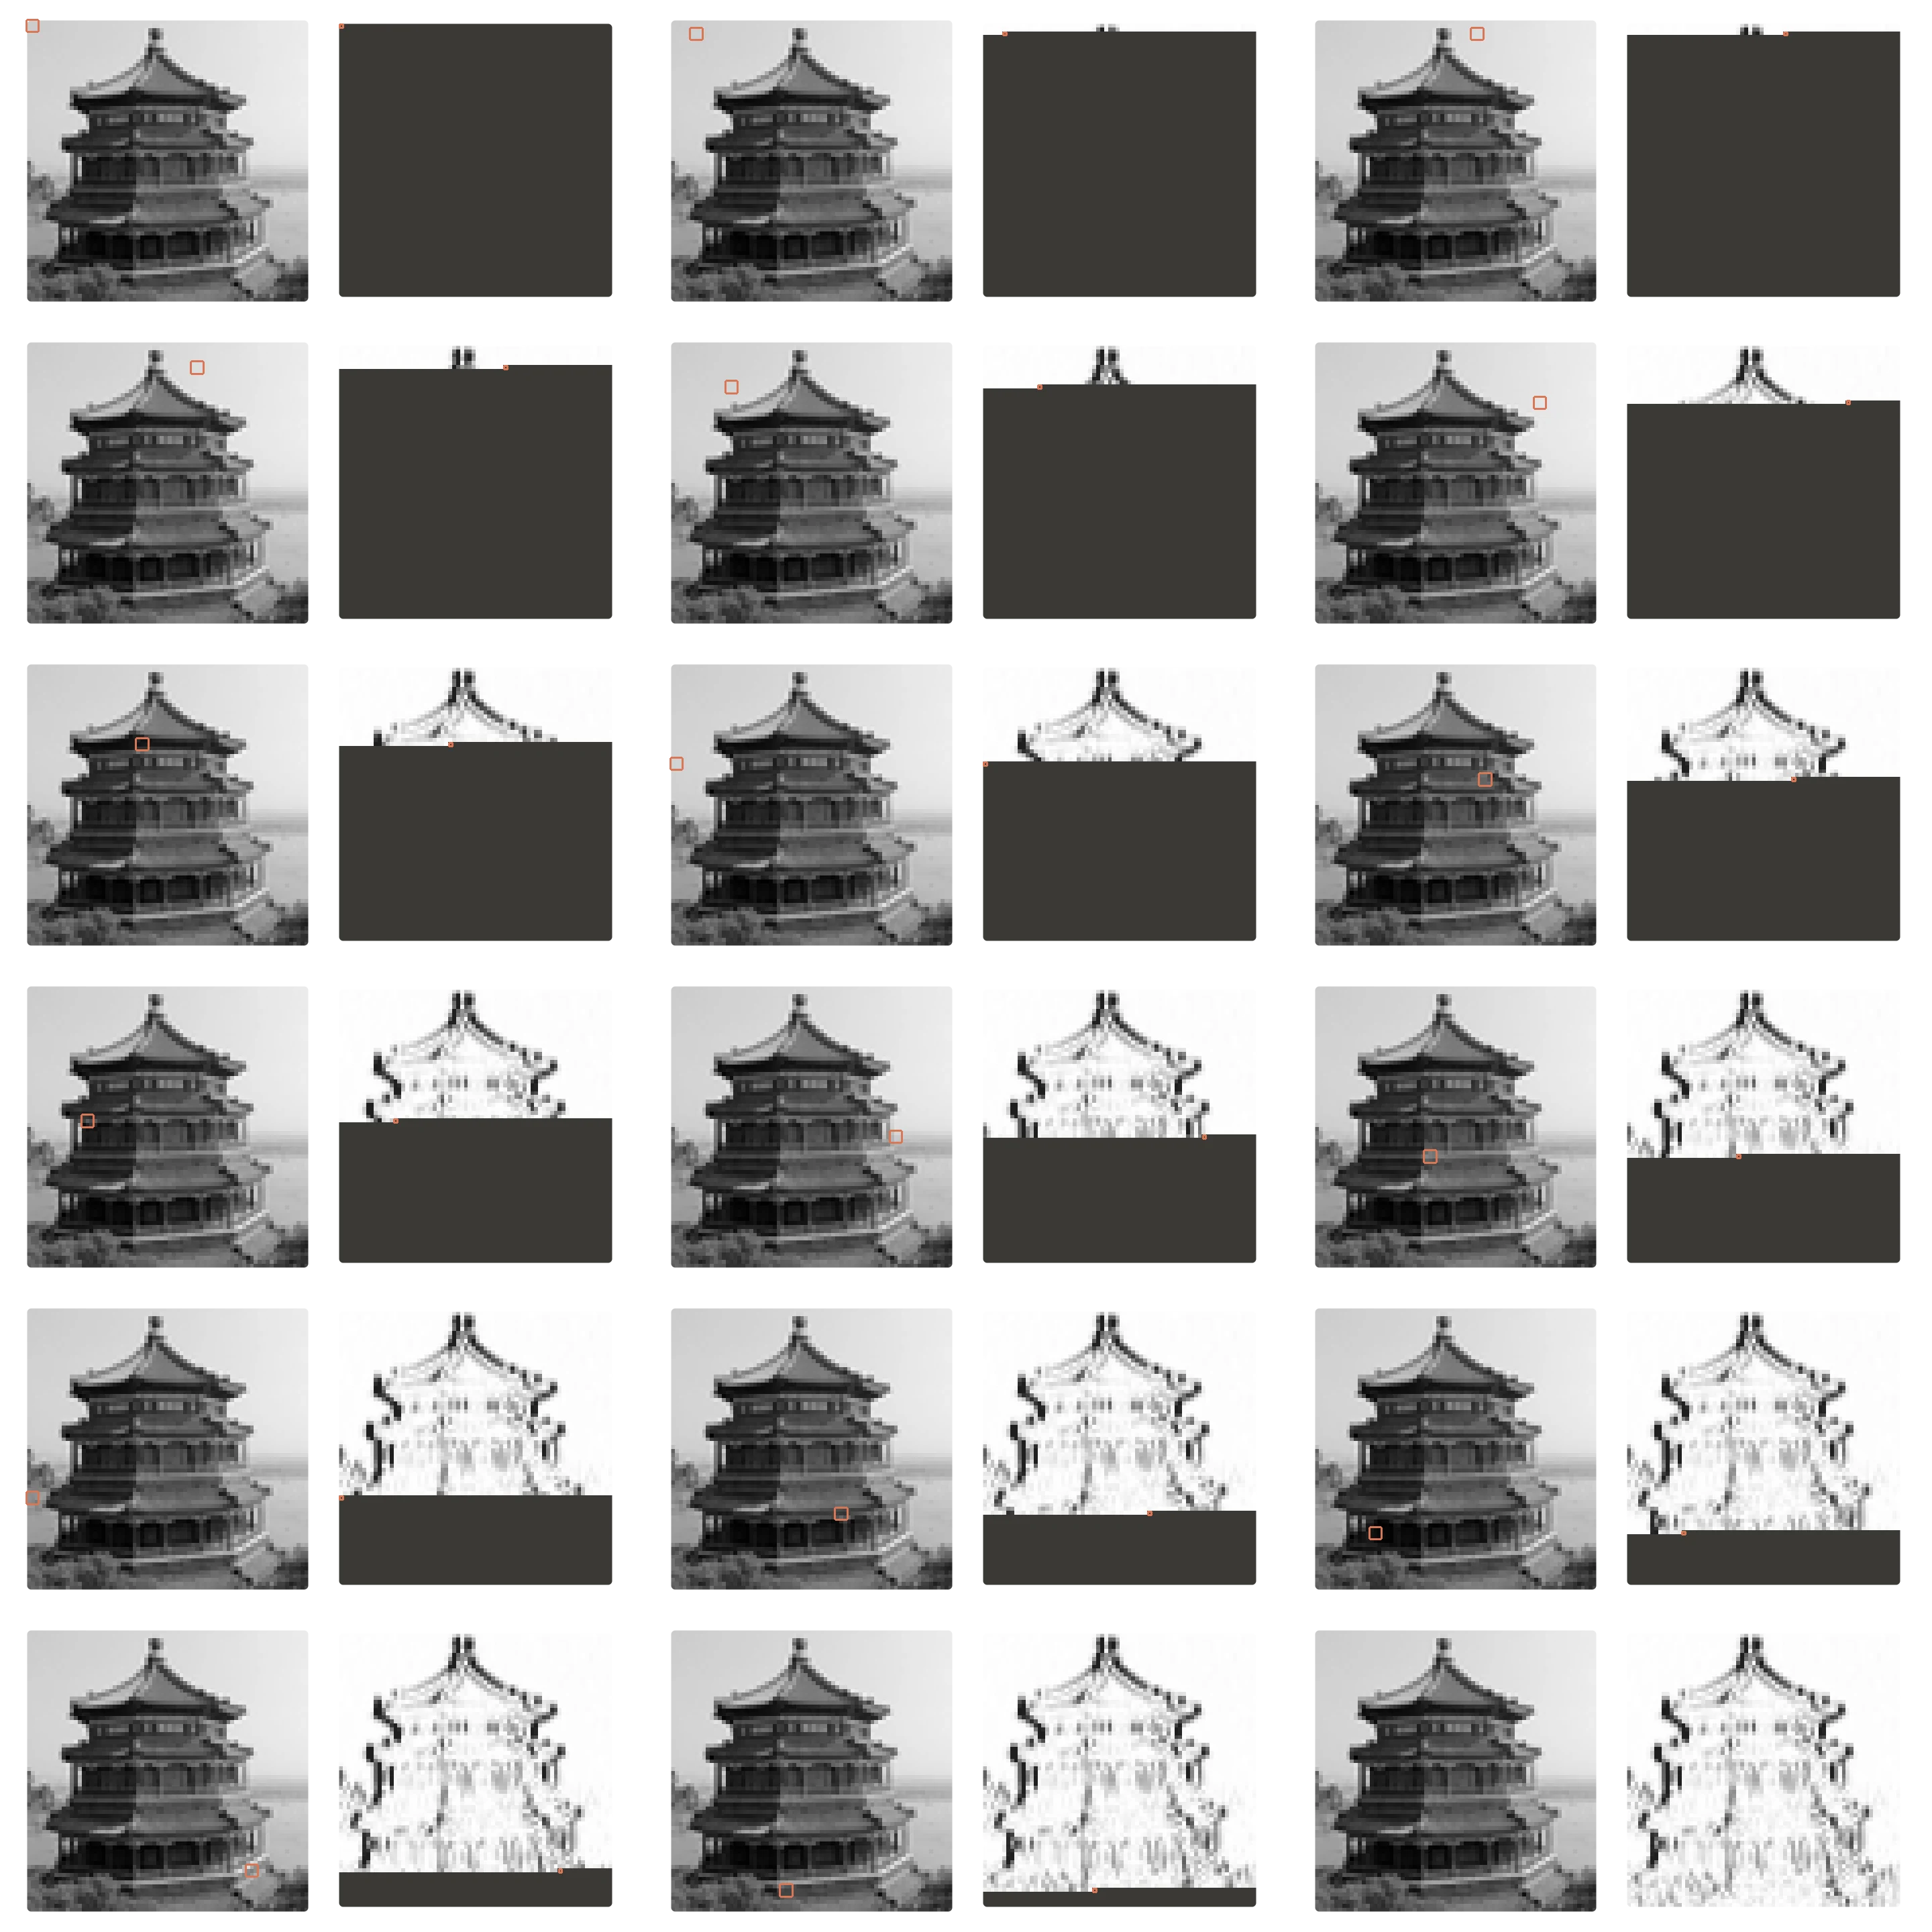
- Sobel phản ứng mạnh ở cạnh dọc, nơi độ sáng đổi đột ngột theo chiều ngang. Tìm những chỗ như vậy gọi là phát hiện cạnh.
- Làm mờ : 9 ô đều bằng , tổng bằng 1 để giữ nguyên độ sáng trung bình.
Hỏi nhanh
Ta muốn một kernel cho số dương với cửa sổ nét chéo , nhưng cho 0 với mọi vùng nền đều màu . Chọn kernel nào?
Kernel đúng cho với nét chéo, và cho với nền đều, vì tổng các trọng số bằng 0. Kernel giống hệt nét chéo cũng cho 2, nhưng với nền đều lại cho , nên vùng sáng trông như có nét. Kernel chéo phụ cho 0 với chính nét cần tìm. Kernel toàn 1 chỉ đo tổng độ sáng, nên phản ứng mạnh nhất với nền.
Không phải bộ lọc cổ điển nào cũng là tổng có trọng số. Trên ảnh nhị phân, nền là 0 và vật là 1, phép giãn và phép co thay nhân–cộng bằng max và min trên cửa sổ . Giãn đặt ô ra bằng 1 nếu cửa sổ có ít nhất một ô 1, nên nét dày lên và lấp được khe nhỏ. Co chỉ đặt ô ra bằng 1 khi cả cửa sổ đều là 1, nên nét mỏng đi và chấm nhiễu nhỏ biến mất. Co rồi giãn (opening) xóa chấm nhiễu mà vật lớn gần như giữ nguyên; giãn rồi co (closing) lấp khe. Phép giãn (morphological dilation) này khác dilation của convolution ở mục sau.
def morph(img, op):
    padded = np.pad(img, 1)
    out = np.zeros_like(img)
    for i in range(img.shape[0]):
        for j in range(img.shape[1]):
            out[i, j] = op(padded[i:i + 3, j:j + 3])
    return out

mask = np.zeros((7, 7), dtype=int)
mask[1, 1] = 1                  # một chấm nhiễu
mask[3:6, 3:6] = 1              # một vật 3 × 3
dilated, eroded = morph(mask, np.max), morph(mask, np.min)
opened = morph(eroded, np.max)
print("Số ô bằng 1: gốc", mask.sum(), " giãn", dilated.sum(),
      " co", eroded.sum(), " co rồi giãn", opened.sum())
print("Chấm nhiễu sau co rồi giãn:", opened[1, 1])
Số ô bằng 1: gốc 10 giãn 33 co 1 co rồi giãn 9
Chấm nhiễu sau co rồi giãn: 0
Giãn biến chấm nhiễu thành 9 ô và vật thành ; hai vùng chạm nhau ở một ô nên tổng là . Co xóa chấm nhiễu và chỉ để lại ô giữa của vật. Giãn lại từ đó cho đúng vật ban đầu, còn chấm nhiễu không quay lại.
Padding, stride và dilation thay đổi điều gì?
Padding thêm vành ô quanh ảnh, thường bằng 0. Nó cho kernel đọc cả vùng sát biên và có thể giữ kích thước. Giá trị 0 ở biên là một giả định về bên ngoài ảnh; với ảnh nhỏ, giả định này có ảnh hưởng đáng kể.
Stride là số ô dịch mỗi bước. Stride 2 đọc thưa hơn, giảm chi phí nhưng có thể bỏ sót nét mảnh.
Dilation tạo khoảng trống giữa các ô kernel: kernel 3 ô với dilation 2 bao phủ 5 vị trí, dù vẫn chỉ có 3 trọng số theo chiều đó. Kích thước bao phủ hiệu dụng là .
Ta đếm số vị trí hợp lệ theo một chiều. Chiều dài sau padding là ; cửa sổ đầu chiếm ô, phần còn lại cho phép dịch từng ô:
Chiều rộng tính tương tự. Công thức giả định mỗi đầu thêm đúng ô. Với stride 1, muốn giữ kích thước thì cần ; padding="same" của PyTorch tự chọn padding như vậy, và khi lẻ (kernel chẵn) phần dư được thêm ở cuối.
Ví dụ , , , , cho . Các vị trí bắt đầu là 0, 2, 4, 6 trên ảnh đã thêm vành, không phải làm tròn tùy ý.
Vài trường hợp hay gặp: ảnh , kernel 5, không padding ra ; giữ với kernel 3 cần ; kernel 3 với dilation 2 trên 32 ô ra 28.
def output_size(size, kernel_size, padding=0, stride=1, dilation=1):
    covered = dilation * (kernel_size - 1) + 1
    return (size + 2 * padding - covered) // stride + 1

print(output_size(7, 3, padding=1, stride=2))
print(output_size(7, 3, dilation=2))
4
3
Dòng thứ hai có dilation 2, nên kernel phủ 5 ô, còn 3 vị trí hợp lệ trên chiều dài 7. Tăng dilation không tăng số tham số của kernel nhưng đổi những điểm ảnh được đọc.
Xếp chồng nhiều lớp cùng dilation 2 thì có những pixel không bao giờ được đọc, để lại lưới lỗ; đổi dilation giữa các lớp hoặc ghép nhiều dilation song song, như ASPP trong DeepLab, vừa lấp lỗ vừa nhìn ngữ cảnh ở nhiều cỡ. Tăng stride từ 1 lên 2 giữ nguyên số tham số nhưng đầu ra còn khoảng một phần tư số ô.
Hỏi nhanh
Ảnh dài 8 ô, kernel 3, padding 0, stride 2, dilation 1. Đầu ra dài bao nhiêu?
Công thức cho : các vị trí bắt đầu là 0, 2, 4. Bắt đầu ở 6 thì kernel cần ô 6, 7, 8, vượt ra ngoài biên. Ra 4 là lấy , quên phần kernel chiếm chỗ. Ra 6 là kết quả của stride 1. Ra 2 là , quên cộng 1 cho vị trí đầu tiên.
Hỏi nhanh
Conv có kernel 3, dilation 2, stride 1. Padding đối xứng bằng bao nhiêu thì giữ nguyên chiều dài đầu vào?
Kernel phủ ô, nên cần , tức . Padding 1 là con số quen thuộc của kernel 3 thường, quên rằng dilation làm vùng phủ giãn ra. Padding 3 là lấy nửa của 5 rồi làm tròn lên, nên đầu ra dài thêm 2 ô. Padding 4 là đặt cả 4 ô thiếu vào mỗi đầu, nên đầu ra dài thêm 4 ô.
Từ một bảng sang nhiều kênh
Một ảnh RGB có ba giá trị tại mỗi tọa độ. Một kernel cho một kênh đầu ra phải đọc cả ba kênh đầu vào, cộng kết quả rồi cộng một bias. Muốn tám kiểu bộ dò thì dùng tám kernel độc lập.
| Đại lượng | Shape theo PyTorch |
|---|---|
| Batch ảnh | (N, C_in, H, W) |
| Trọng số convolution thông thường | (C_out, C_in, k_h, k_w) |
| Bias | (C_out,) |
| Feature map | (N, C_out, H_out, W_out) |
là số ảnh, không phải số kênh. Với groups=1, số tham số có bias bằng . Một lớp RGB → 8 kênh, kernel có tham số, dù ảnh lớn hay nhỏ. Chi phí tính vẫn tăng theo số vị trí đầu ra; ít tham số không có nghĩa là chạy miễn phí.
Tương tự, nn.Conv2d(3, 16, 3) có tham số, nn.Conv2d(3, 64, 3) có , và nn.Conv2d(3, 16, kernel_size=5).weight có shape (16, 3, 5, 5).
Kernel không nhìn hàng xóm mà chỉ trộn kênh tại từng vị trí: khối qua 64 bộ lọc thành . Tích chập theo chiều sâu (depthwise, groups bằng số kênh) làm ngược lại: mỗi kênh một kernel riêng, trộn không gian trong từng kênh mà không trộn giữa các kênh; ghép depthwise với là khối quen thuộc của MobileNet, ConvNeXt.
Đối chiếu bảng tính tay với thư viện trước, rồi xem shape của một lớp nhiều kênh:
import torch
from torch import nn

torch.set_num_threads(1)
x = torch.tensor(image, dtype=torch.float32)[None, None]
layer = nn.Conv2d(1, 1, kernel_size=2, bias=False)
with torch.no_grad():
    layer.weight.copy_(torch.tensor(kernel, dtype=torch.float32)[None, None])
    y = layer(x)
print(tuple(y.shape))
print(np.allclose(y[0, 0].numpy(), feature_map))

rgb_layer = nn.Conv2d(3, 8, 3, padding=1)
print(sum(parameter.numel() for parameter in rgb_layer.parameters()))
print(tuple(rgb_layer(torch.zeros(2, 3, 7, 7)).shape))
(1, 1, 2, 2)
True
224
(2, 8, 7, 7)
True xác nhận ta và thư viện dùng cùng quy ước. Shape cuối giữ vì kernel 3, padding 1, stride 1. Hai ảnh cùng chạy qua tám bộ lọc, nên đầu ra có hai ảnh, tám kênh.
Hỏi nhanh
nn.Conv2d(16, 32, kernel_size=(3, 5)) có weight.shape là gì?
Trục đầu là số kernel, tức . Mỗi kernel đọc đủ 16 kênh vào, cao 3, rộng 5. (16, 32, 3, 5) là chép theo thứ tự đối số của hàm, nhưng trọng số lưu kênh ra trước, kênh vào sau, giống nn.Linear. (32, 3, 5) là quên rằng mỗi kernel đọc mọi kênh vào. (32, 16, 5, 3) là đảo chiều cao và chiều rộng, vì kernel_size=(3, 5) theo thứ tự .
Hỏi nhanh
Lớp nn.Conv2d(3, 8, 3, padding=1) chạy trên ảnh , rồi chạy trên ảnh . Số tham số và số phép nhân thay đổi thế nào?
Số tham số chỉ phụ thuộc vào , và . Padding 1 giữ nguyên kích thước, và mỗi ô đầu ra của mỗi kênh cần phép nhân. Vậy số phép nhân là , rồi , gấp 100 lần vì số vị trí tăng theo bình phương cạnh. Nghĩ “ít tham số thì chạy rẻ” thì sẽ chọn phép nhân giữ nguyên. Tính theo cạnh ảnh thay vì diện tích thì ra hệ số 10.
Pooling giữ điều gì, mất điều gì?
Sau khi biết một vùng có nét, đôi khi ta không cần vị trí chính xác từng ô. Pooling gộp mỗi cửa sổ thành một số, và không có trọng số cần học:
- Max pooling lấy giá trị lớn nhất trong cửa sổ; average pooling lấy trung bình. Trên feature map , max pooling ra 8, average pooling ra .
- Global pooling: cửa sổ phủ cả feature map, mỗi kênh chỉ còn một số. Global max trả lời “mẫu có xuất hiện ở đâu đó không”; global average đo mẫu phủ nhiều hay ít.
MaxPool2d(2) trên ra vì hàng, cột lẻ cuối bị bỏ; ceil_mode=True giữ cửa sổ thiếu nên ra . Thay pooling bằng tích chập stride 2 cũng thu nhỏ map, nhưng cách gộp được học thay vì cố định.
print(nn.MaxPool2d(2)(y).flatten().tolist())
print(nn.AvgPool2d(2)(y).flatten().tolist())
left = torch.tensor([[[[0., 4., 0., 0.]]]])
right = torch.tensor([[[[0., 0., 4., 0.]]]])
pool = nn.MaxPool2d((1, 2))
print(pool(left).flatten().tolist())
print(pool(right).flatten().tolist())

window = y.detach().clone().requires_grad_(True)
nn.MaxPool2d(2)(window).sum().backward()
print(window.grad[0, 0].tolist())
[8.0]
[3.5]
[4.0, 0.0]
[0.0, 4.0]
[[0.0, 1.0], [0.0, 0.0]]
Dòng ba và bốn cho thấy dịch một ô có thể đưa đỉnh sang cửa sổ khác. Pooling có thể giảm nhạy với dịch nhỏ bên trong cùng cửa sổ, nhưng không tạo bất biến dịch tuyệt đối. Với segmentation, làm mất vị trí như vậy còn phải được bù bằng decoder hoặc nhánh giữ chi tiết.
Dòng cuối là gradient khi lan truyền ngược qua max pooling. Chỉ ô đạt max (ô chứa 8) nhận gradient 1, ba ô kia nhận 0: trong bước học này, chỉ ô thắng truyền tín hiệu về các lớp trước. Average pooling thì chia đều, mỗi ô nhận . Khi các cửa sổ chồng nhau, một ô có thể thuộc nhiều cửa sổ và gradient của các cửa sổ ấy được cộng lại.
Hỏi nhanh
Max pooling trên một cửa sổ chỉ trả về số 8. Từ đó có khôi phục duy nhất được bốn ô ban đầu không?
Giảm kích thước thì mất thông tin. Chia 8 cho 4 là nhầm max với tổng. Stride chỉ cho biết các cửa sổ nằm ở đâu, không cho biết những giá trị đã bị bỏ. Biết thêm trung bình là 3.5 thì ba ô còn lại có tổng bằng 6, vẫn có vô số cách chia.
Hỏi nhanh
MaxPool1d(kernel_size=2, stride=1) trên [1, 9, 3] cho ra [9, 9]. Lấy tổng đầu ra rồi gọi backward(). Gradient về đầu vào là gì?
Ô 9 thắng ở cả hai cửa sổ chồng lên nhau, mỗi cửa sổ gửi về gradient 1, nên tổng là 2. Ô 1 và ô 3 không thắng cửa sổ nào. [0, 1, 0] là quên cộng gradient của hai cửa sổ. [0.5, 1, 0.5] là gradient của average pooling với cùng cấu hình. [0, 9, 0] là nhầm giá trị được chọn với gradient.
Receptive field: một ô đã nhìn xa đến đâu?
Vùng tiếp nhận (receptive field) là vùng đầu vào có thể ảnh hưởng đến một ô ở lớp đang xét. Hai kernel stride 1 cho vùng , vì ba ô cạnh nhau ở lớp thứ nhất có các vùng nhìn chồng lấn. Đây là vùng có thể ảnh hưởng theo cấu trúc; trọng số hoặc ReLU có thể làm ảnh hưởng thực tế nhỏ hơn.
Để tính chuỗi lớp, giữ hai số: là chiều dài vùng nhìn và là khoảng cách trên ảnh gốc giữa hai ô đầu ra kề nhau. Bắt đầu , . Với lớp kernel , dilation , stride , cập nhật:
Một conv 3, pool 2 stride 2, rồi conv 3 cho , . Conv cuối đọc ba ô cách nhau hai ô trên ảnh gốc, nên thêm 4 vào vùng nhìn. Công thức đo độ rộng; muốn biết vị trí chính xác ở biên còn phải theo dõi padding. Ba lớp stride 1 cho ; nếu lớp đầu có stride 2 thì thành 2 và ba lớp cho . Kernel không làm vùng nhìn rộng thêm.
Xếp chồng kernel nhỏ là cách thường dùng để mở vùng nhìn. Hai lớp nhìn như một lớp , nhưng mỗi cặp kênh vào–ra chỉ cần trọng số thay vì 25, và có thêm một activation ở giữa. Vì thế các họ mạng như VGG, ResNet chủ yếu dùng kernel .
Vùng nhìn lớn dần cũng giải thích vì sao feature map khác nhau theo độ sâu. Lớp đầu chỉ nhìn vài pixel nên phản ứng với cạnh, nét, chỗ đổi màu; feature map của nó còn giống ảnh gốc đã qua bộ lọc. Sau vài lần stride hoặc pooling, mỗi ô nhìn một vùng rộng, map nhỏ và thô đi, phản ứng với tổ hợp lớn hơn như góc, vân, bộ phận của vật. Cấu trúc cho phép thứ bậc ấy xuất hiện; chính huấn luyện mới tạo ra nó.
Hỏi nhanh
Một conv kernel 3 stride 2, tiếp theo là một conv kernel 3 stride 1, cả hai có dilation 1. Một ô ở lớp thứ hai nhìn bao nhiêu ô đầu vào theo mỗi chiều?
Lớp đầu cho , . Lớp thứ hai thêm , nên . Ra 5 là bỏ qua stride, như hai conv stride 1. Ra 6 là cộng , quên rằng hai cửa sổ liền nhau dùng chung ô. Ra 9 là nhân , như thể vùng nhìn nhân lên qua từng lớp.
Giả định và ứng dụng
Convolution giả định các mẫu cục bộ hữu ích và cùng mẫu có thể xuất hiện ở nhiều vị trí. Điều này hợp với cạnh, góc, vân; chưa đủ để tự hiểu quan hệ “quyển sách bên trái cửa sổ”. Ta cần nhiều lớp để ghép chi tiết thành cấu trúc, hoặc cơ chế khác để trao đổi thông tin xa như attention ở bài 5.4.
Với stride 1, dịch ảnh đi một ô thì feature map dịch theo đúng một ô, các giá trị giữ nguyên trừ vùng sát biên. Tính chất này gọi là đồng biến với phép dịch (translation equivariance).
Bất biến, tức đầu ra không đổi khi ảnh dịch, chỉ xuất hiện khi về sau có phép gộp vị trí như global pooling; pooling cục bộ chỉ giảm nhạy với dịch nhỏ và vỡ khi đỉnh qua ranh giới cửa sổ, như cặp [4.0, 0.0] và [0.0, 4.0] ở trên. CNN cũng không tự bất biến với xoay, đổi tỉ lệ hay đổi ánh sáng.
Giả định “mẫu có thể ở bất kỳ đâu” yếu đi khi ảnh đã được căn chỉnh, ví dụ ảnh thẻ mà mắt luôn ở cùng một chỗ. Ngược lại, khi đề cần tọa độ tuyệt đối như vị trí một nguồn hay một keypoint, global pooling xóa đúng thông tin cần tìm; head phải đọc feature map còn chiều không gian, hoặc input được thêm hai kênh chứa tọa độ của từng ô.
Quay lại nét phấn: bộ dò cục bộ giúp tái sử dụng tri thức khi nét dịch chỗ. Ta vẫn phải kiểm ảnh của nhiều học sinh, nhiều camera, nhiều độ sáng. Nếu dữ liệu train chỉ có nét ở giữa ảnh, bộ lọc dùng chung chưa bảo đảm classifier cuối không học thói quen “nét luôn ở giữa”.
Chia sẻ trọng số là một giả định: bớt tham số nên giảm variance, đổi lại thêm bias khi giả định sai. Lớp kết nối đầy đủ cùng số đơn vị vào, ra biểu diễn được mọi thứ tích chập làm được, chỉ cần nhiều dữ liệu hơn hẳn để học; khi ảnh đã căn chỉnh sẵn, vật luôn cùng cỡ và cùng chỗ, lợi thế của tích chập nhỏ đi.
Hỏi nhanh
Một bộ dò nét đã học tốt trên những ảnh chỉ có nét dựng đứng, ở đủ mọi vị trí. Ảnh test bị xoay nên nét thành nằm ngang. Nhiều khả năng chuyện gì xảy ra?
Dùng chung kernel chỉ giúp khi mẫu dịch chỗ. Xoay thì làm đổi chính mẫu cục bộ mà kernel đang so. Muốn bền với phép xoay, cần dữ liệu hoặc augmentation có xoay (bài 5.3). Ảnh vuông xoay vẫn giữ nguyên shape. Padding chỉ thêm một vành quanh ảnh, không đổi được hướng của nét.
Khi đi thi
- Đưa một batch giả
torch.zeros(2, C, H, W)qua model và in shape từng khối trước khi nạp dữ liệu thật. - Dữ liệu dạng
(H, W, C)thìpermutevề(N, C, H, W), rồi so giá trị một pixel trước và sau. - Đề cần tọa độ hay mask thì giữ chiều không gian, đừng global pooling.
Tóm tắt
- Convolution đọc cửa sổ cục bộ bằng trọng số dùng chung: số tham số không phụ thuộc kích thước ảnh, còn chi phí tính thì có.
- Kernel cổ điển như Sobel, làm mờ được đặt tay; giãn và co lấy max, min trên cửa sổ để làm dày, làm mỏng vật trên ảnh nhị phân.
- Padding, stride và dilation quyết định vị trí đọc và kích thước đầu ra: .
- Pooling gộp cửa sổ mà không học trọng số; max pooling chỉ gửi gradient về ô thắng.
- Receptive field tăng qua nhiều lớp; xếp chồng mở vùng nhìn với ít trọng số.
- Convolution đồng biến với phép dịch, nhưng không tự bất biến với xoay hay đổi tỉ lệ.
Kiểm tra cuối bài
Câu 1
Ảnh đi qua 5 lớp conv stride 1 nối tiếp nhau. Kích thước cuối cùng khi không có padding, và khi mọi lớp có padding=1, lần lượt là bao nhiêu?
Không có padding, mỗi lớp mất ô ở mỗi chiều: . Padding 1 thêm một vành vừa đủ bù lại 2 ô ấy, nên giữ nguyên 28. Trừ 1 mỗi lớp là nhầm thành 1. Trừ 3 mỗi lớp là nhầm thành . Ra 38 là cộng thêm padding mà quên rằng kernel lấy lại đúng phần ấy.
Câu 2
Ảnh , kernel , không padding, stride 1 cho đầu ra . Giữ nguyên kernel, cấu hình nào cho đầu ra đúng ?
. Ảnh sau khi padding dài 8, các cửa sổ bắt đầu ở 0, 2, 4, nên hàng và cột padding cuối cùng không bao giờ được đọc. Stride 1 với padding 1 giữ nguyên , còn lớn hơn trước. Stride 2 không padding cho , giảm quá tay. Stride 3 cũng cho 2.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.2(a)
Câu 3
Trên ảnh , một kênh vào, một kênh ra, stride 1, bỏ qua bias, so hai lớp: conv kernel 3, dilation 2, padding 2, và conv kernel 5, padding 2. Nhận xét nào đúng?
Kernel giãn phủ ô, nên kích thước tính như kernel 5: . Nhưng nó chỉ đọc 9 ô cách quãng trong vùng , nên chỉ có 9 trọng số. là tính như kernel 3 thường với padding 2, quên dilation. 25 trọng số là nhầm vùng phủ với số trọng số.
Câu 4
Model nhận batch (8, 3, 32, 32):
nn.Sequential(
    nn.Conv2d(3, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
    nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
    nn.Flatten(), nn.Linear(IN, 10))
IN phải bằng bao nhiêu?
Conv với padding=1 giữ nguyên kích thước, còn mỗi MaxPool2d(2) chia đôi: , và số kênh cuối là 32. 32 768 là quên rằng pooling làm giảm kích thước không gian. 8192 là chỉ tính một lần pooling. 512 là chia đôi thêm một lần nữa, như thể một lớp conv cũng làm giảm kích thước. Sai IN sẽ hiện thành lỗi nhân ma trận ngay ở batch đầu tiên; chạy một batch giả và in shape trước Linear là thấy ngay.
Phỏng theoNOAI 2025 Singapore · Phần 1 · Câu 11
Câu 5
Một conv 1D có một bộ lọc, và lớn nghĩa là có mẫu cần tìm ở vị trí . Mạng A cho ra , mạng B cho ra . Đầu ra cao nghĩa là “mẫu có ở mọi vị trí” ở mạng nào, và nghĩa là “mẫu có ở ít nhất một vị trí” ở mạng nào?
Min cao chỉ khi mọi đều cao, tức mẫu có ở mọi vị trí. Max cao thì chỉ cần một cao. Dễ gán A cho “mọi vị trí” vì max đọc qua toàn bộ ảnh, nhưng đọc qua toàn bộ không có nghĩa là đòi hỏi toàn bộ. Muốn đo “có ở ít nhất một nửa số vị trí” thì cả hai đều không đo được; phải dùng một phép gộp khác, chẳng hạn tỉ lệ các vượt ngưỡng.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q8
Câu 6
Hai lớp conv , stride 1, không padding. Xét ô của lớp thứ hai, với chỉ số tính từ 0. Nhận xét nào đúng?
Ô của lớp hai đọc các ô ở hàng 0 tới 2, cột 0 tới 2 của lớp một. Mỗi ô ấy lại nhìn thêm hai hàng, hai cột, nên vùng nhìn là hàng 0 tới 4, cột 0 tới 4. Khối chỉ là vùng nhìn của một lớp. là đếm ô, quên rằng các cửa sổ chồng lên nhau. Convolution nối cục bộ, khác với lớp Linear. Chữ “có thể” là cần thiết, vì trọng số bằng 0 hay ReLU tắt có thể khiến ảnh hưởng thực tế bằng 0.
Câu 7
Một đội thay một conv , 64 kênh vào, 64 kênh ra, bằng ba conv từ 64 sang 64 nối tiếp, stride 1, có ReLU ở giữa. So với lớp cũ, bỏ qua bias, điều nào đúng?
Ba lớp cho . Về trọng số, so với , chỉ khoảng 55%, lại còn có thêm hai ReLU. là vùng nhìn của một lớp. là nhân thay vì cộng. “Nhiều hơn” là đếm ba lớp mà quên rằng mỗi lớp nhỏ hơn hẳn.
Câu 8
Đưa một ảnh qua một CNN pretrained, lấy feature map ở năm lớp có độ sâu khác nhau, rồi xáo thứ tự. Dấu hiệu nào giúp xếp lại theo độ sâu đáng tin nhất?
Lớp nông có vùng nhìn nhỏ, chưa qua nhiều stride hay pooling, nên map còn lớn và phản ứng với các cạnh, trông như ảnh đã qua bộ lọc. Lớp sâu có vùng nhìn rộng, map nhỏ và thô, khó nhận ra vật. Độ lớn của giá trị phụ thuộc chuẩn hóa và activation, không tăng đều theo độ sâu. “Học nhiều hơn nên nét hơn” là đảo ngược chiều: chi tiết không gian giảm dần qua các lớp. Map nào cũng được tính từ ảnh, nên vẫn mang thông tin của ảnh.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Problem 6
Câu 9
Mọi ảnh xe đều chụp ngang, cùng cỡ, đầu xe luôn quay sang phải, nên bánh xe, cửa kính, đèn luôn ở gần cùng một chỗ. Bỏ qua chi phí tính toán, dùng chung một bộ kernel cho mọi vị trí có còn là lựa chọn rõ ràng nhất không?
Convolution giả định cùng một mẫu có thể xuất hiện ở bất cứ đâu. Khi vị trí đã cố định, mỗi vùng luôn chứa cùng một loại chi tiết, nên bộ lọc riêng cho vùng bánh xe, vùng cửa kính, tức một lớp nối cục bộ không dùng chung, có thể hợp hơn. Đổi lại là nhiều tham số hơn và cần nhiều dữ liệu hơn. Không dùng chung vẫn học được, như MLP vẫn học. Dùng chung trọng số không tạo ra bất biến với phép xoay, và pooling chỉ làm bớt nhạy với những phép dịch nhỏ.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.4(b)
Câu 10
Mỗi mẫu là một tensor (64, 64, 2): vector lực đo trên lưới . Phải dự đoán tọa độ nguồn cùng 100 giá trị cường độ. Một đội dùng các conv stride 1, rồi global average pooling, rồi Linear ra 102 số, và lỗi tọa độ rất cao. Thay đổi nào nhắm đúng nguyên nhân?
Conv stride 1 dịch theo đầu vào: nguồn dịch chỗ thì feature map dịch theo, còn trung bình toàn cục gần như không đổi, nên head khó đọc ra tọa độ. Flatten feature map, hoặc dự đoán một heatmap, thì giữ lại được vị trí. Thêm hai kênh tọa độ , vào input cũng là một cách. Global max cũng gộp mất vị trí. Gấp đôi số kênh hay thêm padding không đưa được vị trí trở lại sau phép gộp.
Đọc thêm
- Dive into Deep Learning — Convolutions for Images: phân biệt cross-correlation với convolution, và xem một kernel phát hiện cạnh được học lại từ dữ liệu.
- PyTorch — Conv2d: đối chiếu shape,
groups,padding="same"và công thức kích thước khi cấu trúc khác ví dụ. - Dumoulin và Visin — A guide to convolution arithmetic for deep learning: hình vẽ từng trường hợp padding, stride, dilation và kích thước đầu ra tương ứng.
- Dive into Deep Learning — Pooling: xem các phép tổng hợp và vai trò giảm kích thước, rồi tự thử một ảnh có nét mảnh.
Nguồn ảnh: ảnh tháp là ảnh mẫu china.jpg kèm scikit-learn (danielbuechele, Flickr, CC BY 2.0).